第 16 章 贝叶斯后验计算
第 15 章讨论了如何用先验、似然和后验表达统计推断。在 Beta–二项分布、正态–正态分布等共轭模型中,后验分布可以直接写出;但这种便利并不是一般规律。稍微改变先验、似然或模型层次,归一化常数、后验均值和后验概率就可能没有闭式表达式。此时,贝叶斯推断首先是一个计算问题。
本章不急于进入 MCMC,而是研究几种看得见计算过程的方法:数值积分、网格近似、MAP、Laplace近似和重要性抽样。它们适合一维或低维模型,也为理解后面更复杂的算法提供参照。贯穿本章的核心问题不是“调用哪个函数”,而是:计算对象是什么,近似误差从哪里产生,又怎样判断结果是否可信。
为了把注意力集中在计算上,本章固定使用同一个 Poisson–对数正态模型,并让各种方法回答相同的后验均值、区间概率和预测问题。网格与自适应积分在低维情形下充当数值基准,MAP 用来定位后验,Laplace 近似和重要性抽样再与基准比较。这样安排不表示模型设定已经无须检查;先验解释与预测检查沿用上一章建立的原则,本章只追踪从未归一化后验到可报告结果的计算链条。
16.1 学习目标
学完本章后,读者应当能够:
- 把后验均值、概率、分位数和预测写成积分;
- 在对数尺度上稳定地计算未归一化后验和权重;
- 用求积权重构造一维网格近似,并检查范围与精度;
- 计算 MAP 和局部曲率,理解 MAP 对参数化的依赖;
- 从二阶 Taylor 展开推导 Laplace 近似,并识别其适用条件;
- 实施自归一化重要性抽样,诊断权重退化;
- 把网格质量或带权样本传播到后验预测分布;
- 区分确定性近似误差、优化误差和 Monte Carlo 误差。
16.2 后验计算究竟在算什么
16.2.1 归一化常数与后验泛函
给定完整观测数据 \(\mathbf y\) 和参数向量 \(\boldsymbol\theta\),贝叶斯公式为
\[ p(\boldsymbol\theta\mid\mathbf y) = \frac{p(\mathbf y\mid\boldsymbol\theta)p(\boldsymbol\theta)}{p(\mathbf y)}, \qquad p(\mathbf y)=\int p(\mathbf y\mid\boldsymbol\theta) p(\boldsymbol\theta)\,d\boldsymbol\theta. \]
分子是似然与先验的乘积,分母 \(p(\mathbf y)\) 是边际似然。若只比较不同参数值的相对后验密度,可写成
\[ \widetilde p(\boldsymbol\theta\mid\mathbf y) =p(\mathbf y\mid\boldsymbol\theta)p(\boldsymbol\theta), \qquad p(\boldsymbol\theta\mid\mathbf y) \propto\widetilde p(\boldsymbol\theta\mid\mathbf y). \]
“忽略归一化常数”不等于它不存在。计算后验期望时,它仍然以两个积分之比出现:
\[ \operatorname{E}\{h(\boldsymbol\theta)\mid\mathbf y\} = \frac{\int h(\boldsymbol\theta) \widetilde p(\boldsymbol\theta\mid\mathbf y)\,d\boldsymbol\theta} {\int \widetilde p(\boldsymbol\theta\mid\mathbf y)\,d\boldsymbol\theta}. \]
选择不同的 \(h\),便得到不同的后验摘要。例如,\(h(\boldsymbol\theta)=\boldsymbol\theta\) 给出后验均值向量,\(h(\boldsymbol\theta)=\mathbb I\{\theta_j>c\}\) 给出第 \(j\) 个参数超过阈值的后验概率。后验分位数和预测分布虽然不总能写成同一个期望,仍然都依赖对后验分布的积分。因此,后验计算的中心任务是积分。寻找高密度区域只是为积分定位,不能代替积分;一个后验众数也不能回答区间概率或预测问题。网格与数值求积直接近似积分,Laplace 方法用局部正态分布近似整个后验,重要性抽样则把同一积分改写为关于建议分布的期望。把这些方法放在同一个表达式下比较,才能看清每种方法近似的是哪一步,以及误差应当在哪里检查。
16.2.2 对数尺度与稳定归一化
独立观测的似然是许多小数的乘积,直接计算很容易下溢。实际程序通常先计算完整对数联合密度
\[ \log p(\mathbf y,\boldsymbol\theta) =\log p(\mathbf y\mid\boldsymbol\theta)+\log p(\boldsymbol\theta), \]
或者与它相差一个常数的对数核。若 \(a_1,\ldots,a_K\) 是对数权重,则
\[ \log\left(\sum_{k=1}^K e^{a_k}\right) =a_{\max}+\log\left\{\sum_{k=1}^K e^{a_k-a_{\max}}\right\}, \]
其中 \(a_{\max}=\max_k a_k\)。减去最大值不会改变归一化后的相对权重,却能显著提高稳定性。
log_sum_exp <- function(logx) {
  stopifnot(length(logx) > 0L, !anyNA(logx),
            !any(logx == Inf), any(is.finite(logx)))
  m <- max(logx)
  m + log(sum(exp(logx - m)))
}

normalize_log_weights <- function(logw) {
  stopifnot(length(logw) > 0L, !anyNA(logw),
            !any(logw == Inf), any(is.finite(logw)))
  exp(logw - log_sum_exp(logw))
}

weighted_quantile <- function(x, w, probs) {
  stopifnot(length(x) == length(w), all(w >= 0), sum(w) > 0,
            all(probs >= 0 & probs <= 1))
  ord <- order(x)
  x <- x[ord]
  w <- w[ord] / sum(w)
  cw <- cumsum(w)
  vapply(probs, function(p) x[which(cw >= p)[1L]], numeric(1))
}

trapezoid_weights <- function(x) {
  stopifnot(length(x) >= 2L, all(diff(x) > 0))
  k <- length(x)
  dx <- diff(x)
  w <- numeric(k)
  w[1L] <- dx[1L] / 2
  w[k] <- dx[k - 1L] / 2
  if (k > 2L) {
    w[2L:(k - 1L)] <- (dx[1L:(k - 2L)] + dx[2L:(k - 1L)]) / 2
  }
  w
}
这些辅助函数会在本章反复使用。真实项目中还应检查缺失值、无穷值以及所有权重同时下溢等异常,而不能把数值警告当作无关信息略过。
16.3 贯穿案例:Poisson–对数正态模型
设 \(Y_i\) 表示第 \(i\) 个月收到的随机订单数,相应观测值记为 \(y_i\),整组观测记为\(\mathbf y=(y_1,\ldots,y_n)^\top\),并假定
\[ Y_i\mid\lambda\overset{\mathrm{iid}}{\sim}\operatorname{Poisson}(\lambda), \qquad i=1,\ldots,n. \]
参数 \(\lambda>0\)。为避免在优化和抽样时处理正数边界,令
\[ \eta=\log\lambda, \qquad \eta\sim N(m_0,\tau_0^2). \]
这是在 \(\eta\) 上直接规定先验;等价地,\(\lambda\) 服从对数正态先验。若改用 Gamma 先验,Poisson模型具有共轭后验。本章选择对数正态先验,是为了有意打破共轭性,同时保持后验一维、单峰且容易核对,使各种数值方法面对同一个非闭式后验;它不是关于订单率先验的通用建议。实际分析仍应根据订单量的尺度和历史信息检查先验预测。下面模拟 60 个月的数据,并把计算所需的对数联合密度、梯度和 Hessian 明确写出。
set.seed(2026)
y <- rpois(60, lambda = 3.5)
n <- length(y)
y_sum <- sum(y)
m0 <- 1
tau0 <- 1

log_lik_eta <- function(eta) {
  y_sum * eta - n * exp(eta) - sum(lgamma(y + 1))
}

log_prior_eta <- function(eta) {
  dnorm(eta, mean = m0, sd = tau0, log = TRUE)
}

log_joint_eta <- function(eta) {
  log_lik_eta(eta) + log_prior_eta(eta)
}

score_eta <- function(eta) {
  y_sum - n * exp(eta) - (eta - m0) / tau0^2
}

hessian_eta <- function(eta) {
  -n * exp(eta) - 1 / tau0^2
}
因为对数似然可由 \(n\) 和 \(y_+=\sum_{i=1}^n y_i\) 表示,所以以上函数可以对一组 eta 同时计算。完整对数联合密度保留了 Poisson 似然和正态先验中的常数;寻找 MAP 时这些常数可以忽略,估计边际似然时却不能忽略。
本例的二阶导数在所有 \(\eta\) 上都小于零,所以对数后验严格凹,只有一个众数。这一性质使它很适合用来比较方法,但不应由此误以为一般后验总是单峰的。
16.4 一维网格与数值积分
16.4.1 从密度值到区间概率
网格法在候选点 \(\eta_1<\cdots<\eta_K\) 上计算后验,再用有限个点近似积分。这里有一个容易忽略的区别:\(p(\eta_k\mid\mathbf y)\) 是点上的密度值,不是点 \(\eta_k\) 的概率。连续分布在任意单点上的概率都为零。
若第 \(k\) 个网格点代表宽度为 \(\Delta_k\) 的小区间,则该区间的近似后验质量为
\[ \pi_k \propto \widetilde p(\eta_k\mid\mathbf y)\Delta_k. \]
等距网格的 \(\Delta_k\) 相同,归一化时会抵消;非等距网格则必须保留求积权重。下面采用梯形求积的区间权重,这样同一段程序既适用于等距网格,也适用于非等距网格。
eta_grid <- seq(-0.5, 2.5, length.out = 2001)
quad_w <- trapezoid_weights(eta_grid)
log_joint_grid <- log_joint_eta(eta_grid)

log_mass <- log_joint_grid + log(quad_w)
post_mass <- normalize_log_weights(log_mass)
log_evidence_grid <- log_sum_exp(log_mass)

lambda_grid <- exp(eta_grid)
eta_mean_grid <- sum(post_mass * eta_grid)
eta_sd_grid <- sqrt(sum(post_mass * (eta_grid - eta_mean_grid)^2))
lambda_mean_grid <- sum(post_mass * lambda_grid)
lambda_q_grid <- weighted_quantile(
  lambda_grid, post_mass, c(0.025, 0.5, 0.975)
)
prob_gt4_grid <- sum(post_mass[lambda_grid > 4])

grid_summary <- data.frame(
  quantity = c("eta 的后验均值", "eta 的后验标准差",
               "lambda 的后验均值", "lambda 的 2.5% 分位数",
               "lambda 的中位数", "lambda 的 97.5% 分位数",
               "lambda 大于 4 的后验概率", "数据的对数边际似然"),
  value = c(eta_mean_grid, eta_sd_grid, lambda_mean_grid,
            lambda_q_grid, prob_gt4_grid, log_evidence_grid)
)

knitr::kable(
  grid_summary,
  row.names = FALSE,
  digits = 4,
  col.names = c("后验量", "网格近似")
)| 后验量 | 网格近似 |
|---|---|
| eta 的后验均值 | 1.1227 |
| eta 的后验标准差 | 0.0734 |
| lambda 的后验均值 | 3.0813 |
| lambda 的 2.5% 分位数 | 2.6538 |
| lambda 的中位数 | 3.0741 |
| lambda 的 97.5% 分位数 | 3.5396 |
| lambda 大于 4 的后验概率 | 0.0001 |
| 数据的对数边际似然 | -123.4988 |
post_mass 的元素之和为 1,适合计算均值、分位数和概率。若要画规范化后的后验密度,则应计算exp(log_joint_grid - log_evidence_grid)。密度与质量用途不同,不应混用。
16.4.2 用范围与加密检查网格
一张平滑的后验曲线并不能证明计算正确。至少需要检查两个方面:
- 范围检查:网格两端的对数联合密度应明显低于峰值,说明主要后验质量没有被截断;
- 加密检查:扩大范围、减小步长后,关心的后验摘要应基本不变。
下面把三组网格与 integrate() 的自适应求积结果比较。为避免指数运算下溢,自适应积分也先减去后验峰值附近的对数联合密度。
mode_for_scale <- optimize(
  function(e) -log_joint_eta(e), interval = c(-2, 4)
)$minimum
log_joint_mode <- log_joint_eta(mode_for_scale)

z_scaled <- integrate(
  function(e) exp(log_joint_eta(e) - log_joint_mode),
  lower = -Inf, upper = Inf, rel.tol = 1e-11
)$value

mean_lambda_ref <- integrate(
  function(e) exp(e + log_joint_eta(e) - log_joint_mode),
  lower = -Inf, upper = Inf, rel.tol = 1e-11
)$value / z_scaled

grid_specs <- data.frame(
  lower = c(1.05, -0.5, -1.5),
  upper = c(1.20, 2.5, 3.5),
  points = c(101, 2001, 5001)
)

grid_check <- do.call(rbind, lapply(seq_len(nrow(grid_specs)), function(i) {
  g <- seq(grid_specs$lower[i], grid_specs$upper[i],
           length.out = grid_specs$points[i])
  qw <- trapezoid_weights(g)
  mass <- normalize_log_weights(log_joint_eta(g) + log(qw))
  end_gap <- max(log_joint_eta(g[c(1L, length(g))])) -
    max(log_joint_eta(g))
  data.frame(
    lower = grid_specs$lower[i],
    upper = grid_specs$upper[i],
    points = grid_specs$points[i],
    endpoint_log_gap = end_gap,
    lambda_mean = sum(mass * exp(g)),
    abs_error = abs(sum(mass * exp(g)) - mean_lambda_ref)
  )
}))

knitr::kable(
  grid_check,
  row.names = FALSE,
  digits = 6,
  col.names = c(
    "下界", "上界", "网格点数", "端点对数密度差",
    "$\\operatorname{E}(\\lambda\\mid\\mathbf y)$", "绝对误差"
  ),
  escape = FALSE
)| 下界 | 上界 | 网格点数 | 端点对数密度差 | \(\operatorname{E}(\lambda\mid\mathbf y)\) | 绝对误差 |
|---|---|---|---|---|---|
| 1.05 | 1.2 | 101 | -0.5145 | 3.083 | 0.001256 |
| -0.50 | 2.5 | 2001 | -153.3210 | 3.081 | 0.000000 |
| -1.50 | 3.5 | 5001 | -317.3170 | 3.081 | 0.000000 |
endpoint_log_gap 越负,端点密度相对于峰值越小。它不是通用的合格阈值,但能暴露范围明显过窄的网格。最终判断应针对实际关心的量:均值稳定并不保证尾部概率也稳定,因此报告极端概率时要专门检查尾部。
网格法的局限来自维数。每个方向取 \(K\) 个点,\(d\) 维规则网格需要 \(K^d\) 个点;即使每维只有100 个点,五维也已有 \(10^{10}\) 个组合。这就是所谓维数灾难。
16.4.3 参数变换与 Jacobian
本例的先验直接定义在 \(\eta\) 上,所以 log_joint_eta() 中不需要额外的 Jacobian。若先在\(\lambda\) 上指定密度 \(p_\lambda(\lambda)\),再令 \(\eta=\log\lambda\),则变换后的密度是
\[ p_\eta(\eta) =p_\lambda(e^\eta)\left\lvert\frac{d e^\eta}{d\eta}\right\rvert =p_\lambda(e^\eta)e^\eta. \]
因此对数密度中必须加上 \(\eta\)。反过来,由 \(\eta\) 尺度的后验得到 \(\lambda\) 尺度的后验密度时,
\[ p_\lambda(\lambda\mid\mathbf y) =\frac{p_\eta(\log\lambda\mid\mathbf y)}{\lambda}. \]
遗漏 Jacobian 会改变目标分布,而不只是带来一点数值误差。一个实用原则是:先写清密度相对于哪个变量定义,再进行变换。
Jacobian 用于把一个变量上的密度改写成另一个变量上的密度。若已经拥有 \(\eta\) 的后验样本或网格区间质量,只需逐个计算 \(\lambda=e^\eta\);这些样本或概率质量本身不再乘 Jacobian。把“改写密度”与“变换已经生成的随机变量”混在一起,是重复校正的常见来源。
16.5 MAP:后验计算中的优化问题
16.5.1 从后验核到优化目标
后验众数或 MAP 定义为
\[ \widehat{\boldsymbol\theta}_{\mathrm{MAP}} =\arg\max_{\boldsymbol\theta}p(\boldsymbol\theta\mid\mathbf y). \]
归一化常数不依赖参数,所以 MAP 可通过最小化负对数联合密度得到。本例有解析梯度和 Hessian,可以同时用来优化和验算。
starts <- c(-1, log(mean(y)), 3)
map_fits <- lapply(starts, function(start) {
  optim(
    par = start,
    fn = function(e) -log_joint_eta(e),
    gr = function(e) -score_eta(e),
    method = "BFGS",
    hessian = TRUE,
    control = list(reltol = 1e-12)
  )
})

map_check <- data.frame(
  start = starts,
  eta_hat = vapply(map_fits, function(fit) fit$par, numeric(1)),
  objective = vapply(map_fits, function(fit) fit$value, numeric(1)),
  abs_gradient = vapply(
    map_fits, function(fit) abs(score_eta(fit$par)), numeric(1)
  ),
  convergence = vapply(map_fits, function(fit) fit$convergence, integer(1))
)

fit_map <- map_fits[[2L]]
eta_map <- as.numeric(fit_map$par)
curvature <- -hessian_eta(eta_map)

knitr::kable(
  map_check,
  row.names = FALSE,
  digits = 7,
  col.names = c(
    "初值", "$\\hat\\eta_{\\mathrm{MAP}}$", "负对数联合密度",
    "梯度绝对值", "收敛码"
  ),
  escape = FALSE
)| 初值 | \(\hat\eta_{\mathrm{MAP}}\) | 负对数联合密度 | 梯度绝对值 | 收敛码 |
|---|---|---|---|---|
| -1.000 | 1.125 | 121.8 | 0.00e+00 | 0 |
| 1.126 | 1.125 | 121.8 | 1.00e-07 | 0 |
| 3.000 | 1.125 | 121.8 | 2.88e-05 | 0 |
convergence = 0 只是第一项检查。还应确认不同初值到达相同解、梯度接近零、目标值一致,并检查负 Hessian 在解处为正。复杂模型还可能存在多个局部众数、平坦方向或边界解,单次优化无法排除这些问题。
16.5.2 MAP 依赖参数化
均值和概率在正确变量变换后描述的是同一个后验分布,但“密度最高的位置”会随坐标改变。\(\eta\)尺度的 MAP 变换为 \(e^{\hat\eta_{\mathrm{MAP}}}\);\(\lambda\) 尺度的 MAP 则最大化
\[ \log p_\lambda(\lambda\mid\mathbf y) =\log p_\eta(\log\lambda\mid\mathbf y)-\log\lambda. \]
lambda_from_eta_map <- exp(eta_map)

eta_at_lambda_map <- optimize(
  function(e) -(log_joint_eta(e) - e),
  interval = c(-2, 4)
)$minimum
lambda_scale_map <- exp(eta_at_lambda_map)

map_parameterization <- data.frame(
  reported_quantity = c(
    "eta 尺度 MAP 的指数变换",
    "lambda 尺度上定义的 MAP"
  ),
  value = c(lambda_from_eta_map, lambda_scale_map)
)

knitr::kable(
  map_parameterization,
  row.names = FALSE,
  digits = 5,
  col.names = c("众数的定义方式", "数值")
)| 众数的定义方式 | 数值 |
|---|---|
| eta 尺度 MAP 的指数变换 | 3.081 |
| lambda 尺度上定义的 MAP | 3.065 |
两者不同不是程序错误,而是连续密度众数缺乏参数变换不变性的结果。因此,报告 MAP 时必须说明参数尺度。MAP 也只是一个点,不能替代后验区间或后验概率。
16.6 Laplace 后验近似
16.6.1 由局部曲率得到正态近似
设 \(\boldsymbol\theta\) 是 \(d\) 维参数向量,且\(\ell(\boldsymbol\theta)=\log p(\boldsymbol\theta\mid\mathbf y)\),在 MAP 附近作二阶 Taylor 展开:
\[ \ell(\boldsymbol\theta) \approx \ell(\widehat{\boldsymbol\theta}_{\mathrm{MAP}}) -\frac{1}{2}(\boldsymbol\theta-\widehat{\boldsymbol\theta}_{\mathrm{MAP}})^\top \mathbf H(\boldsymbol\theta-\widehat{\boldsymbol\theta}_{\mathrm{MAP}}), \]
其中
\[ \mathbf H=-\nabla^2\ell(\widehat{\boldsymbol\theta}_{\mathrm{MAP}}). \]
指数化后得到正态近似
\[ \boldsymbol\theta\mid\mathbf y\ \dot\sim\ N_d\left(\widehat{\boldsymbol\theta}_{\mathrm{MAP}},\mathbf H^{-1}\right). \]
点号表示这是近似关系。在一维 Poisson 例子中,
\[ H_\eta=n\exp(\hat\eta_{\mathrm{MAP}})+\frac{1}{\tau_0^2}, \qquad V_\eta=H_\eta^{-1}. \]
var_eta_laplace <- 1 / curvature
sd_eta_laplace <- sqrt(var_eta_laplace)

laplace_lambda_mean <- exp(eta_map + var_eta_laplace / 2)
laplace_lambda_q <- exp(
  qnorm(c(0.025, 0.5, 0.975), mean = eta_map, sd = sd_eta_laplace)
)
laplace_prob_gt4 <- pnorm(
  log(4), mean = eta_map, sd = sd_eta_laplace, lower.tail = FALSE
)

laplace_compare <- data.frame(
  quantity = c(
    "lambda 的后验均值", "lambda 的 2.5% 分位数",
    "lambda 的中位数", "lambda 的 97.5% 分位数",
    "lambda 大于 4 的后验概率"
  ),
  grid = c(lambda_mean_grid, lambda_q_grid, prob_gt4_grid),
  Laplace = c(laplace_lambda_mean, laplace_lambda_q,
              laplace_prob_gt4)
)
laplace_compare$absolute_difference <- abs(
  laplace_compare$Laplace - laplace_compare$grid
)

knitr::kable(
  laplace_compare,
  row.names = FALSE,
  digits = 6,
  col.names = c(
    "后验量", "网格基准", "Laplace 近似", "绝对差"
  )
)| 后验量 | 网格基准 | Laplace 近似 | 绝对差 |
|---|---|---|---|
| lambda 的后验均值 | 3.081289 | 3.089544 | 0.008255 |
| lambda 的 2.5% 分位数 | 2.653820 | 2.668652 | 0.014833 |
| lambda 的中位数 | 3.074063 | 3.081244 | 0.007182 |
| lambda 的 97.5% 分位数 | 3.539551 | 3.557626 | 0.018075 |
| lambda 大于 4 的后验概率 | 0.000091 | 0.000187 | 0.000096 |
两种方法的差异也可以直接从密度形状观察。Laplace 曲线在众数附近贴合较好,但右尾的细小差异会被尾部概率放大。
post_density_grid <- exp(log_joint_grid - log_evidence_grid)
laplace_density_grid <- dnorm(
  eta_grid, mean = eta_map, sd = sd_eta_laplace
)

plot(
  eta_grid, post_density_grid, type = "l", lwd = 2,
  xlim = eta_map + c(-4, 4) * sd_eta_laplace,
  xlab = expression(eta), ylab = "密度"
)
lines(eta_grid, laplace_density_grid, lwd = 2, lty = 2)
legend(
  "topright", legend = c("网格后验", "Laplace"),
  lty = c(1, 2), lwd = 2, bty = "n"
)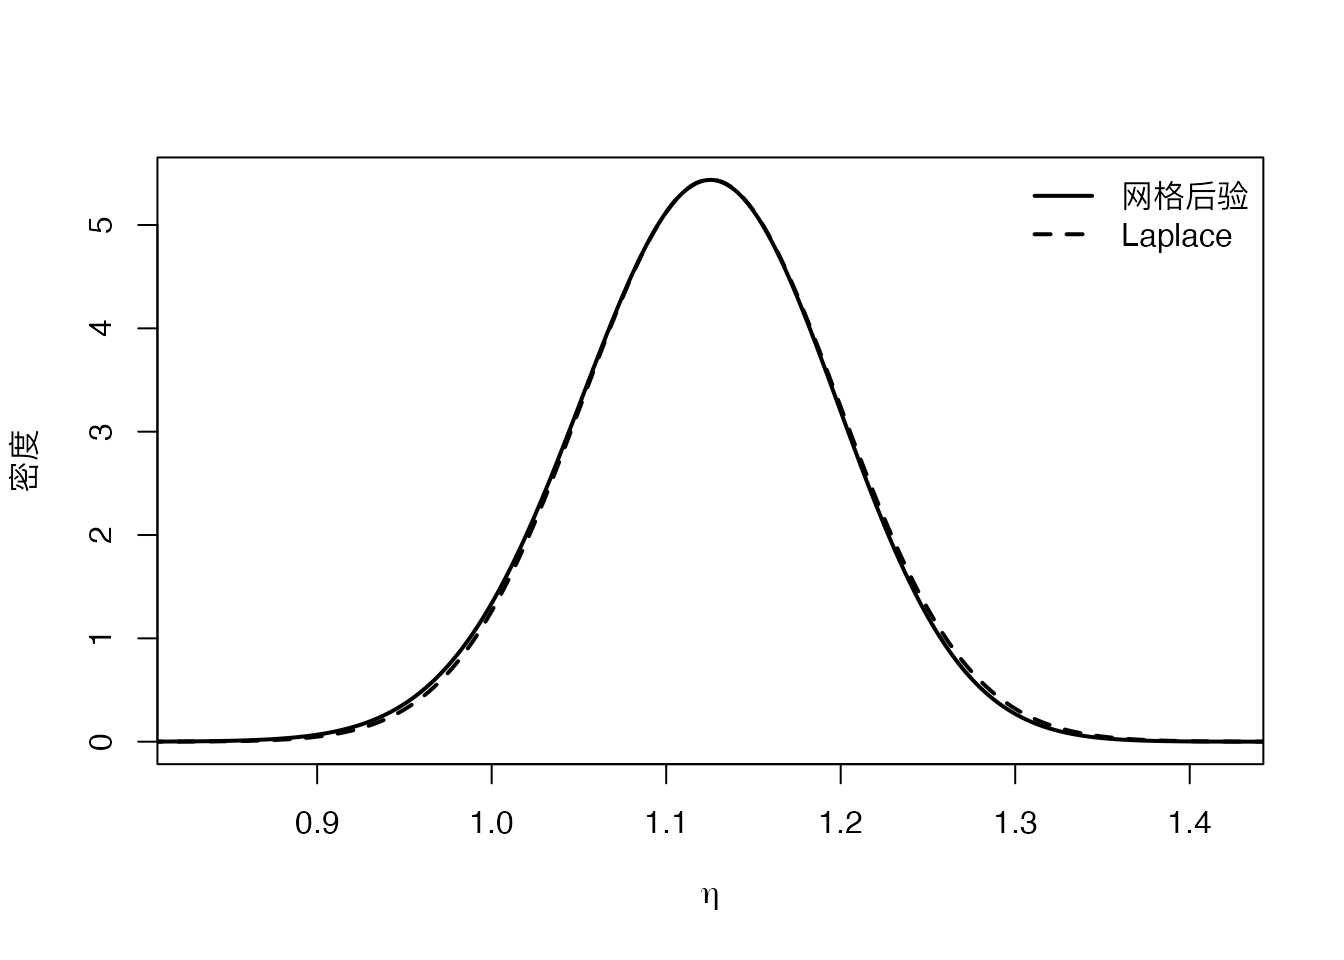
图16.1: 网格后验密度与 Laplace 近似(eta 尺度)
在 \(\eta\) 尺度上使用正态近似,意味着 \(\lambda=e^\eta\) 近似服从对数正态分布。因此均值、分位数和超过阈值的概率都可以直接计算,不必先生成随机数。这样可把 Laplace 近似本身的误差与额外的模拟误差分开。
16.6.2 局部近似的适用范围
Laplace 方法只利用众数附近的局部曲率。它通常在后验单峰、样本信息充分、局部形状接近二次函数时表现良好;在小样本、强偏斜、多峰、厚尾或靠近参数边界时可能失真。低维问题中,应尽量与可靠的网格或自适应积分比较。在多维问题中,应检查 \(\mathbf H\) 是否正定;数值实现宜用 Cholesky 分解求解线性系统,而不是显式计算矩阵逆。
Laplace 近似还可用于近似边际似然。若参数维数为 \(d\),则
\[ \log p(\mathbf y) \approx \log p(\mathbf y,\widehat{\boldsymbol\theta}_{\mathrm{MAP}}) +\frac{d}{2}\log(2\pi) -\frac{1}{2}\log\det(\mathbf H). \]
这个公式要求使用含全部常数的\(\log p(\mathbf y,\boldsymbol\theta)\)。只保留与参数有关的核函数,会得到错误的边际似然。第 19 章将进一步说明边际似然在模型比较中的作用。
16.7 重要性抽样
16.7.1 用建议分布改写后验积分
Laplace 近似用一个正态分布替代后验;重要性抽样则把容易抽样的建议分布\(q(\boldsymbol\theta)\) 当作计算工具,再用权重校正两者的差异。若
\[ \boldsymbol\theta^{(1)},\ldots,\boldsymbol\theta^{(S)} \overset{\mathrm{iid}}{\sim}q(\boldsymbol\theta), \]
未归一化权重为
\[ w_s=\frac{p(\mathbf y,\boldsymbol\theta^{(s)})} {q(\boldsymbol\theta^{(s)})}. \]
要使这种改写成立,只要 \(p(\mathbf y,\boldsymbol\theta)\) 不为零,建议密度\(q(\boldsymbol\theta)\) 就不能为零。这个支持集条件只保证估计量有机会看到目标区域;若要稳定估计后验均值,还需要相应权重矩存在。记\(\mu_h=\operatorname{E}\{h(\boldsymbol\theta)\mid\mathbf y\}\),自归一化重要性估计满足常用中心极限定理的条件之一是
\[ \int \frac{p(\mathbf y,\boldsymbol\theta)^2 \{h(\boldsymbol\theta)-\mu_h\}^2} {q(\boldsymbol\theta)}\,d\boldsymbol\theta<\infty. \]
因此,建议分布“中心接近后验”还不够,其尾部通常也不应比目标分布更轻。
当边际似然未知时,采用自归一化权重
\[ \bar w_s=\frac{w_s}{\sum_{r=1}^S w_r}, \]
于是
\[ \operatorname{E}\{h(\boldsymbol\theta)\mid\mathbf y\} \approx \sum_{s=1}^S\bar w_s h(\boldsymbol\theta^{(s)}). \]
以下把右侧的自归一化重要性估计记为 \(\hat\mu_h\)。
建议分布必须覆盖目标后验的重要区域,特别是所研究泛函 \(h(\boldsymbol\theta)\) 贡献较大的尾部。下面以 Laplace结果为中心构造三个建议分布:一个较稳健,一个过窄,一个中心偏移。所有权重都在对数尺度上计算。
importance_run <- function(proposal_mean, proposal_sd, S, seed) {
  set.seed(seed)
  eta <- rnorm(S, mean = proposal_mean, sd = proposal_sd)
  log_q <- dnorm(
    eta, mean = proposal_mean, sd = proposal_sd, log = TRUE
  )
  log_w <- log_joint_eta(eta) - log_q
  w <- normalize_log_weights(log_w)
  lambda <- exp(eta)

  estimate <- sum(w * lambda)
  mcse_heuristic <- sqrt(sum(w^2 * (lambda - estimate)^2))
  log_evidence <- log_sum_exp(log_w) - log(S)

  list(
    eta = eta,
    lambda = lambda,
    w = w,
    summary = data.frame(
      lambda_mean = estimate,
      P_lambda_gt4 = sum(w[lambda > 4]),
      ESS = 1 / sum(w^2),
      ESS_fraction = 1 / (S * sum(w^2)),
      max_weight = max(w),
      mcse_heuristic = mcse_heuristic,
      log_evidence = log_evidence
    )
  )
}

S_is <- 20000
is_good <- importance_run(eta_map, 1.5 * sd_eta_laplace, S_is, 1701)
is_narrow <- importance_run(eta_map, 0.45 * sd_eta_laplace, S_is, 1702)
is_shifted <- importance_run(
  eta_map + 2.5 * sd_eta_laplace,
  1.5 * sd_eta_laplace, S_is, 1703
)

is_diagnostics <- rbind(
  data.frame(proposal = "中心匹配、尺度较宽", is_good$summary),
  data.frame(proposal = "尺度过窄", is_narrow$summary),
  data.frame(proposal = "中心偏移", is_shifted$summary)
)

knitr::kable(
  is_diagnostics,
  row.names = FALSE,
  digits = 5,
  col.names = c(
    "建议分布", "$\\operatorname{E}(\\lambda\\mid\\mathbf y)$", "$P(\\lambda>4\\mid\\mathbf y)$",
    "权重 ESS", "ESS 比例", "最大权重", "均值 MCSE",
    "$\\log \\widehat{p(\\mathbf y)}$"
  ),
  escape = FALSE
)| 建议分布 | \(\operatorname{E}(\lambda\mid\mathbf y)\) | \(P(\lambda>4\mid\mathbf y)\) | 权重 ESS | ESS 比例 | 最大权重 | 均值 MCSE | \(\log \widehat{p(\mathbf y)}\) |
|---|---|---|---|---|---|---|---|
| 中心匹配、尺度较宽 | 3.082 | 1e-04 | 16623 | 0.8312 | 0.00008 | 0.00141 | -123.5 |
| 尺度过窄 | 3.085 | 0e+00 | 1616 | 0.0808 | 0.01211 | 0.00888 | -123.6 |
| 中心偏移 | 3.081 | 9e-05 | 2649 | 0.1325 | 0.00104 | 0.00496 | -123.5 |
16.7.2 从权重分布判断近似质量
表中的 mcse_heuristic 按
\[ \left\{ \sum_{s=1}^S \bar w_s^2 \bigl(h(\boldsymbol\theta^{(s)})-\hat\mu_h\bigr)^2 \right\}^{1/2} \]
估计当前带权均值的 Monte Carlo 标准误。它在权重矩存在且建议分布覆盖充分时才有可信解释;正是在最需要警惕的尾部覆盖失败情形中,这个数也可能显得过于乐观,因此程序有意把它命名为启发式量。
常用的权重有效样本量是
\[ \operatorname{ESS}_{w} =\frac{1}{\sum_{s=1}^S\bar w_s^2}. \]
当权重完全相等时它等于 \(S\);当少数权重占据大部分质量时,它会很小。max_weight 则直接显示单个样本对结果的最大影响。这里的 ESS 是权重集中的描述量,不是第 17 章中针对相关链的ESS,两者不能混为一谈。
ESS 也不是充分诊断。过窄的正态建议分布可能在有限样本中看似正常,却遗漏后验尾部;偶然抽到一个尾部点时,估计又可能突然改变。因此应把三类证据合在一起判断:权重本身是否由少数样本支配,更换随机种子后结果是否稳定,以及改变建议分布的中心和尺度后目标量是否保持一致。最后一项尤其重要,因为有限样本中的高 ESS 只能描述已经抽到的权重,不能证明尚未抽到的尾部无关。所研究的量越依赖尾部,这种检查就越应严格。
重要性抽样的后验分位数可直接从带权样本计算。没有必要先按权重重抽样;重抽样只把带权表示转换成等权表示,会引入重复值和额外随机误差,并不会增加信息。
is_lambda_q <- weighted_quantile(
  is_good$lambda, is_good$w, c(0.025, 0.5, 0.975)
)

is_compare <- data.frame(
  quantity = c(
    "lambda 的后验均值", "lambda 的 2.5% 分位数",
    "lambda 的中位数", "lambda 的 97.5% 分位数",
    "lambda 大于 4 的后验概率"
  ),
  grid = c(lambda_mean_grid, lambda_q_grid, prob_gt4_grid),
  importance_sampling = c(
    sum(is_good$w * is_good$lambda),
    is_lambda_q,
    sum(is_good$w[is_good$lambda > 4])
  )
)

knitr::kable(
  is_compare,
  row.names = FALSE,
  digits = 5,
  col.names = c("后验量", "网格基准", "重要性抽样")
)| 后验量 | 网格基准 | 重要性抽样 |
|---|---|---|
| lambda 的后验均值 | 3.08129 | 3.0824 |
| lambda 的 2.5% 分位数 | 2.65382 | 2.6518 |
| lambda 的中位数 | 3.07406 | 3.0774 |
| lambda 的 97.5% 分位数 | 3.53955 | 3.5399 |
| lambda 大于 4 的后验概率 | 0.00009 | 0.0001 |
如果使用完整联合密度,重要性抽样还给出边际似然估计
\[ \widehat{p(\mathbf y)}=\frac{1}{S}\sum_{s=1}^S w_s. \]
程序中的 log_evidence 用 log-sum-exp 计算这一估计,避免先把很大的原始权重指数化。诊断表同时列出不同建议分布所得结果,读者可把它们与网格法的 log_evidence_grid 比较。边际似然对尾部和异常权重尤其敏感;几个建议分布给出相近后验均值,并不保证它们给出的边际似然同样可靠。
16.8 从后验计算到后验预测
第 15 章已经定义了后验预测分布。这里关注计算上的下一步:一旦后验只能由网格质量、近似分布或带权样本表示,怎样把这种近似继续传播到未来观测。记未来一个月的订单数为\(\widetilde y\),其后验预测分布是 Poisson 分布关于后验的混合:
\[ p(\widetilde y=k\mid\mathbf y) =\int p(\widetilde y=k\mid\lambda)p(\lambda\mid\mathbf y)\,d\lambda. \]
用带权后验样本近似时,
\[ p(\widetilde y=k\mid\mathbf y) \approx \sum_{s=1}^S\bar w_s p(\widetilde y=k\mid\lambda^{(s)}) =\sum_{s=1}^S\bar w_s \frac{e^{-\lambda^{(s)}}(\lambda^{(s)})^k}{k!}. \]
下面直接计算这个混合分布,而不是对每个 \(\lambda^{(s)}\) 再随机生成一个订单数。前者把条件分布解析平均掉,通常具有更小的 Monte Carlo 误差;这类技巧称为 Rao–Blackwell 化。
future_counts <- 0:40
predictive_pmf <- vapply(
  future_counts,
  function(k) sum(is_good$w * dpois(k, lambda = is_good$lambda)),
  numeric(1)
)
captured_predictive_mass <- sum(predictive_pmf)
stopifnot(captured_predictive_mass > 0.999999)
predictive_cdf <- cumsum(predictive_pmf)

predictive_quantile <- function(p) {
  future_counts[which(predictive_cdf >= p)[1L]]
}

predictive_summary <- data.frame(
  quantity = c(
    "新订单数的后验预测均值", "预测分布的 2.5% 分位数",
    "预测分布的中位数", "预测分布的 97.5% 分位数",
    "新订单数不少于 6 的预测概率"
  ),
  value = c(
    sum(is_good$w * is_good$lambda),
    predictive_quantile(0.025),
    predictive_quantile(0.5),
    predictive_quantile(0.975),
    sum(is_good$w * ppois(
      5, lambda = is_good$lambda, lower.tail = FALSE
    ))
  )
)

knitr::kable(
  predictive_summary,
  row.names = FALSE,
  digits = 4,
  col.names = c("后验预测量", "数值")
)| 后验预测量 | 数值 |
|---|---|
| 新订单数的后验预测均值 | 3.0824 |
| 预测分布的 2.5% 分位数 | 0.0000 |
| 预测分布的中位数 | 3.0000 |
| 预测分布的 97.5% 分位数 | 7.0000 |
| 新订单数不少于 6 的预测概率 | 0.0941 |
代码只列出 \(0,\ldots,40\) 的预测概率,因此先检查该范围已经覆盖至少 \(0.999999\) 的总质量。这里没有把截断后的概率重新归一化;否则计算对象会悄悄变成“给定订单数不超过 40”的条件预测分布。
后验均值 \(\operatorname{E}(\lambda\mid\mathbf y)\) 描述平均订单率的不确定性;预测区间描述未来观测的不确定性。后者还包含Poisson 抽样波动,通常比参数的可信区间更宽。把可信区间当成预测区间是常见但实质性的错误。
16.9 计算结果的核查与方法选择
16.9.1 误差必须与算法对应
不同方法产生的误差性质不同,不能只用“增加样本量”来处理所有问题。
| 方法 | 主要误差 | 首要检查 |
|---|---|---|
| 网格/求积 | 截断误差与离散化误差 | 扩大范围、加密网格、比较目标泛函 |
| MAP | 优化误差与局部最优 | 多初值、梯度、目标值、Hessian |
| Laplace | 局部正态近似误差 | 检查曲率和后验形状,与可靠基准比较 |
| 重要性抽样 | Monte Carlo 误差与权重退化 | ESS、最大权重、重复运行、建议分布尾部 |
诊断具有明确的依赖次序。首先核对参数尺度、支持集和完整对数联合密度;这一层若写错,后面的算法可能非常稳定地计算出错误答案。其次检查方法本身:优化要核对梯度和多初值,网格要扩大范围并加密,随机方法则要评估重复运行的波动。最后才检查实际报告的后验泛函。后验均值稳定,并不推出尾部概率、分位数或边际似然也稳定;计算精度必须相对于研究问题来判断。
在一维或二维问题中,网格和自适应积分能够提供难得的数值基准。MAP 可用来定位高密度区,随后再把Laplace 或重要性抽样与这个基准比较。这样的交叉核对不仅服务于当前例子,也能培养进入高维模型后判断算法输出的尺度感。
16.9.2 从低维基准过渡到高维模型
| 方法 | 适用情形 | 主要输出 |
|---|---|---|
| 解析计算 | 共轭或结构简单的模型 | 精确后验摘要 |
| 网格/自适应积分 | 一维或很低维的模型 | 低维后验和积分基准 |
| MAP | 点估计、初始化、寻找高密度区域 | 后验众数与局部曲率 |
| Laplace | 单峰且局部近似正态的后验 | 近似分布和边际似然近似 |
| 重要性抽样 | 能构造覆盖充分的低维建议分布 | 带权后验样本与积分估计 |
| MCMC | 规则网格无法覆盖的复杂高维后验 | 相关后验样本及其诊断 |
这些方法不是彼此排斥的。MAP 可为 Laplace 近似或建议分布提供中心,Laplace 近似可帮助构造重要性抽样的建议分布,低维网格可作为其他算法的检验基准。到了高维模型,规则网格失去可行性,单一建议分布也常难以覆盖后验;下一章将讨论如何用 MCMC 生成相关的后验样本。
16.10 本章小结
后验计算的核心是积分,而不仅是寻找一个最优参数。网格法把连续积分变成带求积权重的有限和;MAP 把寻找后验高密度点转化为优化问题,但其结果依赖参数化;Laplace 方法利用 MAP 附近的二阶曲率构造局部正态近似;重要性抽样从容易抽样的分布生成样本,再用权重恢复目标后验。
计算结果是否可信,取决于相应诊断:网格要检查范围和加密稳定性,MAP 要检查梯度、多初值和曲率,Laplace 要检查局部正态假设,重要性抽样要检查权重集中和尾部覆盖。后验预测则把参数不确定性继续传播到未来观测,不能与参数可信区间混淆。
16.11 思考题
- 等距网格中可以只标准化后验密度值,为什么非等距网格不可以?
- \(\exp(\hat\eta_{\mathrm{MAP}})\) 为什么一般不等于 \(\lambda\) 尺度的 MAP?
- 若优化程序返回
convergence = 0,为什么仍不能断定找到了正确的后验众数? - Laplace 近似给出的后验方差很小,是否足以说明近似准确?举出一种可能失败的后验形状。
- 重要性抽样的 ESS 很高,是否能保证极端尾部概率估计可靠?说明理由。
- 为什么直接平均条件预测概率通常比“先模拟一次未来观测再取比例”更稳定?
- 为什么建议分布与后验具有相同支持集,仍不足以保证重要性抽样具有有限方差?
- 估计 MAP 时可以删除与参数无关的常数,估计边际似然时为什么不可以?
16.12 上机实验
- 将网格改为在众数附近密、尾部稀的非等距网格。分别在加入和遗漏求积权重时计算\(\operatorname{E}(\lambda\mid\mathbf y)\),解释差异。
- 把样本量从 60 改为 5,用网格结果作为基准,比较 Laplace 近似的均值、区间和尾部概率误差。
- 设 \(\lambda\) 的先验直接为 \(\operatorname{Gamma}(2,1)\)。在 \(\eta=\log\lambda\) 上重写对数联合密度,明确指出 Jacobian 项,并用网格计算后验均值。
- 从五个相距较远的初值运行 MAP 优化。记录收敛码、梯度、目标函数值和 Hessian,并编写一段程序自动判断这些结果是否一致。
- 对本章三个重要性建议分布各重复运行 30 次。画出\(\operatorname{E}(\lambda\mid\mathbf y)\) 估计值与 ESS、最大权重的关系,并说明哪一个诊断最能预示不稳定结果。
- 用重要性抽样估计 \(P(\lambda>5\mid\mathbf y)\)。改变建议分布的尾部厚度,并将结果与网格法比较。
- 分别用条件概率加权平均和后验预测模拟估计\(P(\widetilde y\ge 8\mid\mathbf y)\)。重复实验,比较两种估计量的波动。
- 使用完整对数联合密度,分别用网格、Laplace 公式和重要性抽样估计 \(\log p(\mathbf y)\)。讨论为什么后验均值接近并不保证边际似然也接近。