第 4 章 统计计算中的线性代数方法
第一部分从 R 语言实践和数值计算基础出发,说明了统计目标进入计算机以后,为什么必须同时关注数值表示、误差与稳定性。从本章开始,我们进入确定性计算方法:给定相同的输入和计算设置,算法按照确定的规则产生结果;可靠性则取决于能否利用问题结构、控制数值与近似误差,并在迭代算法中检查收敛。本部分先从统计计算反复使用的线性代数开始,再依次讨论求根、优化、数值积分与 Laplace 近似以及 EM 算法。
4.1 学习目标与路线
在计算统计中,线性代数不是一门只用来证明定理的背景课程,而是把统计模型真正算出来的基本语言。只要数据被整理成表格,就已经可以看作一个矩阵;回归模型中的设计矩阵、协方差矩阵、转移概率矩阵、网络邻接矩阵,以及文本和图像的数值表示,也都离不开矩阵。对经济统计专业的学生来说,很多熟悉的问题其实都可以改写成矩阵计算问题:估计一组回归系数,比较多个变量的共同变化,压缩一张图片,或者判断网页、城市、产业部门之间的相互影响。
本章的目标不是重新讲授线性代数课程中的全部概念,而是从计算统计的角度回答一个更实际的问题:当一个统计问题写成矩阵形式以后,怎样才能算得快、算得稳、算得清楚?第 3 章已经讨论过,数学公式可以是正确的,但直接照公式计算未必可靠。线性代数中也有同样的情况。比如,线性回归的最小二乘估计常被写成
\[ \widehat{\boldsymbol\beta} =(\mathbf X^\top\mathbf X)^{-1}\mathbf X^\top\mathbf y. \]
这个公式帮助我们理解估计量的结构,但在实际计算中,通常不建议先显式求出逆矩阵再相乘。更稳妥的做法是使用矩阵分解或专门的线性方程组算法。R 中的 lm()、qr.solve() 等函数背后就体现了这种思想:统计计算不只是“把公式翻译成代码”,还要选择合适的数值方法。
在后续章节中,矩阵方法会反复出现。优化算法需要梯度、Hessian 矩阵和线性近似;Monte Carlo 模拟中常要处理协方差矩阵和相关结构;贝叶斯计算中,正态模型、层级模型和多参数后验分布都离不开矩阵运算。因此,理解本章内容,会让后面的优化、模拟和模型实现更容易读懂。
学完本章后,读者应该能够:
- 把回归、协方差和降维问题分别识别为线性方程、最小二乘或低秩近似问题;
- 根据矩阵结构,在
solve()、Cholesky、QR 和 SVD 之间选择算法,而不显式计算逆矩阵; - 用残差、奇异值、条件数和数值秩诊断计算是否可靠;
- 解释正规方程为什么会放大病态性,以及 QR 为什么是最小二乘的默认计算方法;
- 使用 SVD 完成标准化 PCA,并解释方差贡献率、载荷、得分和重构误差;
- 在选读案例中,用特征向量和低秩近似理解 PageRank、图像压缩与文本检索。
面对一个矩阵问题,先识别结构,再选算法。下面的表格给出本章反复使用的判断路线。
| 计算任务 | 矩阵结构 | 推荐方法 | 主要诊断 |
|---|---|---|---|
| 解 \(\mathbf A\mathbf x=\mathbf b\) | 一般可逆方阵 | solve(A, b) |
相对残差、条件数 |
| 解 \(\mathbf A\mathbf x=\mathbf b\) | 对称正定 | Cholesky 与三角求解 | 对称性、正定性、残差 |
| 最小化 \(\lVert\mathbf y-\mathbf X\boldsymbol\beta\rVert_2^2\) | 满列秩 | QR | 数值秩、残差 |
| 最小二乘 | 秩亏或近似秩亏 | 带主元 QR 或 SVD | 奇异值、数值秩 |
| 降维与低秩表示 | 中心化的数据矩阵 | SVD/PCA | 方差贡献率、重构误差 |
本章把线性方程、Cholesky、QR、SVD、条件数和 PCA 作为核心内容。图像压缩、特征值迭代、PageRank和潜在语义分析分别展示矩阵方法在图像、网络和文本问题中的应用,可按课时作为选读或 Lab。阅读时应始终追问三个问题:目标是什么、矩阵有什么结构、计算结果用什么量验证?
4.2 线性方程组与矩阵结构
许多统计计算最终都要求解
\[ \mathbf A\mathbf x=\mathbf b. \]
数学上可以写成 \(\mathbf x=\mathbf A^{-1}\mathbf b\),但计算任务应理解为“解方程”,而不是“先求逆”。显式形成 \(\mathbf A^{-1}\)通常需要更多运算和存储,也会引入不必要的舍入误差。因此,R 中应写 solve(A, b),而不是solve(A) %*% b。如果同一个 \(\mathbf A\) 要对应多个右端向量求解,成熟算法会先分解一次 \(\mathbf A\),再重复完成较便宜的三角求解。
得到数值解 \(\widehat{\mathbf x}\) 后,应检查残差向量
\[ \mathbf r=\mathbf b-\mathbf A\widehat{\mathbf x}. \]
为了让不同尺度的问题可以比较,可以使用相对残差
\[ \frac{\lVert\mathbf A\widehat{\mathbf x}-\mathbf b\rVert_2} {\lVert\mathbf A\rVert_2\lVert\widehat{\mathbf x}\rVert_2+ \lVert\mathbf b\rVert_2}. \]
下面的辅助函数将在本章中用于检查线性方程的计算结果。
relative_residual <- function(A, x, b) {
  numerator <- sqrt(sum((A %*% x - b)^2))
  denominator <- norm(A, type = "2") * sqrt(sum(x^2)) +
    sqrt(sum(b^2))

  if (denominator == 0) numerator else numerator / denominator
}
相对残差小说明“所报告的解基本满足输入的方程”,但不保证输入稍有扰动时解仍然稳定。后者还要结合条件数判断。换句话说,残差诊断算法有没有把当前问题算对;条件数诊断问题本身对扰动是否敏感。
4.2.1 对称正定矩阵与 Cholesky 分解
协方差矩阵、正定 Hessian 和 Ridge 回归中的矩阵经常是对称正定矩阵。若\(\mathbf A\in\mathbb R^{p\times p}\) 对称正定,则存在唯一的对角元为正的上三角矩阵 \(\mathbf R\),使得
\[ \mathbf A=\mathbf R^\top\mathbf R. \]
这称为 Cholesky 分解。R 的 chol(A) 返回上三角矩阵 \(\mathbf R\)。求解\(\mathbf A\mathbf x=\mathbf b\) 可以分成两次三角求解:
\[ \mathbf R^\top\mathbf z=\mathbf b, \qquad \mathbf R\mathbf x=\mathbf z. \]
相应的 R 函数是 forwardsolve() 和 backsolve()。下面使用 R 内置的 EuStockMarkets 日收盘指数,构造四个股票指数对数收益率的样本协方差矩阵。该数据只用于演示矩阵计算,不构成投资分析。
stock_prices <- as.matrix(EuStockMarkets)
stock_returns <- diff(log(stock_prices))
Sigma_stock <- cov(stock_returns)
b_stock <- colMeans(stock_returns)

R_stock <- chol(Sigma_stock)
z_stock <- forwardsolve(t(R_stock), b_stock)
x_chol <- backsolve(R_stock, z_stock)
x_solve <- solve(Sigma_stock, b_stock)

chol_checks <- c(
  factorization_error =
    norm(Sigma_stock - crossprod(R_stock), type = "F") /
      norm(Sigma_stock, type = "F"),
  solution_difference = max(abs(x_chol - x_solve)),
  relative_residual = relative_residual(Sigma_stock, x_chol, b_stock),
  log_determinant_chol = 2 * sum(log(diag(R_stock))),
  log_determinant_direct =
    as.numeric(determinant(Sigma_stock, logarithm = TRUE)$modulus)
)

signif(chol_checks, 4)
#>    factorization_error    solution_difference      relative_residual
#>              0.000e+00              1.776e-15              1.787e-17
#>   log_determinant_chol log_determinant_direct
#>             -3.939e+01             -3.939e+01
除了求解线性方程,Cholesky 分解还提供稳定的对数行列式计算:\(\log\det(\mathbf A)=2\sum_{j=1}^p\log R_{jj}\)。这在多元正态似然和后续贝叶斯计算中十分常见。若 chol() 失败,可能是矩阵并非对称正定、变量完全共线,或舍入误差使一个很小的特征值落到 0 以下。不能把随意加入一个很大的对角常数当作无害修复,因为那会改变原问题。
4.2.2 QR 分解与最小二乘
设 \(\mathbf X\) 是 \(n\times p\) 满列秩设计矩阵,其薄 QR 分解为
\[ \mathbf X=\mathbf Q\mathbf R, \qquad \mathbf Q^\top\mathbf Q=\mathbf I_p, \]
其中 \(\mathbf Q\) 的列正交,\(\mathbf R\) 是 \(p\times p\) 上三角矩阵。最小二乘问题
\[ \min_{\boldsymbol\beta} \lVert\mathbf y-\mathbf X\boldsymbol\beta\rVert_2^2 \]
可转化为三角方程
\[ \mathbf R\widehat{\boldsymbol\beta}=\mathbf Q^\top\mathbf y. \]
与正规方程相比,QR 避免显式形成 \(\mathbf X^\top\mathbf X\)。在二范数下,满列秩时有
\[ \kappa_2(\mathbf X^\top\mathbf X)=\kappa_2(\mathbf X)^2, \]
因此正规方程会把设计矩阵的病态程度平方放大。
R 内置的 longley 是一个经典的美国宏观经济数据集,只有 16 个年度观测,但解释变量高度相关,适合演示数值问题。这里的目的不是进行现代宏观实证,而是比较计算路线。
X_longley <- model.matrix(
  Employed ~ GNP + Unemployed + Armed.Forces + Population + Year,
  data = longley
)
y_longley <- longley$Employed

qr_X <- qr(X_longley)
Q_X <- qr.Q(qr_X, complete = FALSE)
R_X <- qr.R(qr_X, complete = FALSE)

beta_pivoted <- backsolve(R_X, crossprod(Q_X, y_longley))
beta_qr_manual <- numeric(ncol(X_longley))
beta_qr_manual[qr_X$pivot] <- beta_pivoted

beta_qr <- qr.coef(qr_X, y_longley)
beta_lmfit <- lm.fit(X_longley, y_longley)$coefficients
beta_normal <- solve(crossprod(X_longley),
                     crossprod(X_longley, y_longley))

coef_comparison <- data.frame(
  term = colnames(X_longley),
  QR = as.numeric(beta_qr),
  lm_fit = as.numeric(beta_lmfit),
  normal_equations = as.numeric(beta_normal),
  row.names = NULL
)

knitr::kable(coef_comparison, digits = 6)| term | QR | lm_fit | normal_equations |
|---|---|---|---|
| (Intercept) | -3.450e+03 | -3.450e+03 | -3.450e+03 |
| GNP | -3.196e-02 | -3.196e-02 | -3.196e-02 |
| Unemployed | -1.972e-02 | -1.972e-02 | -1.972e-02 |
| Armed.Forces | -1.020e-02 | -1.020e-02 | -1.020e-02 |
| Population | -7.754e-02 | -7.754e-02 | -7.754e-02 |
| Year | 1.814e+00 | 1.814e+00 | 1.814e+00 |
X_longley_scaled <- cbind(
  `(Intercept)` = 1,
  scale(X_longley[, -1, drop = FALSE])
)

condition_comparison <- data.frame(
  matrix = c("X", "crossprod(X)", "scaled X"),
  kappa_2 = c(
    kappa(X_longley, exact = TRUE),
    kappa(crossprod(X_longley), exact = TRUE),
    kappa(X_longley_scaled, exact = TRUE)
  )
)

knitr::kable(condition_comparison, digits = 4)| matrix | kappa_2 |
|---|---|
| X | 2.331e+07 |
| crossprod(X) | 5.434e+14 |
| scaled X | 8.067e+01 |
longley_fit_residual <- as.vector(
  y_longley - X_longley %*% beta_qr
)
c(
  manual_QR_difference = max(abs(beta_qr_manual - beta_qr)),
  relative_fit_residual =
    sqrt(sum(longley_fit_residual^2)) / sqrt(sum(y_longley^2)),
  least_squares_orthogonality =
    sqrt(sum(crossprod(X_longley, longley_fit_residual)^2)) /
      (norm(X_longley, type = "2") *
         sqrt(sum(longley_fit_residual^2)))
)
#>        manual_QR_difference       relative_fit_residual
#>                   2.592e-11                   3.502e-03
#> least_squares_orthogonality
#>                   2.261e-13
这个例子中三种方法仍给出很接近的结果,但 \(\mathbf X^\top\mathbf X\) 的条件数比 \(\mathbf X\) 大许多数量级。不能因为某个小例子“看起来算对了”就把正规方程作为默认实现。标准化明显改善了不同量纲造成的数值问题,却不能自动消除变量之间真实存在的近线性关系。实际回归应优先使用 lm()、lm.fit() 或带主元的 QR;若设计矩阵秩亏或近似秩亏,还需要结合奇异值和数值秩诊断。
4.3 特征分解
4.3.1 特征分析
理解特征值和特征向量,最好先从“矩阵对向量做了什么”开始。一个 \(n \times n\) 的矩阵 \(\mathbf A\)乘以向量 \(\mathbf x\) 以后,通常会同时改变 \(\mathbf x\) 的长度和方向。但是有些特殊方向很稳定:矩阵作用以后,向量仍然留在原来的直线上,只是被拉长、压缩或反向。也就是说,
\[ \mathbf A\mathbf x=\lambda\mathbf x. \]
这里的 \(\mathbf x\) 称为矩阵 \(\mathbf A\) 的特征向量(eigenvector),\(\lambda\) 称为对应的特征值(eigenvalue)。如果\(|\lambda|>1\),表示这个方向被放大;如果 \(0<|\lambda|<1\),表示这个方向被压缩;如果 \(\lambda<0\),伸缩的同时还会反向;如果 \(\lambda=0\),表示这个方向被压缩到零。
上述“拉伸、压缩、反向”的几何解释针对实特征值和实特征向量。一般实矩阵也可能出现复特征值,此时矩阵作用还包含旋转;统计中常见的协方差矩阵是实对称矩阵,其特征值和特征向量都为实数。
在二维情况下,特征分析(eigenanalysis)可以用图4.1来理解1。
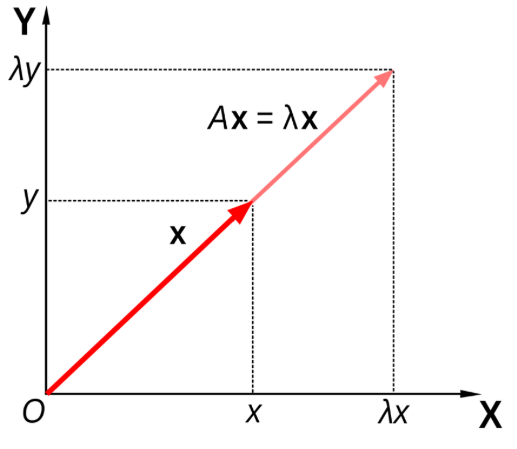
图4.1: 二维矩阵的特征分析
下面用一个很小的例子看 R 如何计算特征值和特征向量。
A <- matrix(c(2, 1,
              1, 2), nrow = 2, byrow = TRUE)

eig <- eigen(A)
eig$values
#> [1] 3 1
round(eig$vectors, 3)
#>       [,1]   [,2]
#> [1,] 0.707 -0.707
#> [2,] 0.707  0.707

v1 <- eig$vectors[, 1]
round(cbind(A_v1 = as.vector(A %*% v1),
            lambda_v1 = as.vector(eig$values[1] * v1)), 3)
#>       A_v1 lambda_v1
#> [1,] 2.121     2.121
#> [2,] 2.121     2.121
最后一行把 \(\mathbf A\mathbf v_1\) 和 \(\lambda_1\mathbf v_1\) 放在一起比较。两列数相同,说明第一个特征向量确实满足 \(\mathbf A\mathbf v_1=\lambda_1\mathbf v_1\)。需要注意的是,特征向量的符号没有唯一性:如果 \(\mathbf v\) 是特征向量,那么 \(-\mathbf v\) 也是同一个特征方向的特征向量。因此,读 R的输出时,不要过度解释正负号本身,而要关注它代表的方向。
在统计问题中,这种“特殊方向”非常有用。例如,协方差矩阵的特征向量可以表示变量共同变化的主要方向,特征值则表示这些方向上方差的大小。后面学习主成分分析、降维和 SVD 时,这个思想会反复出现。
4.3.2 矩阵的特征分解过程
特征分解(eigendecomposition)用矩阵的特征值和特征向量重新表示矩阵;对实对称矩阵得到的正交特征分解通常称为谱分解。其核心思想是:如果把坐标系换到由特征向量构成的坐标系里,矩阵 \(\mathbf A\) 的作用就会变得很简单,只是在每个特征方向上乘以一个数。
如果 \(n \times n\) 的矩阵 \(\mathbf A\) 具有 \(n\) 个线性独立的特征向量,那么 \(\mathbf A\) 是可对角化的,此时有
\[ \mathbf A=\mathbf Q\boldsymbol\Lambda\mathbf Q^{-1}. \]
其中 \(\mathbf Q\) 是由特征向量组成的矩阵,第 \(i\) 列是第 \(i\) 个特征向量 \(\mathbf q_i\);\(\boldsymbol\Lambda\) 是对角矩阵,对角线上的元素是对应的特征值,即 \(\Lambda_{ii}=\lambda_i\)。
这个表达式可以按三个步骤理解:
- \(\mathbf Q^{-1}\):把原来的向量转换到特征向量坐标系中。
- \(\boldsymbol\Lambda\):在每个特征方向上分别乘以对应的特征值。
- \(\mathbf Q\):把结果转换回原来的坐标系。
因此,特征分解把一个复杂的矩阵变换,拆成了“换坐标、按方向缩放、再换回来”。
如果 \(\mathbf A\) 是一个 \(n \times n\) 的实对称阵,那么
- \(\mathbf A\) 的 \(n\) 个特征根都为实数。
- \(\mathbf A\) 有 \(n\) 个互相正交的特征向量。
因此,实对称矩阵可以写成更简洁的形式:
\[ \mathbf A=\mathbf Q\boldsymbol\Lambda\mathbf Q^\top, \]
其中 \(\mathbf Q\) 是正交矩阵,满足 \(\mathbf Q^{-1}=\mathbf Q^\top\)。这一类矩阵在统计中尤其重要,因为协方差矩阵、相关系数矩阵、许多二次型矩阵都是实对称矩阵。
并不是所有矩阵都能漂亮地写成\(\mathbf A=\mathbf Q\boldsymbol\Lambda\mathbf Q^{-1}\)。如果矩阵不能对角化,数值软件通常会使用Schur 分解等更一般的方法,把矩阵转化为上三角或准上三角形式。本章不展开 Schur 分解的细节,只需要记住:特征分解是理解矩阵结构的重要工具,但实际计算中还会根据矩阵性质选择更稳定的数值方法。
4.3.3 特征分解可以帮助我们做什么?
理解矩阵幂与长期行为
特征分解最直接的好处,是让矩阵的高次幂变得容易理解。若\(\mathbf A=\mathbf Q\boldsymbol\Lambda\mathbf Q^{-1}\),则
\[ \mathbf A^k=\mathbf Q\boldsymbol\Lambda^k\mathbf Q^{-1}. \]
因为 \(\boldsymbol\Lambda\) 是对角矩阵,所以 \(\boldsymbol\Lambda^k\) 只需要把每个特征值分别做 \(k\) 次方即可。以 \(\mathbf A^{20}\) 为例:
\[ \mathbf A^{20}=\mathbf Q\boldsymbol\Lambda^{20}\mathbf Q^{-1}. \]
这在 Markov 链、人口转移、产业结构转移、网页排序等问题中很常见:如果一个状态不断被同一个矩阵更新,那么长期行为往往由最大的几个特征值及其对应的特征向量决定。
理解逆矩阵与数值稳定性
如果 \(\mathbf A\) 可对角化,并且所有特征值都不为 0,那么
\[ \mathbf A^{-1}=\mathbf Q\boldsymbol\Lambda^{-1}\mathbf Q^{-1}. \]
这里 \(\boldsymbol\Lambda^{-1}\) 只需要把每个非零特征值取倒数。这个公式提醒我们:如果某些特征值非常接近 0,那么它们的倒数会非常大,计算结果就容易对误差极其敏感。在线性回归中,多重共线性常常就表现为 \(\mathbf X^\top\mathbf X\) 的某些特征值很小。
因此,在统计计算里,特征分解不仅可以帮助我们“算”,还可以帮助我们判断一个问题是否容易算。实际编程时,通常应优先使用 solve(A, b)、qr.solve()、Cholesky 分解、QR 分解或 SVD 等方法求解线性方程组,而不是先显式计算 solve(A) 再相乘。
4.4 奇异值分解
特征分解很有用,但它有一个明显限制:它主要针对方阵,而且并不是每个方阵都能被良好地对角化。实际统计数据却常常不是方阵。比如,\(n\) 个样本、\(p\) 个变量构成的数据矩阵通常是 \(n \times p\) 的;一张灰度图像可以看作“像素行数 \(\times\) 像素列数”的矩阵;文本–词频矩阵、用户–商品评分矩阵也往往是长方形矩阵。
这时,奇异值分解(singular value decomposition,SVD)就登场了。SVD 可以用于任意实矩阵,是统计计算中最重要、最稳定的矩阵分解工具之一。它可以帮助我们理解矩阵的秩、判断病态程度、做降维、做低秩近似,也可以作为最小二乘、主成分分析和推荐系统等方法的计算基础。
从几何上看,SVD 把一个矩阵变换拆成三步:
- 先在输入空间中旋转或反射坐标轴;
- 再沿若干个互相垂直的方向进行伸缩;
- 最后在输出空间中再旋转或反射一次。
其中“伸缩”的大小就是奇异值。奇异值越大,说明矩阵在对应方向上的作用越强;奇异值越小,说明对应方向上的信息越弱,甚至可能主要是噪声。
4.4.1 奇异值和奇异向量
设 \(\mathbf A\) 是一个 \(m \times n\) 的矩阵。理论上,奇异值 \(\sigma\) 可以理解为矩阵\(\mathbf A^\top\mathbf A\) 的非负特征值的平方根。实际计算 SVD 时不应先显式形成\(\mathbf A^\top\mathbf A\),因为这会平方条件数。与奇异值对应的两类向量分别称为右奇异向量(right singular vector)和左奇异向量(left singular vector)。
如果 \(\sigma_j>0\),对应的右奇异向量为 \(\mathbf v_j\),左奇异向量为 \(\mathbf u_j\),那么它们满足
\[ \mathbf A\mathbf v_j=\sigma_j\mathbf u_j. \]
更具体地说,
\[ \mathbf A\mathbf v_j=\sigma_j\mathbf u_j, \qquad \mathbf A^\top\mathbf u_j=\sigma_j\mathbf v_j. \]
这里 \(\mathbf v_j\) 是输入空间中的方向,\(\mathbf u_j\) 是输出空间中的方向,\(\sigma_j\) 则告诉我们:矩阵\(\mathbf A\) 会把 \(\mathbf v_j\) 这个方向映射到 \(\mathbf u_j\) 这个方向,并把长度放大为原来的\(\sigma_j\) 倍。
4.4.2 奇异值分解
对于任意矩阵 \(\mathbf A \in \mathbb{R}^{m \times n}\),令 \(p=\min\{m,n\}\),则存在正交矩阵
\[ \mathbf U=[\mathbf u_1,\ldots,\mathbf u_m]\in\mathbb{R}^{m\times m} \]
和
\[ \mathbf V=[\mathbf v_1,\ldots,\mathbf v_n]\in\mathbb{R}^{n\times n}, \]
使得
\[\begin{equation} \mathbf U^\top\mathbf A\mathbf V=\boldsymbol\Sigma, \tag{4.1} \end{equation}\]
也就是
\[\begin{equation} \mathbf A=\mathbf U\boldsymbol\Sigma\mathbf V^\top. \tag{4.2} \end{equation}\]
其中 \(\boldsymbol\Sigma \in \mathbb{R}^{m\times n}\) 是一个“对角型”矩阵,对角线元素满足
\[ \sigma_1 \geq \sigma_2 \geq \cdots \geq \sigma_p \geq 0. \]
\(\sigma_j\) 称为第 \(j\) 个奇异值,\(\mathbf u_j\) 和 \(\mathbf v_j\) 分别称为对应的左奇异向量和右奇异向量。
如果矩阵 \(\mathbf A\) 的秩为 \(r\),即只有 \(r\) 个正的奇异值,那么 SVD 常写成更紧凑的形式:
\[\begin{equation} \mathbf A=\mathbf U_r\mathbf D_r\mathbf V_r^\top, \tag{4.3} \end{equation}\]其中 \(\mathbf U_r=[\mathbf u_1,\ldots,\mathbf u_r]\),\(\mathbf V_r=[\mathbf v_1,\ldots,\mathbf v_r]\),
\[ \mathbf D_r=\operatorname{diag}(\sigma_1,\ldots,\sigma_r). \]
这个式子也可以写成外积加和形式:
\[ \mathbf A=\sum_{j=1}^{r}\sigma_j\mathbf u_j\mathbf v_j^\top. \]
这句话很重要:SVD 把一个矩阵拆成若干个简单矩阵的加和,每一项\(\sigma_j\mathbf u_j\mathbf v_j^\top\) 都是一个秩为 1 的矩阵。排在前面的项贡献最大,排在后面的项贡献较小。这正是低秩近似和数据压缩能够成立的原因。
下面用 R 计算一个小矩阵的 SVD,并验证\(\mathbf A=\mathbf U\boldsymbol\Sigma\mathbf V^\top\)。
A <- matrix(c(3, 2,
              2, 3,
              1, 1), nrow = 3, byrow = TRUE)

s <- svd(A)
s$d
#> [1] 5.196 1.000

A_reconstructed <- s$u %*% diag(s$d) %*% t(s$v)
round(A_reconstructed, 6)
#>      [,1] [,2]
#> [1,]    3    2
#> [2,]    2    3
#> [3,]    1    1
重构得到的矩阵与原矩阵相同,只是由于浮点数计算,输出中可能出现极小的舍入误差。R 中 svd() 返回的 d 是奇异值,u 是左奇异向量矩阵,v 是右奇异向量矩阵。对于长方形矩阵,R 默认返回的是紧凑形式,通常已经足够用于统计计算。
4.4.3 奇异值分解的一些性质
SVD 的几个性质值得记住。
- \(\mathbf A\) 的非零奇异值是 \(\mathbf A^\top\mathbf A\) 和 \(\mathbf A\mathbf A^\top\) 的非零特征值的平方根。
- \(\mathbf A\) 的秩等于其非零奇异值的个数。
- 若 \(\mathbf A\) 是中心化后的数据矩阵,则 \(\mathbf A^\top\mathbf A\) 与样本协方差矩阵只差一个常数倍。因此,SVD 与主成分分析有直接关系。
- 如果奇异值下降很快,说明矩阵中的主要信息可以用少数几个方向概括;如果很多奇异值都不小,说明数据结构更复杂,难以用低维结构解释。
- 对非奇异方阵,或最小二乘中满列秩的 \(m\times p\) 矩阵,二范数条件数为
\[ \kappa_2(\mathbf A)=\frac{\sigma_1}{\sigma_p}. \]
如果矩阵丢失列秩,即 \(\sigma_p=0\),标准条件数为无穷。若只在非零奇异值对应的子空间上计算\(\sigma_1/\sigma_r\),应称为有效条件数,不能把它与原问题的标准条件数混为一谈。条件数越大,相关计算越容易受到舍入误差和数据扰动的影响。
计算机中的奇异值很少恰好等于 0,因此还需要定义数值秩。给定相对阈值 \(\tau\),可定义
\[ r_\tau=\#\{j:1\leq j\leq p,\ \sigma_j>\tau\sigma_1\}. \]
阈值不是矩阵的固有真理,而是“多小的方向在当前精度和任务下视为不可辨认”的计算约定。下面给出两个教学辅助函数;第二个函数在同一阈值下发现数值秩亏时报告 Inf,因此是数值诊断,而不是符号意义上的精确秩判定。
numerical_rank <- function(A,
                           rel_tol = max(dim(A)) * .Machine$double.eps) {
  d <- svd(A, nu = 0, nv = 0)$d
  if (length(d) == 0 || d[1] == 0) return(0L)
  sum(d > rel_tol * d[1])
}

numerical_condition_2 <- function(
    A, rel_tol = max(dim(A)) * .Machine$double.eps) {
  d <- svd(A, nu = 0, nv = 0)$d
  if (length(d) == 0 || d[1] == 0 ||
      d[length(d)] <= rel_tol * d[1]) {
    return(Inf)
  }
  d[1] / d[length(d)]
}

A_rank_deficient <- cbind(c(1, 2, 3, 4), c(2, 4, 6, 8))
c(
  numerical_rank = numerical_rank(A_rank_deficient),
  numerical_condition_2 = numerical_condition_2(A_rank_deficient)
)
#>        numerical_rank numerical_condition_2
#>                     1                   Inf
4.5 SVD 的统计应用
4.5.1 经济社会指标的主成分分析
主成分分析(principal component analysis,PCA)把一组相关变量转换成少数几个互相正交的综合方向。设中心化后的数据矩阵为 \(\mathbf X_{\mathrm{c}}\in\mathbb R^{n\times p}\),其中 \(n\) 是观测数、\(p\) 是变量数。令 \(q=\min\{n,p\}\),其薄 SVD 为
\[ \mathbf X_{\mathrm{c}}=\mathbf U\mathbf D\mathbf V^\top. \]
那么 \(\mathbf V\) 的列是主成分载荷方向,\(\mathbf U\mathbf D=\mathbf X_{\mathrm{c}}\mathbf V\) 是观测的主成分得分。对 \(j=1,\ldots,q\),第 \(j\) 个主成分的样本方差为
\[ \frac{d_j^2}{n-1}, \]
方差贡献率为 \(d_j^2/\sum_{\ell=1}^q d_\ell^2\)。因此,PCA 不是与 SVD 无关的另一套算法,而是 SVD 在中心化数据矩阵上的直接统计解释。
下面使用 R 内置的 state.x77 历史数据,选取收入、文盲率、预期寿命、谋杀率和高中毕业率五个指标。这些指标单位不同,因此先标准化,再进行 PCA。该数据来自 20 世纪 70 年代,只适合算法教学,不能用来描述当前美国各州状况。
pca_variables <- c(
  "Income", "Illiteracy", "Life Exp", "Murder", "HS Grad"
)
socioeconomic <- state.x77[, pca_variables]

pca_fit <- prcomp(socioeconomic, center = TRUE, scale. = TRUE)
variance_share <- pca_fit$sdev^2 / sum(pca_fit$sdev^2)

pca_variance <- data.frame(
  component = paste0("PC", seq_along(variance_share)),
  variance_share = variance_share,
  cumulative_share = cumsum(variance_share)
)
knitr::kable(pca_variance, digits = 3)| component | variance_share | cumulative_share |
|---|---|---|
| PC1 | 0.640 | 0.640 |
| PC2 | 0.188 | 0.828 |
| PC3 | 0.080 | 0.908 |
| PC4 | 0.062 | 0.969 |
| PC5 | 0.031 | 1.000 |
pca_loadings <- data.frame(
  variable = rownames(pca_fit$rotation),
  PC1 = pca_fit$rotation[, 1],
  PC2 = pca_fit$rotation[, 2],
  row.names = NULL
)
knitr::kable(pca_loadings, digits = 3)| variable | PC1 | PC2 |
|---|---|---|
| Income | 0.347 | 0.732 |
| Illiteracy | -0.480 | 0.069 |
| Life Exp | 0.469 | -0.324 |
| Murder | -0.459 | 0.492 |
| HS Grad | 0.467 | 0.336 |
PC1 在收入、预期寿命和高中毕业率上同向,在文盲率和谋杀率上反向,可以描述为一种综合的社会经济梯度;但“方向符号”本身可以整体翻转,而且最大方差方向并不自动等于发展水平、福利或因果效应。PC2 更多反映第一主成分没有概括的差异。
下面直接对标准化矩阵做 SVD,验证 prcomp() 与 SVD 的关系,并计算只保留前两个主成分时的相对重构误差。
Z_socioeconomic <- scale(socioeconomic)
svd_socioeconomic <- svd(Z_socioeconomic)

svd_sdev <- svd_socioeconomic$d / sqrt(nrow(Z_socioeconomic) - 1)
k_pca <- 2
Z_rank2 <- svd_socioeconomic$u[, 1:k_pca, drop = FALSE] %*%
  diag(svd_socioeconomic$d[1:k_pca], nrow = k_pca) %*%
  t(svd_socioeconomic$v[, 1:k_pca, drop = FALSE])

pca_checks <- c(
  sdev_difference = max(abs(svd_sdev - pca_fit$sdev)),
  loading_difference_up_to_sign = max(
    abs(abs(svd_socioeconomic$v) - abs(pca_fit$rotation))
  ),
  rank2_relative_error =
    norm(Z_socioeconomic - Z_rank2, type = "F") /
      norm(Z_socioeconomic, type = "F")
)
signif(pca_checks, 4)
#>               sdev_difference loading_difference_up_to_sign
#>                        0.0000                        0.0000
#>          rank2_relative_error
#>                        0.4149
old_par <- par(mfrow = c(1, 2), mar = c(4, 4, 2, 1))
plot(
seq_along(variance_share), variance_share,
type = "b", pch = 19, ylim = c(0, 1),
xlab = "Principal component", ylab = "Variance share"
)
lines(seq_along(variance_share), cumsum(variance_share),
type = "b", pch = 1, lty = 2, col = "steelblue")
legend("right", c("Individual", "Cumulative"), pch = c(19, 1),
lty = c(1, 2), col = c("black", "steelblue"), bty = "n")
plot(
pca_fit$x[, 1], pca_fit$x[, 2], type = "n",
xlab = "PC1 score", ylab = "PC2 score"
)
abline(h = 0, v = 0, col = "gray80")
text(pca_fit$x[, 1], pca_fit$x[, 2], labels = state.abb, cex = 0.65)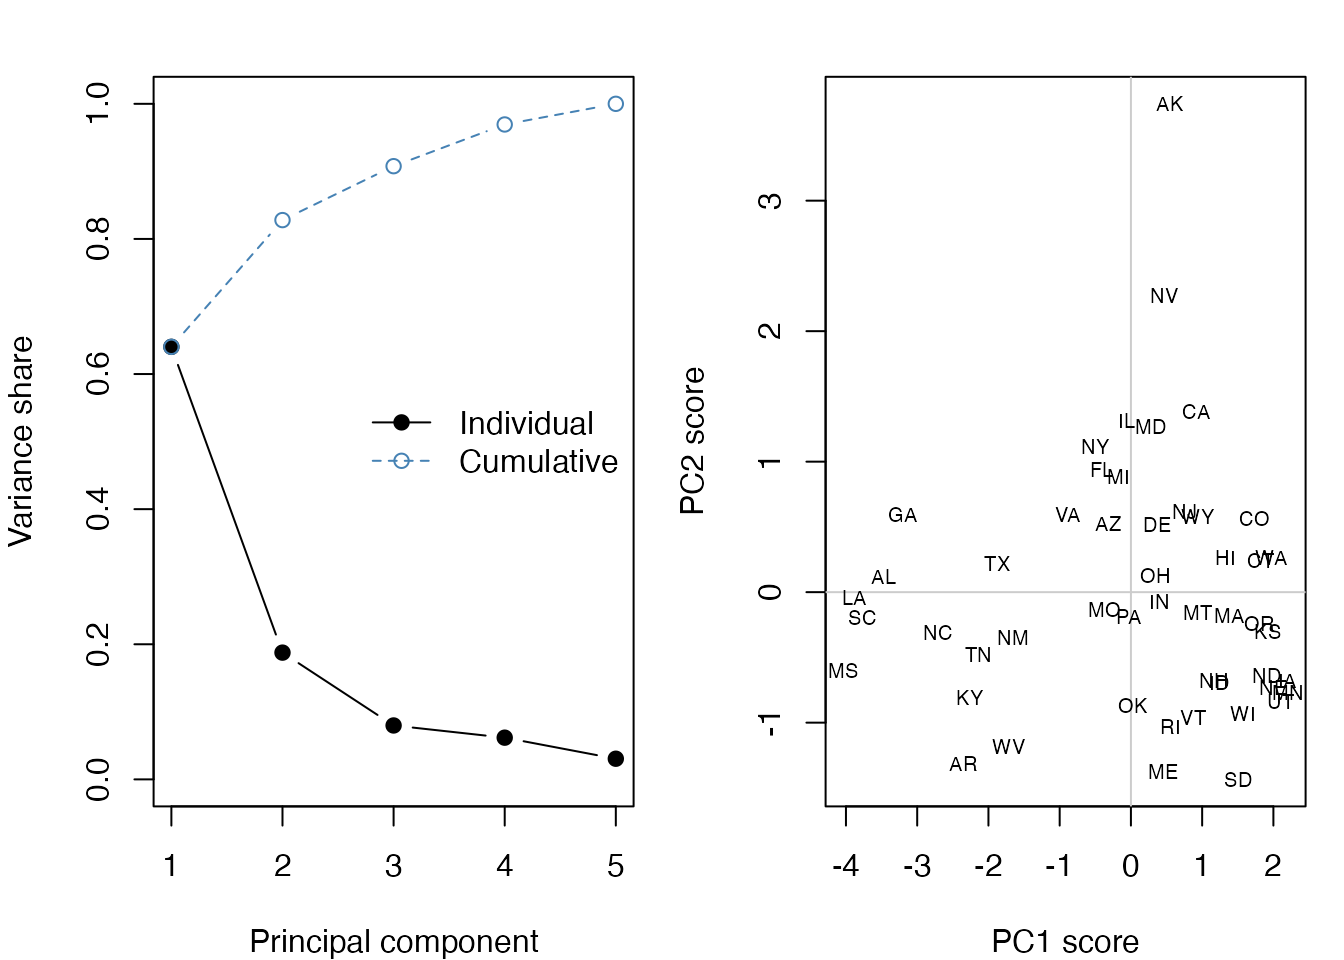
图4.2: 社会经济指标 PCA 的方差贡献率与州得分
是否标准化必须由变量单位和研究目标决定,而不是机械选择。若 PCA 被放入预测流程,中心、尺度和载荷都必须只在训练数据上估计,再应用到验证数据;否则会发生第 13 章讨论的数据泄漏。PCA 是描述性降维工具,不能单独提供经济因果解释。
4.5.2 矩阵的低秩估计
根据公式 (4.3),\(\mathbf A\) 可以写成外积加和形式:
\[ \mathbf A=\sum_{j=1}^r\sigma_j\mathbf u_j\mathbf v_j^\top =\sigma_1\mathbf u_1\mathbf v_1^\top+ \cdots+\sigma_r\mathbf u_r\mathbf v_r^\top. \]
如果只保留前 \(k\) 项,\(1 \leq k < r\),就得到秩为 \(k\) 的近似矩阵:
\[ \mathbf A_k=\sum_{j=1}^k\sigma_j\mathbf u_j\mathbf v_j^\top =\sigma_1\mathbf u_1\mathbf v_1^\top+ \cdots+\sigma_k\mathbf u_k\mathbf v_k^\top. \]
如果后面的奇异值 \(\sigma_{k+1},\ldots,\sigma_r\) 很小,那么 \(\mathbf A\) 和 \(\mathbf A_k\) 的差别也会很小。在谱范数意义下,最优秩 \(k\) 近似的误差为
\[ \lVert\mathbf A-\mathbf A_k\rVert_2=\sigma_{k+1}. \]
这说明:当奇异值快速下降时,用少数几个方向就能保留矩阵的主要信息。
4.5.3 图像的低秩重构
图像压缩是理解低秩近似的好例子。一张灰度图像可以看作一个矩阵:矩阵中的每个元素表示一个像素点的灰度值。若原图像对应一个 \(m\times n\) 的矩阵 \(\mathbf A\),直接存储需要 \(mn\) 个数。若用秩为 \(k\) 的近似矩阵
\[ \mathbf A_k=\mathbf U_k\mathbf D_k\mathbf V_k^\top \]
来表示,则只需要存储 \(\mathbf U_k\)、\(\mathbf D_k\) 和 \(\mathbf V_k\),大约需要
\[ mk+k+nk=k(m+n+1) \]
个数。当 \(k\) 远小于 \(m\) 和 \(n\) 时,因子表示所需的数值量会明显下降。如果前几个奇异值已经保留了图像的大部分信息,低秩图像仍可能保留主要轮廓。
本书示例实际是一张 RGB 图片,三个颜色通道分别做 SVD。原始数组包含 \(3mn\) 个数,低秩因子包含\(3k(m+n+1)\) 个数,比例仍为 \(k(m+n+1)/(mn)\)。这个比例比较的是未编码数值的数量,不是 JPEG 文件大小;JPEG 本身还有量化和压缩编码,不能用输出文件的字节数验证上述公式。
image_height <- 421
image_width <- 286
image_ranks <- c(32, 116, 200)

image_storage <- data.frame(
  rank = image_ranks,
  RGB_factor_values =
    3 * image_ranks * (image_height + image_width + 1),
  storage_ratio =
    image_ranks * (image_height + image_width + 1) /
      (image_height * image_width)
)
image_storage$is_compression <- image_storage$storage_ratio < 1

knitr::kable(image_storage, digits = 3)| rank | RGB_factor_values | storage_ratio | is_compression |
|---|---|---|---|
| 32 | 67968 | 0.188 | TRUE |
| 116 | 246384 | 0.682 | TRUE |
| 200 | 424800 | 1.176 | FALSE |
对当前 \(421\times286\) 图片,只有 \(k<mn/(m+n+1)\approx170\) 时,低秩因子的数值个数才少于原像素数组。因此,\(k=200\) 是高保真低秩重构,但按因子数量并不构成压缩。
例4.1 基于矩阵的低秩近似对以下图片进行压缩。
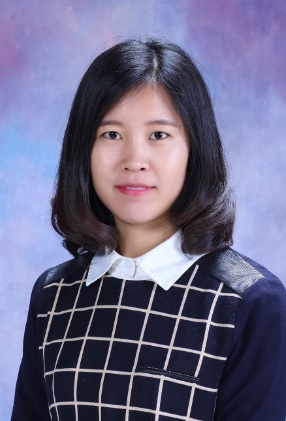
library(jpeg)
ykang <- readJPEG('./figs/ykang.jpg')
rgb_svds <- lapply(seq_len(3), function(channel) {
  svd(ykang[, , channel])
})

for (k in c(32, 116, 200)) {
  reconstructed <- array(0, dim = dim(ykang))

  for (channel in seq_len(3)) {
    s <- rgb_svds[[channel]]
    reconstructed[, , channel] <-
      s$u[, seq_len(k), drop = FALSE] %*%
      diag(s$d[seq_len(k)], nrow = k, ncol = k) %*%
      t(s$v[, seq_len(k), drop = FALSE])
  }

  reconstructed <- pmin(pmax(reconstructed, 0), 1)
  writeJPEG(
    reconstructed,
    file.path("figs", paste0("ykang_svd_rank_", k, ".jpg"))
  )
}
以下三张低秩图像对应的秩分别为 200、116 和 32。比较它们的清晰程度,可以直观看到:秩越高,保留的信息越多;秩越低,因子表示越小,但细节损失也越明显。
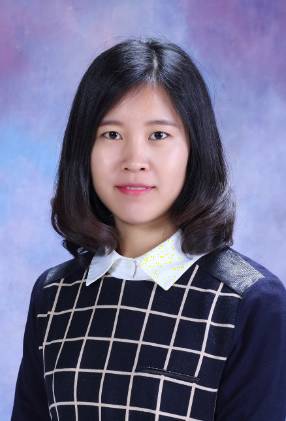
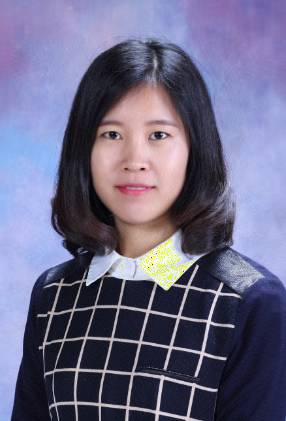
低秩重构还提供可以验证的误差关系:谱范数误差为 \(\sigma_{k+1}\),Frobenius 误差平方为被舍弃奇异值平方之和。视觉质量、矩阵误差、因子数和实际文件大小是四个不同概念,报告“压缩效果”时应说明所用指标。
4.5.4 伪逆
在线性回归中,我们常写最小二乘估计为
\[ \widehat{\boldsymbol\beta} =(\mathbf X^\top\mathbf X)^{-1}\mathbf X^\top\mathbf y. \]
这个公式要求 \(\mathbf X^\top\mathbf X\) 可逆。但在实际数据中,可能出现变量完全共线、变量数多于样本数,或者设计矩阵不是满秩等情况。此时普通逆矩阵不存在,伪逆(pseudoinverse)就提供了一种更一般的解决办法。
如果 \(\mathbf A\) 的紧凑 SVD 为
\[ \mathbf A=\mathbf U_r\mathbf D_r\mathbf V_r^\top, \]
则 \(\mathbf A\) 的 Moore–Penrose 伪逆定义为
\[ \mathbf A^+=\mathbf V_r\mathbf D_r^{-1}\mathbf U_r^\top. \]
其中 \(\mathbf D_r^{-1}\) 是把所有非零奇异值取倒数组成的对角矩阵。浮点计算中需要用相对阈值判断哪些方向保留;因此教学代码实际计算的是阈值化的 SVD 伪逆,结果会随阈值改变。伪逆可以用于求解最小二乘问题
\[ \min_{\mathbf x}\lVert\mathbf A\mathbf x-\mathbf b\rVert_2^2. \]
当方程有唯一最小二乘解时,\(\mathbf x=\mathbf A^+\mathbf b\) 与通常的最小二乘解一致;当解不唯一时,伪逆给出欧氏长度最小的那个解。
下面用 R 写一个简单的伪逆函数。
pinv <- function(A,
                 rel_tol = max(dim(A)) * .Machine$double.eps) {
  s <- svd(A)

  if (length(s$d) == 0 || s$d[1] == 0) {
    return(matrix(0, nrow = ncol(A), ncol = nrow(A)))
  }

  keep <- s$d > rel_tol * s$d[1]
  if (!any(keep)) {
    return(matrix(0, nrow = ncol(A), ncol = nrow(A)))
  }

  s$v[, keep, drop = FALSE] %*%
    diag(1 / s$d[keep], nrow = sum(keep)) %*%
    t(s$u[, keep, drop = FALSE])
}

x <- c(1, 2, 3, 4)
y <- c(1.1, 1.9, 3.2, 3.9)
X <- cbind(1, x)

coef_pinv <- pinv(X) %*% y
coef_qr <- qr.solve(X, y)

round(cbind(pinv = coef_pinv, qr = coef_qr), 4)
#>          qr
#>   0.10 0.10
#> x 0.97 0.97

# 欠定系统:存在无穷多个精确解
A_under <- matrix(c(1, 0, 1,
                    0, 1, 1), nrow = 2, byrow = TRUE)
b_under <- c(1, 2)
x_min_norm <- as.vector(pinv(A_under) %*% b_under)
null_direction <- c(-1, -1, 1)

pinv_checks <- c(
  equation_residual = sqrt(sum((A_under %*% x_min_norm - b_under)^2)),
  penrose_AApA = norm(A_under %*% pinv(A_under) %*% A_under -
                       A_under, type = "F"),
  minimum_norm_solution = sqrt(sum(x_min_norm^2)),
  another_solution = sqrt(sum((x_min_norm + null_direction)^2))
)
signif(pinv_checks, 4)
#>     equation_residual          penrose_AApA minimum_norm_solution
#>             9.930e-16             6.402e-16             1.414e+00
#>      another_solution
#>             2.236e+00
在第一个满秩例子中,伪逆解和 QR 解相同。第二个系统有无穷多个解,x_min_norm 给出欧氏范数最小的解;沿零空间方向移动仍满足方程,但范数更大。实际建模时,R 的 lm() 内部使用带主元 QR 等成熟算法,不需要手写伪逆;理解伪逆的价值在于解释 SVD 如何处理秩亏,以及阈值为什么会影响可辨认方向。
4.5.5 曲线拟合
曲线拟合可以看作线性代数在统计建模中的一个直接应用。假设我们希望用二次多项式拟合一组数据:
\[ y_i \approx \beta_0+\beta_1x_i+\beta_2x_i^2. \]
把所有样本放在一起,就可以写成矩阵形式:
\[ \mathbf y\approx\mathbf X\boldsymbol\beta, \]
其中 \(\mathbf X\) 的第 \(i\) 行为 \((1,x_i,x_i^2)\)。这样,曲线拟合就转化成了最小二乘问题。
set.seed(123)
x <- seq(-1, 1, length.out = 30)
y <- 1 + 2 * x - 1.5 * x^2 + rnorm(length(x), sd = 0.15)

X <- cbind(1, x, x^2)
beta_hat <- qr.solve(X, y)
round(beta_hat, 3)
#>             x
#>  0.984  1.946 -1.475

x_grid <- seq(min(x), max(x), length.out = 200)
X_grid <- cbind(1, x_grid, x_grid^2)
y_hat <- as.vector(X_grid %*% beta_hat)

plot(x, y, pch = 19, col = "gray40",
     xlab = "x", ylab = "y")
lines(x_grid, y_hat, col = "steelblue", lwd = 2)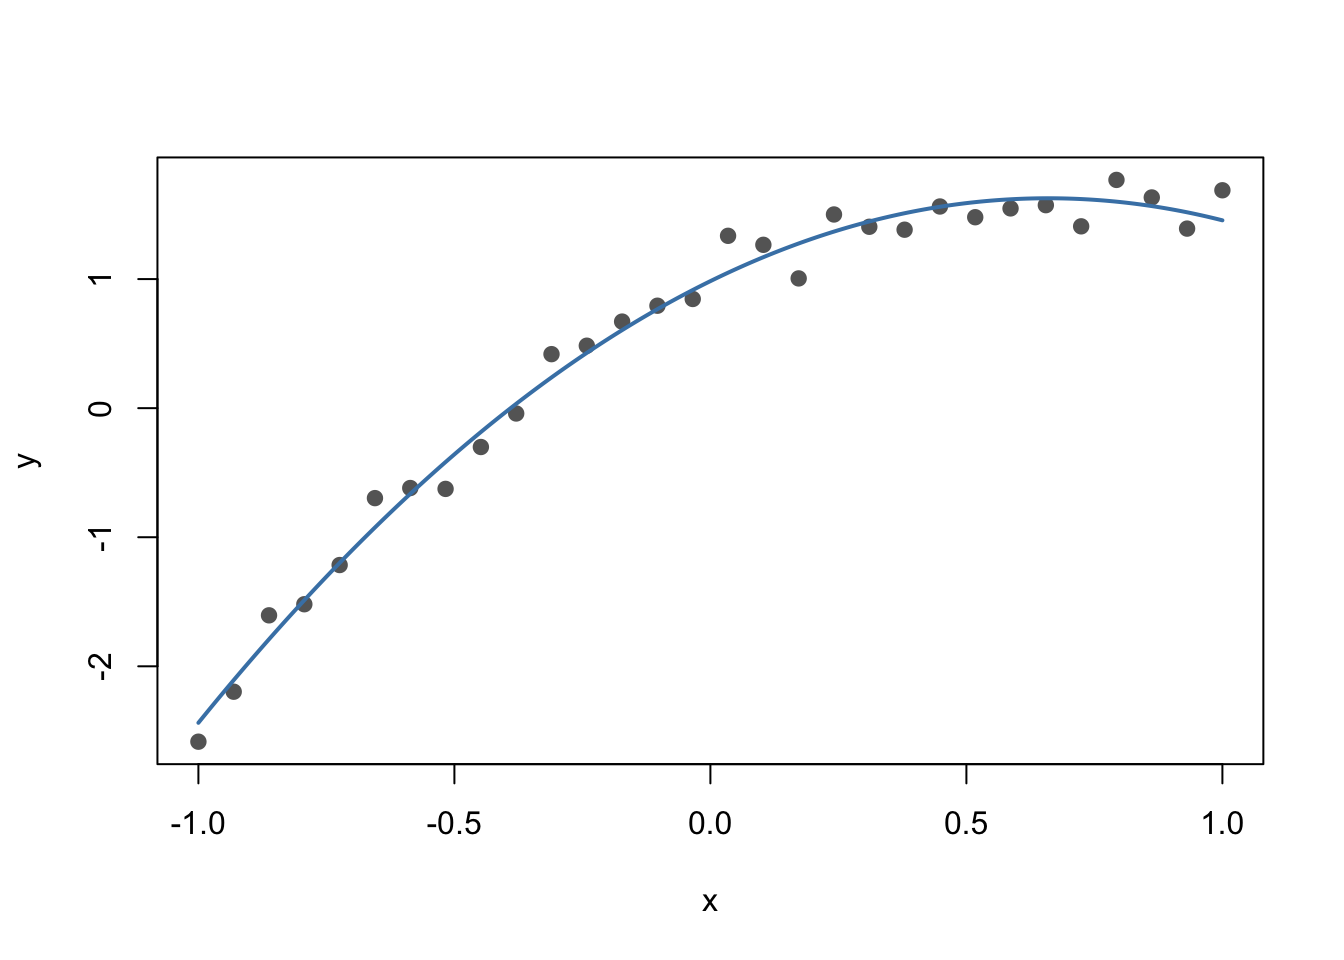
图4.3: 用二次多项式进行曲线拟合
这个例子提醒我们:很多“统计模型”的计算核心其实是矩阵问题。真正编程时,我们通常使用qr.solve()、lm() 或其他稳定算法求解,而不是直接计算\((\mathbf X^\top\mathbf X)^{-1}\mathbf X^\top\mathbf y\)。当多项式次数很高时,设计矩阵可能变得病态,这时 SVD、QR 分解、中心化和标准化都会变得重要。
4.6 拓展:特征值的迭代计算
在小矩阵中,我们可以直接调用 eigen() 或 svd()。但在大规模问题中,矩阵可能有上万甚至上百万行列,直接分解整个矩阵不仅慢,而且可能没有必要。例如,PageRank 只关心最重要的特征向量;低秩近似只关心前几个最大的奇异值。此时,迭代算法就非常重要。
迭代算法的思想是:从一个初始猜测出发,反复进行简单计算,让结果逐步接近目标。当变化已经足够小时,就停止迭代。下面介绍两个经典思想:幂方法和 QR 算法。
本节用于理解算法思想,可作为选读。普通统计建模不应自行实现特征值求解器,而应使用经过充分测试的数值库。这里尤其强调:迭代次数不是收敛证据,算法必须返回残差和收敛状态。
4.6.1 幂方法(Power method)
幂方法是计算矩阵最大模特征值及其对应特征向量的经典方法。它背后的想法非常直接:如果不断用矩阵\(\mathbf A\) 去乘一个向量,那么在很多情况下,向量的方向会逐渐靠近主特征向量的方向。本节代码主要面向实对称矩阵;还要求主特征值的模严格大于其他特征值,并且初始向量在主特征向量方向上的分量不为 0。
对于一个 \(n \times n\) 的矩阵 \(\mathbf A\),如果 \(\mathbf q\) 是其对应于特征值 \(\lambda\) 的特征向量,那么 \(\mathbf A\mathbf q=\lambda\mathbf q\)。进一步有
\[ \mathbf A^k\mathbf q=\lambda^k\mathbf q. \]
假设 \(\mathbf A\) 有 \(n\) 个线性独立的特征向量 \(\mathbf q_1,\ldots,\mathbf q_n\),其特征值满足
\[ |\lambda_1| > |\lambda_2| \geq \cdots \geq |\lambda_n|. \]
如果初始向量 \(\mathbf x_0\) 在 \(\mathbf q_1\) 方向上的分量不为 0,则可以写成
\[ \mathbf x_0=c_1\mathbf q_1+\cdots+c_n\mathbf q_n, \qquad c_1\neq 0. \]
连续左乘 \(\mathbf A\),得到
\[\begin{align*} \mathbf A^k\mathbf x_0 &=c_1\lambda_1^k\mathbf q_1+\cdots+c_n\lambda_n^k\mathbf q_n,\\ &=\lambda_1^k\left\{c_1\mathbf q_1+ \sum_{i=2}^n c_i\left(\frac{\lambda_i}{\lambda_1}\right)^k\mathbf q_i\right\}. \end{align*}\]
由于 \(|\lambda_i/\lambda_1|<1\),当 \(k\) 增大时,后面的分量会逐渐衰减,\(\mathbf A^k\mathbf x_0\) 的方向就会越来越接近 \(\mathbf q_1\)。
不过,\(\mathbf A^k\mathbf x_0\) 的长度可能越来越大或越来越小,而我们真正关心的是方向。因此实践中通常使用标准化的幂方法。
标准化的幂方法
选择一个初始向量 \(\mathbf x_0\),令\(\mathbf q_0=\mathbf x_0/\lVert\mathbf x_0\rVert_2\)。
对于 \(k = 1,2,\ldots\) 重复以下过程:
- 计算 \(\mathbf z_k=\mathbf A\mathbf q_{k-1}\);
- 标准化 \(\mathbf q_k=\mathbf z_k/\lVert\mathbf z_k\rVert_2\);
- 计算 \(\lambda_k=\mathbf q_k^\top\mathbf A\mathbf q_k\);
- 计算特征残差\(\lVert\mathbf A\mathbf q_k-\lambda_k\mathbf q_k\rVert_2\);若尺度化残差足够小,则停止。
下面给出一个简单实现。
power_method <- function(A, q0 = NULL,
                         max_iter = 1000, tol = 1e-10) {
  A <- as.matrix(A)
  if (nrow(A) != ncol(A) || any(!is.finite(A))) {
    stop("A 必须是元素有限的方阵。")
  }
  if (max_iter < 1 || tol <= 0) {
    stop("max_iter 必须为正整数,tol 必须为正数。")
  }

  n <- nrow(A)
  if (is.null(q0)) q0 <- rnorm(n)
  if (length(q0) != n || any(!is.finite(q0))) {
    stop("q0 的长度必须等于矩阵维数,且元素有限。")
  }

  q_norm <- sqrt(sum(q0^2))
  if (q_norm == 0) stop("q0 不能是零向量。")
  q <- as.vector(q0 / q_norm)
  converged <- FALSE
  relative_eigen_residual <- Inf

  for (iter in seq_len(max_iter)) {
    z <- as.vector(A %*% q)
    z_norm <- sqrt(sum(z^2))
    if (!is.finite(z_norm) || z_norm == 0) {
      stop("A %*% q 为零或非有限值;请检查矩阵或更换初始向量。")
    }

    q <- z / z_norm
    Aq <- as.vector(A %*% q)
    lambda <- sum(q * Aq)
    eigen_residual <- sqrt(sum((Aq - lambda * q)^2))
    residual_scale <- max(1, sqrt(sum(Aq^2)), abs(lambda))
    relative_eigen_residual <- eigen_residual / residual_scale

    if (relative_eigen_residual <= tol) {
      converged <- TRUE
      break
    }
  }

  list(
    value = lambda,
    vector = q,
    iter = iter,
    relative_residual = relative_eigen_residual,
    converged = converged,
    reason = if (converged) {
      "relative residual reached tolerance"
    } else {
      "maximum iterations reached"
    }
  )
}

A_power <- matrix(c(2, -1,
                    -1, 2), nrow = 2, byrow = TRUE)

set.seed(404)
pm <- power_method(A_power)
c(
  power_value = pm$value,
  exact_value = eigen(A_power, symmetric = TRUE)$values[1],
  relative_residual = pm$relative_residual,
  iterations = pm$iter,
  converged = pm$converged
)
#>       power_value       exact_value relative_residual        iterations
#>         3.000e+00         3.000e+00         7.439e-11         2.100e+01
#>         converged
#>         1.000e+00
pm$reason
#> [1] "relative residual reached tolerance"
这个矩阵的主特征向量方向为 \((1,-1)^\top\)。若机械使用全 1 初值,它恰好与主方向正交,因此本例也说明初值条件不能省略。随机连续初值以概率 1 不会恰好正交,但仍应报告残差和收敛状态。对于大规模稀疏矩阵,幂方法的优势在于每一步只需做矩阵–向量乘法,不必完整分解矩阵。
4.6.2 QR 特征值算法
幂方法主要给出最大的特征值和对应特征向量。如果希望计算多个特征值,QR 算法是更系统的方法。它的基础是 QR 分解:任意合适的矩阵 \(\mathbf A\) 可以写成
\[ \mathbf A=\mathbf Q\mathbf R, \]
其中 \(\mathbf Q\) 是正交矩阵,\(\mathbf R\) 是上三角矩阵。QR 算法反复执行下面的步骤:
\[ \mathbf A_k=\mathbf Q_k\mathbf R_k, \qquad \mathbf A_{k+1}=\mathbf R_k\mathbf Q_k. \]
由于
\[ \mathbf A_{k+1} =\mathbf R_k\mathbf Q_k =\mathbf Q_k^\top\mathbf A_k\mathbf Q_k, \]
\(\mathbf A_{k+1}\) 与 \(\mathbf A_k\) 是相似矩阵,因此每一步都不改变特征值。更准确地说,QR 迭代的目标不是让任意矩阵都必然“变成”上三角矩阵,而是通过一系列正交相似变换逼近矩阵的 Schur 形式。对一些典型情形,例如可对角化、特征值模长可以分离且满足非退化条件的矩阵,未移位 QR 迭代会使\(\mathbf A_k\) 的下三角部分逐渐变小,对角线元素趋近于特征值。若 \(\mathbf A\) 是实对称矩阵,这个极限形式通常可以理解为对角矩阵;若 \(\mathbf A\) 是一般实矩阵,极限形式更自然地表述为实 Schur 形式,即准上三角矩阵,其中 \(2\times2\) 小块对应复共轭特征值。
qr_eigen_symmetric <- function(A, max_iter = 1000, tol = 1e-12) {
  A <- as.matrix(A)
  if (nrow(A) != ncol(A) || any(!is.finite(A)) || !isSymmetric(A)) {
    stop("本教学函数只接受实对称方阵。")
  }
  if (max_iter < 1 || tol <= 0) {
    stop("max_iter 必须为正整数,tol 必须为正数。")
  }

  Ak <- A
  converged <- FALSE
  off_diagonal <- Inf

  for (iter in seq_len(max_iter)) {
    # QR 特征值迭代不能使用列主元,否则 RQ 不再与 Ak 相似。
    qr_A <- qr(Ak, LAPACK = FALSE, tol = 0)
    if (!identical(qr_A$pivot, seq_len(ncol(Ak)))) {
      stop("QR 分解发生列交换,无法保持相似变换。")
    }
    Q <- qr.Q(qr_A)
    R <- qr.R(qr_A)
    Ak <- R %*% Q

    off_diagonal <- sqrt(sum(Ak[lower.tri(Ak)]^2))
    if (off_diagonal <= tol * max(1, norm(Ak, type = "F"))) {
      converged <- TRUE
      break
    }
  }

  list(
    values = diag(Ak),
    iter = iter,
    off_diagonal = off_diagonal,
    converged = converged
  )
}

A_qr_eigen <- matrix(c(4, 1,
                       1, 3), nrow = 2, byrow = TRUE)
qr_eigen_result <- qr_eigen_symmetric(A_qr_eigen)

rbind(
  QR_iteration = sort(qr_eigen_result$values, decreasing = TRUE),
  eigen = sort(eigen(A_qr_eigen, symmetric = TRUE)$values,
               decreasing = TRUE)
)
#>               [,1]  [,2]
#> QR_iteration 4.618 2.382
#> eigen        4.618 2.382
c(
  iterations = qr_eigen_result$iter,
  off_diagonal = qr_eigen_result$off_diagonal,
  converged = qr_eigen_result$converged
)
#>   iterations off_diagonal    converged
#>    4.000e+01    4.361e-12    1.000e+00
这里的“QR 特征值迭代”和前面的“QR 最小二乘”使用同一种矩阵分解,却解决不同任务。这个例子选用实对称矩阵,因此迭代结果逐渐接近对角矩阵。实际数值软件会加入移位(shift)、Hessenberg 化等技巧;一般实矩阵还可能收敛到含 \(2\times2\) 块的实 Schur 形式。重要的是理解:现代矩阵计算依靠稳定的分解、残差和停止准则,而不是手工求特征多项式或固定迭代若干次。
4.7 链接网络中的排序:PageRank
PageRank 是特征向量思想在网络排序中的经典应用。它最初用于网页排序:如果一个网页被很多重要网页链接,那么这个网页也应该更重要。这个想法可以推广到很多网络问题中,例如企业供应链网络、投入产出网络、城市交通网络和学术引用网络。
基本思想
PageRank 可以理解为一种“加权投票”。网页上的超链接就是选票:如果页面 \(i\) 链接到 \(m\) 个页面,那么它把自己的重要性平均分给这 \(m\) 个页面,每个链接得到 \(1/m\) 的权重。重要页面投出的票,比不重要页面投出的票更有分量。
举例来说,假如有五个页面,它们之间的链接关系如图 4.4 所示。
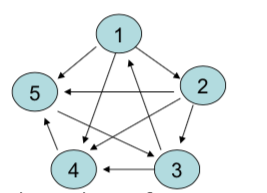
图4.4: 仅有五个页面的链接关系示例。
用邻接矩阵 \(\mathbf A\) 表示链接关系,矩阵第 \(i\) 行第 \(j\) 列为 1 表示页面 \(i\) 链接到页面 \(j\):
\[ \mathbf A=\left(\begin{array}{ccccc} 0 & 1 & 0 & 1 & 1 \\ 0 & 0 & 1 & 1 & 1 \\ 1 & 0 & 0 & 1 & 0 \\ 0 & 0 & 0 & 0 & 1 \\ 0 & 0 & 1 & 0 & 0 \end{array}\right). \]
把每一行除以该页面的出链数量,得到转移矩阵 \(\mathbf B\):
\[ \mathbf B=\left(\begin{array}{ccccc} 0 & 1/3 & 0 & 1/3 & 1/3 \\ 0 & 0 & 1/3 & 1/3 & 1/3 \\ 1/2 & 0 & 0 & 1/2 & 0 \\ 0 & 0 & 0 & 0 & 1 \\ 0 & 0 & 1 & 0 & 0 \end{array}\right). \]
设页面重要性得分为列向量
\[ \mathbf r=(r_1,r_2,r_3,r_4,r_5)^\top. \]
如果网页重要性已经达到稳定状态,那么一次链接转移以后,重要性分布不应改变,即
\[ \mathbf r=\mathbf B^\top\mathbf r. \]
因此,PageRank 得分 \(\mathbf r\) 就是 \(\mathbf B^\top\) 对应特征值 1 的特征向量。换句话说,网页排序问题被转化成了一个特征向量计算问题。
若某个页面没有任何出链,它对应的行和为 0,直接除以行和会产生 NaN。这类页面称为悬挂节点(dangling node)。构造转移矩阵时,必须先规定它下一步跳向何处;均匀 PageRank 通常把该行替换为\((1/N,\ldots,1/N)\)。这个修复发生在加入阻尼以前。
R 实现
make_transition <- function(A, personalization = NULL) {
  A <- as.matrix(A)
  if (nrow(A) != ncol(A) || any(!is.finite(A)) || any(A < 0)) {
    stop("A 必须是元素有限、非负的方阵。")
  }

  n <- nrow(A)
  if (is.null(personalization)) personalization <- rep(1 / n, n)
  if (length(personalization) != n ||
      any(!is.finite(personalization)) ||
      any(personalization < 0) || sum(personalization) <= 0) {
    stop("personalization 必须是长度正确的非负向量。")
  }
  personalization <- personalization / sum(personalization)

  out_degree <- rowSums(A)
  B <- matrix(0, nrow = n, ncol = n)
  active <- out_degree > 0
  if (any(active)) {
    B[active, ] <- sweep(
      A[active, , drop = FALSE], 1, out_degree[active], "/"
    )
  }
  if (any(!active)) {
    B[!active, ] <- matrix(
      personalization,
      nrow = sum(!active), ncol = n, byrow = TRUE
    )
  }

  B
}

A <- matrix(c(
  0, 1, 0, 1, 1,
  0, 0, 1, 1, 1,
  1, 0, 0, 1, 0,
  0, 0, 0, 0, 1,
  0, 0, 1, 0, 0
), nrow = 5, byrow = TRUE)

B <- make_transition(A)
stopifnot(max(abs(rowSums(B) - 1)) < 1e-14)

# 检查悬挂节点也能得到合法转移矩阵
A_dangling <- A
A_dangling[4, ] <- 0
B_dangling <- make_transition(A_dangling)
stopifnot(all(is.finite(B_dangling)))
stopifnot(max(abs(rowSums(B_dangling) - 1)) < 1e-14)

er <- eigen(t(B))
idx <- which.min(Mod(er$values - 1))
r <- Re(er$vectors[, idx])
if (sum(r) < 0) r <- -r
r <- r / sum(r)
names(r) <- paste0("page", 1:5)

round(r, 3)
#> page1 page2 page3 page4 page5
#> 0.150 0.050 0.300 0.217 0.283
sort(round(r, 3), decreasing = TRUE)
#> page3 page5 page4 page1 page2
#> 0.300 0.283 0.217 0.150 0.050
这里先构造行随机矩阵 \(\mathbf B\),再计算 \(\mathbf B^\top\) 的特征向量。得分越高,页面越重要。
从幂方法看 PageRank
如果从随机游走的角度看,PageRank 更容易理解。假设一个用户一开始随机进入五个网页之一,因此初始分布为
\[ \mathbf r_0=\left(\frac15,\frac15,\frac15,\frac15,\frac15\right)^\top. \]
用户每次都随机点击当前网页中的一个链接,则
\[ \mathbf r_1=\mathbf B^\top\mathbf r_0,\quad \mathbf r_2=\mathbf B^\top\mathbf r_1,\quad \ldots,\quad \mathbf r_k=\mathbf B^\top\mathbf r_{k-1}. \]
当 \(k\) 足够大时,\(\mathbf r_k\) 会接近稳定分布。这正是幂方法在 PageRank 中的具体形式。
pagerank_iterate <- function(B, alpha = 1,
                             personalization = NULL,
                             tol = 1e-12, max_iter = 1000) {
  B <- as.matrix(B)
  n <- nrow(B)
  if (n != ncol(B) || any(!is.finite(B)) || any(B < 0) ||
      max(abs(rowSums(B) - 1)) > 1e-10) {
    stop("B 必须是有限、非负的行随机方阵。")
  }
  if (alpha < 0 || alpha > 1) stop("alpha 必须在 [0, 1] 内。")
  if (max_iter < 1 || tol <= 0) {
    stop("max_iter 必须为正整数,tol 必须为正数。")
  }

  if (is.null(personalization)) personalization <- rep(1 / n, n)
  if (length(personalization) != n ||
      any(!is.finite(personalization)) ||
      any(personalization < 0) || sum(personalization) <= 0) {
    stop("personalization 必须是长度正确的非负向量。")
  }
  personalization <- personalization / sum(personalization)
  r_iter <- personalization
  converged <- FALSE
  fixed_point_residual <- Inf

  for (iter in seq_len(max_iter)) {
    r_next <- alpha * as.vector(t(B) %*% r_iter) +
      (1 - alpha) * personalization
    fixed_point_residual <- sum(abs(r_next - r_iter))
    r_iter <- r_next

    if (fixed_point_residual <= tol) {
      converged <- TRUE
      break
    }
  }

  list(
    score = r_iter / sum(r_iter),
    iter = iter,
    residual = fixed_point_residual,
    converged = converged
  )
}

page_rank_plain <- pagerank_iterate(B, alpha = 1)
round(page_rank_plain$score, 3)
#> [1] 0.150 0.050 0.300 0.217 0.283
c(
  iterations = page_rank_plain$iter,
  residual = page_rank_plain$residual,
  converged = page_rank_plain$converged,
  eigen_difference = max(abs(page_rank_plain$score - r))
)
#>       iterations         residual        converged eigen_difference
#> 1.520e+02 8.779e-13 1.000e+00 2.094e-13没有阻尼时,从任意初始分布收敛到唯一稳定分布还需要链不可约、非周期等条件。函数因此同时返回converged 和不动点残差,不能把达到 max_iter 当成收敛。
实际 PageRank 还会加入阻尼因子(damping factor)。它表示用户并不总是沿着链接点击,也可能随机跳转到任意页面。若阻尼因子为 \(\alpha\),常用形式为
\[ \mathbf G=\alpha\mathbf B+(1-\alpha)\frac{1}{N}\mathbf{1}\mathbf{1}^\top, \]
其中 \(N\) 是页面数,\(\mathbf{1}\) 是 \(N\) 维全 1 列向量,\(\mathbf{1}\mathbf{1}^\top/N\) 表示随机跳转到任意页面的概率矩阵,此时列向量得分满足\(\mathbf r=\mathbf G^\top\mathbf r\)。悬挂节点必须先在 \(\mathbf B\) 中修复;阻尼项进一步打破封闭小圈子和周期结构。当 \(0\leq\alpha<1\) 且跳转概率严格为正时,可以保证唯一的稳定分布。
alpha <- 0.85
n <- nrow(B)
G <- alpha * B + (1 - alpha) * matrix(1 / n, nrow = n, ncol = n)

page_rank_damped <- pagerank_iterate(B, alpha = alpha)
r_damped <- page_rank_damped$score

names(r_damped) <- paste0("page", 1:n)
round(r_damped, 3)
#> page1 page2 page3 page4 page5
#> 0.151 0.073 0.285 0.215 0.276
c(
  iterations = page_rank_damped$iter,
  residual = page_rank_damped$residual,
  converged = page_rank_damped$converged,
  row_sum_error_G = max(abs(rowSums(G) - 1)),
  probability_sum = sum(r_damped)
)
#>      iterations        residual       converged row_sum_error_G probability_sum
#>       7.900e+01       8.362e-13       1.000e+00       0.000e+00       1.000e+00
在真实互联网规模下,矩阵非常大且高度稀疏,不会真的把整个矩阵密集存储起来。核心计算仍然是反复做矩阵–向量乘法,但会使用稀疏矩阵存储、分布式计算和工程优化来完成。
4.8 文本的低秩表示:潜在语义分析
随着互联网文本快速增长,搜索系统需要从海量文档中找到与用户查询最相关的内容。最直接的方法是看查询词是否在文档中出现,但这种方法容易受到同义词、短文本和噪声词的影响。潜在语义分析(latent semantic analysis,LSA)提供了一个经典思路:先把文本集合表示成一个词语–文档矩阵,再用 SVD 提取低维语义结构,最后在低维空间中比较查询和文档的相似度。
LSA 的基本思路如下。
- 构造词语–文档矩阵 \(\mathbf A\),其中 \(A_{ij}\) 表示词语 \(i\) 在文档 \(j\) 中出现的频数或权重。
- 对 \(\mathbf A\) 做标准化或 TF–IDF 加权,降低高频但信息量有限的词的影响。
- 对加权矩阵做 SVD,并保留前 \(k\) 个奇异值和奇异向量。
- 把文档和查询都投影到这个 \(k\) 维空间中。
- 用余弦相似度衡量查询和文档的接近程度。
本节从 Hugging Face 上的中文短新闻标题数据 wyp/clue-tnews2 中选取一个小型标题快照。原始关键词几乎不在文档间重复,不适合演示“共同语义方向”;因此下面根据标题人工整理一组规范化分析词。这个处理只为构造可复现的教学矩阵,不代表真实搜索系统的分词与特征工程,也不把数据集标签输入 SVD。
url <- paste0(
  "https://datasets-server.huggingface.co/rows?",
  "dataset=wyp/clue-tnews&config=default&split=validation",
  "&offset=0&length=30"
)

hf_rows <- jsonlite::fromJSON(url)
数据准备
这里每一条新闻标题看作一个文档。数据中 sentence 是新闻标题,label_desc 只用于结果核对;真正进入矩阵的是人工规范化的 analysis_terms。这些词只根据标题内容整理,不使用类别标签。
tnews <- data.frame(
  id = c(
    "D02", "D17", "D05", "D11", "D18",
    "D03", "D06", "D19", "D07", "D08",
    "D10", "D14", "D15", "D09", "D12"
  ),
  label_desc = c(
    "military", "military", "tech", "tech", "tech",
    "finance", "finance", "finance", "house", "house",
    "house", "car", "car", "education", "education"
  ),
  sentence = c(
    "以色列大规模空袭开始!伊朗多个军事目标遭遇打击,誓言对等反击",
    "全球最大飞机墓地:6千架被埋葬的飞机,可随便装备一个军事强国",
    "图解:全要素 多领域 高效益 天津智能科技军民融合发展",
    "“你们的产品让人们越来越懒”——农行董事长为何如此评价?",
    "如何解读蚂蚁金服首季亏损?",
    "出栏一头猪亏损300元,究竟谁能笑到最后!",
    "区块链投资心得,能做到就不会亏钱",
    "为什么现在超市购物车要用硬币才能使用,之前都不用的呢,这背后有什么利益吗?",
    "你家拆迁,要钱还是要房?答案一目了然",
    "军嫂探亲拧包入住,部队家属临时来队房标准有了规定,全面落实!",
    "海口的限购区域有哪些?",
    "国产新力量,领克02这个价位你能接受?",
    "「曝光台」安塞区这些驾驶员,您的驾驶证违法未处理已经逾期未换证了,赶快去车管所办理相关业务去吧!(第十期)",
    "你好,武汉理工大学国旗仪仗队!",
    "美术生去北京画室参加集训会不会影响联考成绩?"
  ),
  analysis_terms = c(
    "军事 国际 安全 冲突 伊朗 以色列",
    "军事 国际 安全 飞机 美国 运输",
    "科技 制造 投资 智能 军事",
    "科技 金融 企业 产品 银行",
    "科技 金融 企业 贷款 互联网 投资",
    "经济 市场 价格 农业 成本",
    "金融 投资 市场 区块链 比特币 风险",
    "消费 零售 商场 服务 成本",
    "房产 住房 买房 房价 拆迁",
    "住房 家庭 房产 军事 服务",
    "房产 住房 买房 房价 海口 限购 二手房",
    "汽车 市场 价格 国产 消费",
    "汽车 交通 驾驶 安全 服务",
    "教育 大学 学生 学校",
    "教育 学生 学校 美术 考试"
  ),
  stringsAsFactors = FALSE
)

knitr::kable(
  tnews[, c("id", "label_desc", "sentence", "analysis_terms")]
)| id | label_desc | sentence | analysis_terms |
|---|---|---|---|
| D02 | military | 以色列大规模空袭开始!伊朗多个军事目标遭遇打击,誓言对等反击 | 军事 国际 安全 冲突 伊朗 以色列 |
| D17 | military | 全球最大飞机墓地:6千架被埋葬的飞机,可随便装备一个军事强国 | 军事 国际 安全 飞机 美国 运输 |
| D05 | tech | 图解:全要素 多领域 高效益 天津智能科技军民融合发展 | 科技 制造 投资 智能 军事 |
| D11 | tech | “你们的产品让人们越来越懒”——农行董事长为何如此评价? | 科技 金融 企业 产品 银行 |
| D18 | tech | 如何解读蚂蚁金服首季亏损? | 科技 金融 企业 贷款 互联网 投资 |
| D03 | finance | 出栏一头猪亏损300元,究竟谁能笑到最后! | 经济 市场 价格 农业 成本 |
| D06 | finance | 区块链投资心得,能做到就不会亏钱 | 金融 投资 市场 区块链 比特币 风险 |
| D19 | finance | 为什么现在超市购物车要用硬币才能使用,之前都不用的呢,这背后有什么利益吗? | 消费 零售 商场 服务 成本 |
| D07 | house | 你家拆迁,要钱还是要房?答案一目了然 | 房产 住房 买房 房价 拆迁 |
| D08 | house | 军嫂探亲拧包入住,部队家属临时来队房标准有了规定,全面落实! | 住房 家庭 房产 军事 服务 |
| D10 | house | 海口的限购区域有哪些? | 房产 住房 买房 房价 海口 限购 二手房 |
| D14 | car | 国产新力量,领克02这个价位你能接受? | 汽车 市场 价格 国产 消费 |
| D15 | car | 「曝光台」安塞区这些驾驶员,您的驾驶证违法未处理已经逾期未换证了,赶快去车管所办理相关业务去吧!(第十期) | 汽车 交通 驾驶 安全 服务 |
| D09 | education | 你好,武汉理工大学国旗仪仗队! | 教育 大学 学生 学校 |
| D12 | education | 美术生去北京画室参加集训会不会影响联考成绩? | 教育 学生 学校 美术 考试 |
构造词语–文档矩阵
下面把规范化分析词拆开,构造词语–文档矩阵。矩阵的行是词语,列是新闻标题。
split_terms <- function(x) {
  z <- unlist(strsplit(x, " ", fixed = TRUE))
  z <- trimws(z)
  z[nzchar(z)]
}

tokens <- lapply(tnews$analysis_terms, split_terms)
vocab <- sort(unique(unlist(tokens)))

tdm <- matrix(
  0,
  nrow = length(vocab),
  ncol = nrow(tnews),
  dimnames = list(vocab, tnews$id)
)

for (j in seq_along(tokens)) {
  tab <- table(tokens[[j]])
  tdm[names(tab), j] <- as.integer(tab)
}

dim(tdm)
#> [1] 50 15
tdm[1:8, 1:6]
#>        D02 D17 D05 D11 D18 D03
#> 买房     0   0   0   0   0   0
#> 二手房   0   0   0   0   0   0
#> 互联网   0   0   0   0   1   0
#> 交通     0   0   0   0   0   0
#> 产品     0   0   0   1   0   0
#> 以色列   1   0   0   0   0   0
#> 价格     0   0   0   0   0   1
#> 企业     0   0   0   1   1   0
在真实文本数据中,词语–文档矩阵通常非常稀疏:绝大多数词只出现在少数文档中。为了让更有区分度的词获得更高权重,常使用 TF–IDF 加权。这里的样本很小,但仍可以展示基本做法。
SVD 降维
对 TF–IDF 矩阵做 SVD:
\[ \mathbf A\approx\mathbf U_k\mathbf D_k\mathbf V_k^\top. \]
其中 \(\mathbf U_k\) 描述关键词方向,\(\mathbf D_k\mathbf V_k^\top\) 描述文档在低维语义空间中的坐标。
s_tnews <- svd(tdm_tfidf)
k <- 6

U_k <- s_tnews$u[, 1:k, drop = FALSE]
D_k <- diag(s_tnews$d[1:k], nrow = k)
V_k <- s_tnews$v[, 1:k, drop = FALSE]

doc_coord <- V_k %*% D_k
rownames(doc_coord) <- tnews$id

lsa_energy <- cumsum(s_tnews$d^2) / sum(s_tnews$d^2)
lsa_diagnostics <- data.frame(
  component = seq_len(min(10, length(s_tnews$d))),
  singular_value = s_tnews$d[seq_len(min(10, length(s_tnews$d)))],
  cumulative_energy = lsa_energy[seq_len(min(10, length(s_tnews$d)))]
)
knitr::kable(lsa_diagnostics, digits = 3)| component | singular_value | cumulative_energy |
|---|---|---|
| 1 | 8.879 | 0.132 |
| 2 | 8.558 | 0.255 |
| 3 | 8.169 | 0.366 |
| 4 | 7.713 | 0.466 |
| 5 | 7.592 | 0.563 |
| 6 | 6.425 | 0.632 |
| 7 | 5.902 | 0.690 |
| 8 | 5.717 | 0.745 |
| 9 | 5.404 | 0.794 |
| 10 | 5.334 | 0.841 |
前几个奇异值反映文本集合中最主要的共同变化方向。本例取 \(k=6\),兼顾压缩程度与检索结果的稳定性;它不是由某个普遍正确的阈值自动决定的。实际项目应同时检查累计能量和下游检索指标,并对 \(k\) 做验证。
查询与排序
假设用户查询的是“买房 房价 海口 二手房”。我们先把查询转化成与词语–文档矩阵相同长度的向量,然后投影到 SVD 得到的低维空间中:
make_query <- function(words, vocab, idf) {
  q <- numeric(length(vocab))
  names(q) <- vocab
  hit <- intersect(words, vocab)
  q[hit] <- 1
  q * idf
}

query_words <- c("买房", "房价", "海口", "二手房")
q <- make_query(query_words, vocab, idf)

query_coord <- matrix(q, nrow = 1) %*% U_k
round(query_coord, 3)
#>        [,1]  [,2]   [,3]   [,4] [,5]   [,6]
#> [1,] -3.347 1.459 -1.132 -0.185    0 -0.627

stopifnot(sqrt(sum(query_coord^2)) > 0)
这里文档坐标是 \(\mathbf V_k\mathbf D_k\),查询坐标必须使用同一尺度下的\(\mathbf q^\top\mathbf U_k\)。若把查询写成\(\mathbf q^\top\mathbf U_k\mathbf D_k^{-1}\),则文档应相应使用 \(\mathbf V_k\);混用两套坐标会产生没有意义的余弦相似度。
最后计算查询和各新闻标题在低维空间中的余弦相似度:
cosine <- function(a, b) {
  denom <- sqrt(sum(a^2)) * sqrt(sum(b^2))
  if (denom == 0) return(NA_real_)
  sum(a * b) / denom
}

scores <- apply(doc_coord, 1, function(z) {
  cosine(z, as.numeric(query_coord))
})
stopifnot(all(is.finite(scores)))

result <- data.frame(
  id = names(scores),
  score = as.numeric(scores),
  label_desc = tnews$label_desc[match(names(scores), tnews$id)],
  sentence = tnews$sentence[match(names(scores), tnews$id)],
  row.names = NULL
)

result <- result[order(result$score, decreasing = TRUE), ]
stopifnot(all(c("D07", "D08", "D10") %in% head(result$id, 3)))
knitr::kable(head(result, 6), digits = 3)| id | score | label_desc | sentence | |
|---|---|---|---|---|
| 11 | D10 | 0.997 | house | 海口的限购区域有哪些? |
| 9 | D07 | 0.992 | house | 你家拆迁,要钱还是要房?答案一目了然 |
| 10 | D08 | 0.676 | house | 军嫂探亲拧包入住,部队家属临时来队房标准有了规定,全面落实! |
| 7 | D06 | 0.079 | finance | 区块链投资心得,能做到就不会亏钱 |
| 6 | D03 | 0.011 | finance | 出栏一头猪亏损300元,究竟谁能笑到最后! |
| 3 | D05 | 0.007 | tech | 图解:全要素 多领域 高效益 天津智能科技军民融合发展 |
结果前列包含两个直接出现查询词的房产标题,也包含一个没有原查询词、但通过“住房—房产”等共同上下文进入相近潜在方向的标题。这个例子仍然很小,却包含了文本表示、稀疏矩阵、TF–IDF 加权、SVD 降维、查询折入和相似度排序等核心环节。断言的作用是防止数据或算法修改后悄悄产生 NA 或改变本例想展示的基本检索行为。
需要注意,LSA 不是现代搜索引擎的全部。真实系统通常还会使用更好的中文分词、停用词处理、倒排索引、点击反馈、机器学习排序模型,甚至深度学习语义向量。本例的人工词表也不能用于评价真实检索质量;它的作用是稳定地展示如何把非结构化文本转成矩阵,再用 SVD 提取共同结构。
4.9 进一步阅读
数值线性代数的系统内容可参见 Golub and Van Loan (2013);条件数、舍入误差和稳定性分析可参见Higham (2002);统计计算中矩阵分解、最小二乘和降维的进一步应用可参见Gentle (2009)。阅读软件文档时,应特别区分数学定义、教学实现和生产级算法:后者通常还包含列主元、移位、缩放、稀疏存储和错误处理。
4.10 本章小结
本章的核心不是记忆分解公式,而是依据统计任务和矩阵结构选择算法。一般线性系统应直接求解;对称正定系统可以使用 Cholesky;满列秩最小二乘优先使用 QR;秩亏或近似秩亏问题需要带主元 QR、SVD、数值秩和阈值诊断。显式求逆和正规方程虽然便于写在纸上,却通常不是可靠的默认实现。
特征分解描述方阵的关键方向,SVD 则适用于任意矩阵,并统一连接条件数、低秩近似、伪逆和 PCA。社会经济指标案例说明,PCA 可以概括共同变化,却不自动产生因果解释或价值判断。幂方法、QR 特征值迭代、PageRank、图像重构和 LSA 进一步展示了矩阵–向量乘法与低秩结构在网络、图像和文本中的用途。
贯穿全章的验证原则是:解线性系统要看相对残差,最小二乘要看残差正交性和数值秩,PCA 要报告方差贡献率与重构误差,迭代算法要返回残差和收敛状态。一个结果“没有报错”或“迭代了很多次”,都不能替代这些检查。
4.11 思考题
- 对下列四类任务分别选择一般线性求解、Cholesky、QR 或 SVD,并说明选择依据与主要诊断量:一般方阵线性系统、协方差矩阵线性系统、满列秩最小二乘和完全共线回归。为什么矩阵结构会影响算法选择?
- 为什么显式计算 \(\mathbf A^{-1}\mathbf b\) 通常不是求解 \(\mathbf A\mathbf x=\mathbf b\) 的默认方法?在线性回归中,为什么形成正规方程\(\mathbf X^\top\mathbf X\widehat{\boldsymbol\beta}=\mathbf X^\top\mathbf y\) 可能进一步放大病态性?
- 从薄 QR 分解 \(\mathbf X=\mathbf Q\mathbf R\) 出发,推导\(\mathbf R\widehat{\boldsymbol\beta}=\mathbf Q^\top\mathbf y\)。说明残差正交性\(\mathbf X^\top(\mathbf y-\mathbf X\widehat{\boldsymbol\beta})=\mathbf{0}\) 可以检验什么,又不能保证什么。
- 比较特征分解与奇异值分解的适用对象和几何含义。一般方阵在什么条件下可以使用正交的谱分解?奇异值又如何联系矩阵的秩、二范数条件数和最佳低秩近似?
- 区分精确秩、数值秩和标准二范数条件数。为什么秩亏矩阵的标准条件数应为无穷,而截断 SVD 得到的“有效条件数”需要单独命名并报告阈值?广义逆给出的最小范数解为什么不能自动解决参数不可识别问题?
- PCA 为什么经常需要标准化?主成分载荷、得分和方差贡献率分别表示什么?解释主成分符号的任意性,并说明为什么不能仅凭
state.x77的 PC1 将其命名为“发展指数”或作因果解释。 - 对迭代算法,为什么“相邻两次迭代变化很小”不能完全替代方程残差?分别说明初始向量与主特征向量正交、前两个特征值的模很接近,以及 QR 特征值迭代用于非对称矩阵时可能带来的问题。
- PageRank 中的悬挂节点为什么会破坏直接的行归一化?阻尼如何影响转移矩阵的不可约性、非周期性和稳定分布的唯一性?说明“分数和为 1”与“已经满足不动点方程”为什么是两项不同的检查。
- 低秩近似同时涉及存储量、重构误差和下游任务表现。说明为什么较大的秩不一定仍构成图像压缩,以及为什么 LSA 中的累计奇异值能量不能单独决定最合适的截断秩。
4.12 上机实验(Lab)
上机实验应形成可复核的计算证据。每份报告至少包括问题与目标、可运行代码、关键输出或图形、数值诊断以及对结果的解释;涉及随机计算时还应设置并报告随机数种子。
- Lab 1:Cholesky 求解与残差检查。 构造一个 \(4\times4\) 对称正定矩阵,用
chol()验证\(\mathbf A=\mathbf R^\top\mathbf R\),再通过两次三角求解计算\(\mathbf A\mathbf x=\mathbf b\)。报告相对残差,并与solve(A, b)的结果比较。随后把矩阵改为对称但非正定,记录chol()的行为并解释原因。 - Lab 2:病态最小二乘与数值秩。 使用
longley数据验证\(\kappa_2(\mathbf X^\top\mathbf X)=\kappa_2(\mathbf X)^2\),比较正规方程、QR 和lm.fit()的系数、拟合值、相对残差及残差正交性。再加入一个近似重复的解释变量,考察数值秩、系数和拟合值的变化,并说明为什么系数不稳定不一定意味着拟合值发生同等程度的变化。 - Lab 3:SVD、广义逆与最小范数解。 构造一个秩亏的 \(4\times3\) 矩阵,用
svd()验证\(\mathbf A=\mathbf U\mathbf D\mathbf V^\top\),并在至少三种阈值下计算数值秩和截断广义逆。检查四条 Penrose 条件;对一个欠定线性系统构造多个可行解,验证广义逆解的欧氏范数最小,并讨论结果对阈值的敏感性。 - Lab 4:社会经济指标的 PCA。 对
state.x77分别在原尺度和标准化尺度上进行 PCA,比较前两个主成分的方差贡献率、载荷与州得分图。用 SVD 复现标准化 PCA 的得分,并计算秩 2 重构误差。最后写一段不超过 200 字的结果说明,明确描述性结论、数据年代限制和不能作出的因果结论。 - Lab 5:特征值迭代的收敛诊断。 修改
power_method()的初始向量,使其与主特征向量正交,用eigen()核对所得特征对。再构造一个前两个特征值模非常接近的对称矩阵,比较幂法与 QR 迭代的迭代次数、特征值误差和残差;至少设计一个不收敛或不满足适用条件的反例。 - Lab 6:含悬挂节点的 PageRank。 在本章网络中增加一个没有出链的页面和一个二周期小圈子,完成悬挂节点修正并验证转移矩阵每行和为 1。比较 \(\alpha=1\)、\(0.85\) 和 \(0.5\) 时的收敛状态、稳定分布、迭代次数与不动点残差,解释阻尼参数变化带来的影响。
- 拓展 Lab 1:图像的低秩重构。 对本章 RGB 图像,在 \(k=32,116,200\) 下完成低秩重构,报告Frobenius 相对误差、因子存储量与原始数组存储量之比,并把重构图排在同一幅图中。说明为什么\(k=200\) 不是因子存储意义上的压缩,以及为什么 JPEG 文件大小不能直接验证这一存储公式。
- 拓展 Lab 2:LSA 截断秩与检索表现。 在 LSA 案例中分别取 \(k=4,6,8\),报告累计能量、查询得分是否全部有限及前 5 名结果。再把查询改为“金融 企业 贷款”和“军事 飞机 安全”,比较不同\(k\) 的排序,并说明为什么截断秩还需要依据下游检索表现进行验证。