第 17 章 MCMC 方法基础
第 10 章用独立随机样本近似积分和概率,第 16 章又把网格近似、Laplace 近似和重要性抽样用于后验计算。这些方法在低维问题中直观有效,但随着参数维数增加,直接抽样可能不可行,网格点数会迅速增长,重要性权重也可能集中在少数样本上。
马尔科夫链 Monte Carlo(Markov chain Monte Carlo,MCMC)通过一条具有目标平稳分布的随机链产生样本。链上的样本通常相关,却仍可用于近似目标分布下的期望、概率和分位数。MCMC 尤其适合后验分布只知道比例的情形:算法比较不同参数值的相对后验密度,不需要先求出边际似然。
17.1 学习目标
学完本章后,读者应当能够:
- 说明平稳分布、细致平衡和遍历性的作用;
- 实现 Metropolis–Hastings、随机游走 Metropolis 和 Gibbs 抽样;
- 根据目标分布的尺度与相关结构设计提议分布;
- 用接受率、轨迹图、自相关、有效样本量、Monte Carlo 标准误和多链比较检查计算质量;
- 区分烧入、预热、正式抽样和稀疏化,并给出可复现的 MCMC 报告。
17.2 马尔科夫链抽样的基本原理
17.2.1 从未归一化密度到遍历平均
设目标密度为 \(\pi(x)\),我们希望计算
\[ I=\operatorname{E}_\pi\{h(X)\}=\int h(x)\pi(x)\,dx. \]
若能生成 \(X^{(1)},\ldots,X^{(M)}\overset{\mathrm{iid}}{\sim}\pi\),则可用样本均值近似 \(I\)。困难在于,实际问题中常常只能计算未归一化密度 \(\widetilde\pi(x)\):
\[ \pi(x)=\frac{\widetilde\pi(x)}{Z},\qquad Z=\int \widetilde\pi(u)\,du. \]
在贝叶斯模型中,\(\widetilde\pi(\boldsymbol\theta)=p(\mathbf y\mid\boldsymbol\theta)p(\boldsymbol\theta)\),而 \(Z=p(\mathbf y)\) 往往是难以直接计算的边际似然。MCMC 构造的接受概率只包含密度比,常数 \(Z\) 会在比值中抵消。
常数抵消使后验抽样成为可能,但也意味着普通 MCMC 输出不会自动给出 \(Z\)。后验均值和概率可以由链上样本计算;第 19 章讨论边际似然在模型比较中的作用。桥抽样等边际似然计算方法需要额外理论,本书不展开。
MCMC 产生 \(X^{(1)},\ldots,X^{(M)}\) 后,仍使用
\[ \hat I_M=\frac{1}{M}\sum_{m=1}^M h\bigl(X^{(m)}\bigr) \]
估计 \(I\)。与独立 Monte Carlo 相比,估计量的形式没有改变,变化在于样本之间存在相关性。相关性不会自动造成偏差,但通常会增大 Monte Carlo 方差。因此,MCMC 的计算质量不能只用迭代次数判断。
| 方法 | 样本关系 | 设计中的主要困难 | 适用情形 |
|---|---|---|---|
| 直接抽样 | 独立 | 必须能从目标分布抽样 | 标准分布、共轭模型 |
| 拒绝抽样 | 独立 | 需要全局包络 | 低维、尾部容易控制的目标分布 |
| 重要性抽样 | 独立但带权 | 建议分布不合适时权重退化 | 低维积分、重复计算 |
| MCMC | 通常相关 | 需要设计转移并检查混合 | 高维或未归一化目标分布 |
上述表格指出了 MCMC 的交换:它放弃独立性,换取从复杂目标分布产生样本的可能性。接下来需要回答两个问题:怎样保证链长期服从目标分布,以及怎样保证一次有限长度的运行已经提供足够信息。前一个问题属于转移机制的正确性,后一个问题属于计算质量;二者不能混为一谈。
17.2.2 转移机制与平稳分布
随机序列 \(X^{(0)},X^{(1)},\ldots\) 若满足
\[ P\bigl(X^{(t+1)}\in A\mid X^{(t)},X^{(t-1)},\ldots,X^{(0)}\bigr) =P\bigl(X^{(t+1)}\in A\mid X^{(t)}\bigr), \]
就称为马尔科夫链。给定当前状态后,下一状态的条件分布由转移核 \(K(x,A)\) 描述。若分布 \(\pi\)满足
\[ \pi(A)=\int K(x,A)\,\pi(x)\,dx, \]
则 \(\pi\) 是这条链的平稳分布。换言之,如果 \(X^{(t)}\sim\pi\),经过一步转移后仍有\(X^{(t+1)}\sim\pi\)。
平稳性说明目标分布在转移下保持不变,但仅有平稳性还不够。一条链可能被困在状态空间的某个部分,也可能按固定周期往返。实际使用还要求链能够到达目标分布的各个重要区域,并逐渐淡化初始值的影响。
17.2.3 细致平衡与遍历平均
验证平稳分布的一种常用方法是检查细致平衡。对具有转移密度的链,如果
\[ \pi(x)K(y\mid x)=\pi(y)K(x\mid y), \]
则从 \(x\) 到 \(y\) 的概率流量与反向流量相等。对等式两边关于 \(x\) 积分即可得到平稳性。细致平衡是平稳性的充分条件,不是必要条件。
在不可约、非周期等适当条件下,马尔科夫链遍历定理给出
\[ \frac{1}{M}\sum_{m=1}^M h\bigl(X^{(m)}\bigr) \xrightarrow[M\to\infty]{\mathrm{a.s.}} \operatorname{E}_\pi\{h(X)\}. \]
这里的 \(\mathrm{a.s.}\) 表示几乎必然收敛;该结论还要求 \(h\) 对 \(\pi\) 可积以及链满足相应的遍历条件。“运行足够久”并不是一个可直接检查的数学条件。实践中需要结合多条链、轨迹、有效样本量和问题本身的结构判断近似是否可信。
这里还需要区分遍历定理中的长期性质与一次有限运行的初始化问题。链通常从人为指定的 \(X^{(0)}\) 出发。对转移核始终固定的基础链,正式汇总前为减弱初值影响而舍弃的早期迭代称为烧入期(burn-in)。现代自适应算法还会在正式抽样前调节步长、尺度或质量矩阵,这一阶段称为预热期(warmup)。预热样本通常也不进入后验汇总,但“调节算法”和“舍弃固定链的开头”是两个概念,本书据此区分两个术语。
烧入或预热的长度都不能只按固定比例决定;更重要的是从分散初始值运行多条链,观察它们是否进入相同的稳定区域。舍弃早期样本不能修复无法跨越模式、提议尺度严重失调或实现错误的链,正式样本仍需单独诊断。
17.3 Metropolis–Hastings 算法
17.3.1 提议与接受规则
设当前状态为 \(x^{(t)}\),从提议分布 \(q(x^\ast\mid x^{(t)})\) 生成候选值 \(x^\ast\)。Metropolis–Hastings接受概率为
\[ \alpha(x^{(t)},x^\ast) = \min\left\{ 1, \frac{\pi(x^\ast)q(x^{(t)}\mid x^\ast)} {\pi(x^{(t)})q(x^\ast\mid x^{(t)})} \right\}. \]
Metropolis–Hastings 算法
- 选择初始值 \(x^{(0)}\)。
- 对 \(t=0,1,\ldots,T-1\),从 \(q(x^\ast\mid x^{(t)})\) 生成候选值。
- 计算 \(\alpha(x^{(t)},x^\ast)\),再生成 \(U\sim\operatorname{Unif}(0,1)\)。
- 若 \(U\leq\alpha\),令 \(x^{(t+1)}=x^\ast\);否则令 \(x^{(t+1)}=x^{(t)}\)。
候选值被拒绝时,当前状态必须再次记入样本。重复值是转移机制的一部分,删除它们会改变抽样分布。
接受规则之所以成立,在于它校正了目标密度与正反向提议概率之间的不平衡。对 \(x\neq y\),链从 \(x\)移动到 \(y\) 的密度为 \(q(y\mid x)\alpha(x,y)\)。将接受概率代入可得
\[ \begin{aligned} \pi(x)q(y\mid x)\alpha(x,y) &=\min\{\pi(x)q(y\mid x),\ \pi(y)q(x\mid y)\}\\ &=\pi(y)q(x\mid y)\alpha(y,x). \end{aligned} \]
因此移动部分满足细致平衡;拒绝候选值产生的自转移概率也保持同样的平衡关系。目标分布 \(\pi\)由此成为该链的平稳分布。若目标密度写成 \(\pi(x)=\widetilde\pi(x)/Z\),常数 \(Z\) 在接受比中抵消。
17.3.2 对数尺度上的随机游走实现
若提议写成
\[ x^\ast=x^{(t)}+\varepsilon,\qquad \varepsilon\sim g, \]
且 \(g(\varepsilon)=g(-\varepsilon)\),则正反向提议密度相同,接受概率简化为
\[ \alpha=\min\left\{1,\frac{\pi(x^\ast)}{\pi(x^{(t)})}\right\}. \]
程序应在对数尺度上比较接受比,避免密度乘积上溢或下溢。下面的函数还保留当前状态的对数密度,避免每次迭代重复计算。
rw_metropolis_1d <- function(x0, n_iter, proposal_sd, log_target) {
  stopifnot(length(x0) == 1L, n_iter >= 2L, proposal_sd > 0)

  samples <- numeric(n_iter)
  samples[1] <- x0
  accepted <- logical(n_iter - 1L)
  current_lp <- log_target(x0)

  if (!is.finite(current_lp)) {
    stop("初始值必须位于目标分布的支持集内。")
  }

  for (t in 2:n_iter) {
    proposal <- rnorm(1, mean = samples[t - 1L], sd = proposal_sd)
    proposal_lp <- log_target(proposal)

    if (is.finite(proposal_lp) &&
        log(runif(1)) < min(0, proposal_lp - current_lp)) {
      samples[t] <- proposal
      current_lp <- proposal_lp
      accepted[t - 1L] <- TRUE
    } else {
      samples[t] <- samples[t - 1L]
    }
  }

  list(samples = samples, accept_rate = mean(accepted))
}

# 自由度为 4 的 t 分布,省略与 x 无关的归一化常数
log_target_t4 <- function(x) -2.5 * log1p(x^2 / 4)

set.seed(1201)
fit_t4 <- rw_metropolis_1d(
  x0 = 8,
  n_iter = 12000,
  proposal_sd = 3,
  log_target = log_target_t4
)

burnin_t4 <- 2000
draw_t4 <- fit_t4$samples[(burnin_t4 + 1L):12000]
这里选用 \(t_4\) 分布,是因为它的理论矩和分位数已知,可以直接检查程序,而算法本身只使用未归一化对数密度。
t4_summary <- rbind(
  theory = c(
    mean = 0,
    sd = sqrt(2),
    q025 = qt(0.025, df = 4),
    q975 = qt(0.975, df = 4)
  ),
  mcmc = c(
    mean = mean(draw_t4),
    sd = sd(draw_t4),
    q025 = unname(quantile(draw_t4, 0.025)),
    q975 = unname(quantile(draw_t4, 0.975))
  )
)

knitr::kable(t4_summary, digits = 3,
caption = "随机游走 Metropolis 与理论量的比较")| mean | sd | q025 | q975 | |
|---|---|---|---|---|
| theory | 0.000 | 1.414 | -2.776 | 2.776 |
| mcmc | -0.004 | 1.403 | -2.738 | 2.844 |
old_par <- par(no.readonly = TRUE)
par(mfrow = c(1, 2), family = "sans")

plot(fit_t4$samples, type = "l", xlab = "迭代次数", ylab = "x",
     main = "轨迹图")
abline(v = burnin_t4, col = "#D55E00", lty = 2)

hist(draw_t4, breaks = 45, freq = FALSE, border = "white",
     col = "gray85", xlab = "x", main = "MCMC 样本")
curve(dt(x, df = 4), from = -7, to = 7, add = TRUE,
      col = "#0072B2", lwd = 2)

invisible(par(old_par))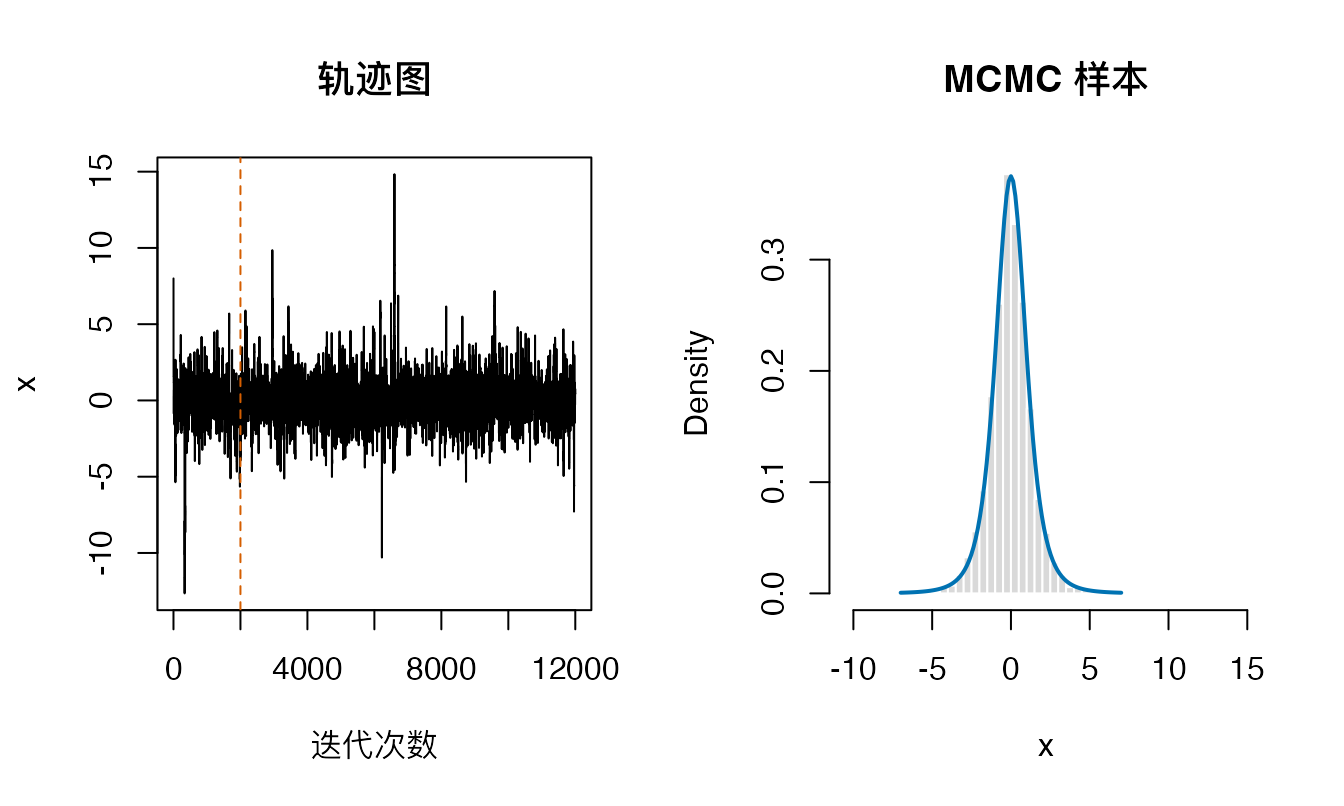
图17.1: 从偏离中心的初始值出发抽取自由度为 4 的 Student–t 分布。
轨迹图用于观察链随迭代的移动,直方图则检查保留样本的边际分布。二者作用不同,不能相互替代。
17.3.3 非对称提议不能省略 Hastings 校正
随机游走提议只有在正反向密度相等时,接受概率才能简化为目标密度之比。若在正参数 \(x>0\) 上采用乘法随机游走
\[ \log x^\ast=\log x^{(t)}+\varepsilon, \qquad \varepsilon\sim N(0,\sigma_q^2), \]
则 \(x^\ast\mid x^{(t)}\) 是对数正态分布。虽然 \(\varepsilon\) 的分布对称,\(x\) 尺度的提议密度并不对称:
\[ \frac{q(x^{(t)}\mid x^\ast)}{q(x^\ast\mid x^{(t)})} =\frac{x^\ast}{x^{(t)}}. \]
下面以形状参数为 3、率参数为 2 的 Gamma 目标分布为例,保留完整的 Hastings 校正项。
mh_lognormal_rw <- function(x0, n_iter, proposal_log_sd, log_target) {
  stopifnot(x0 > 0, n_iter >= 2L, proposal_log_sd > 0)

  samples <- numeric(n_iter)
  samples[1L] <- x0
  accepted <- logical(n_iter - 1L)
  current_lp <- log_target(x0)

  for (t in 2:n_iter) {
    current <- samples[t - 1L]
    proposal <- rlnorm(
      1L, meanlog = log(current), sdlog = proposal_log_sd
    )
    proposal_lp <- log_target(proposal)

    log_q_reverse <- dlnorm(
      current, meanlog = log(proposal),
      sdlog = proposal_log_sd, log = TRUE
    )
    log_q_forward <- dlnorm(
      proposal, meanlog = log(current),
      sdlog = proposal_log_sd, log = TRUE
    )
    log_alpha <- proposal_lp - current_lp +
      log_q_reverse - log_q_forward

    if (is.finite(log_alpha) && log(runif(1L)) < min(0, log_alpha)) {
      samples[t] <- proposal
      current_lp <- proposal_lp
      accepted[t - 1L] <- TRUE
    } else {
      samples[t] <- current
    }
  }

  list(samples = samples, accept_rate = mean(accepted))
}

log_target_gamma <- function(x) {
  if (x <= 0) return(-Inf)
  dgamma(x, shape = 3, rate = 2, log = TRUE)
}

set.seed(1205)
fit_gamma <- mh_lognormal_rw(
  x0 = 0.2, n_iter = 30000,
  proposal_log_sd = 0.8, log_target = log_target_gamma
)
draw_gamma <- fit_gamma$samples[5001:30000]

gamma_check <- rbind(
  theory = c(
    mean = 3 / 2,
    sd = sqrt(3) / 2,
    q025 = qgamma(0.025, shape = 3, rate = 2),
    q975 = qgamma(0.975, shape = 3, rate = 2)
  ),
  mcmc = c(
    mean = mean(draw_gamma),
    sd = sd(draw_gamma),
    q025 = unname(quantile(draw_gamma, 0.025)),
    q975 = unname(quantile(draw_gamma, 0.975))
  )
)

knitr::kable(
  gamma_check, digits = 3,
  caption = "非对称提议的 MH 抽样与 Gamma 理论量比较"
)| mean | sd | q025 | q975 | |
|---|---|---|---|---|
| theory | 1.500 | 0.866 | 0.309 | 3.612 |
| mcmc | 1.491 | 0.858 | 0.322 | 3.634 |
同一算法也可在 \(\eta=\log x\) 尺度上理解:此时随机游走是对称的,但变换后的目标密度为\(\pi_\eta(\eta)=\pi_x(e^\eta)e^\eta\)。目标密度中的 Jacobian 与 \(x\) 尺度上的 Hastings 校正给出相同的接受概率。一个常见错误是既在变换后的目标中加入 Jacobian,又保留不该出现的校正项,从而重复校正。
17.4 随机游走的效率与后验几何
17.4.1 接受率与移动距离
随机游走的提议标准差控制单步移动尺度。步长很小时,大部分候选值都会被接受,但链移动缓慢;步长很大时,候选值常落入低密度区域,链因拒绝而长时间停在原处。接受率过高或过低都可能对应低效率。
下面比较三个提议尺度。为排除初值差异,三条链都从 \(x^{(0)}=8\) 出发,并保留相同长度的正式样本。
mcmc_ess <- function(x, max_lag = 1000L) {
  x <- as.numeric(x)
  n <- length(x)
  if (n < 4L || !is.finite(var(x)) || var(x) == 0) {
    return(NA_real_)
  }

  lag_max <- min(as.integer(max_lag), n - 1L)
  rho <- as.numeric(acf(x, plot = FALSE, lag.max = lag_max)$acf)[-1L]
  n_pair <- floor(length(rho) / 2L)
  if (n_pair == 0L) {
    return(n)
  }

  pair_sum <- rho[2L * seq_len(n_pair) - 1L] +
    rho[2L * seq_len(n_pair)]
  first_nonpositive <- which(pair_sum <= 0)[1]
  if (!is.na(first_nonpositive)) {
    pair_sum <- pair_sum[seq_len(first_nonpositive - 1L)]
  }

  tau <- 1 + 2 * sum(pair_sum)
  min(n, n / max(tau, 1))
}

proposal_grid <- c(0.15, 3, 30)
set.seed(1202)
tuning_fits <- lapply(
  proposal_grid,
  function(s) rw_metropolis_1d(8, 12000, s, log_target_t4)
)
tuning_draws <- lapply(
  tuning_fits,
  function(f) f$samples[(burnin_t4 + 1L):12000]
)

tuning_ess <- vapply(tuning_draws, mcmc_ess, numeric(1))
tuning_table <- data.frame(
  proposal_sd = proposal_grid,
  accept_rate = vapply(tuning_fits, `[[`, numeric(1), "accept_rate"),
  mean = vapply(tuning_draws, mean, numeric(1)),
  ess = tuning_ess,
  mcse_mean = vapply(tuning_draws, sd, numeric(1)) / sqrt(tuning_ess)
)

knitr::kable(tuning_table, digits = 3,
caption = "提议尺度、接受率与抽样效率")| proposal_sd | accept_rate | mean | ess | mcse_mean |
|---|---|---|---|---|
| 0.15 | 0.956 | 0.047 | 25.47 | 0.221 |
| 3.00 | 0.425 | 0.011 | 1667.03 | 0.034 |
| 30.00 | 0.052 | -0.074 | 490.69 | 0.061 |
old_par <- par(no.readonly = TRUE)
par(mfrow = c(3, 2), mar = c(3.5, 4, 2, 1), family = "sans")

for (i in seq_along(proposal_grid)) {
  plot(tuning_fits[[i]]$samples[1:3000], type = "l",
       xlab = "迭代次数", ylab = "x",
       main = paste0("提议标准差 = ", proposal_grid[i]))
  acf(tuning_draws[[i]], lag.max = 40,
      xlab = "滞后阶数", ylab = "自相关", main = "")
}

invisible(par(old_par))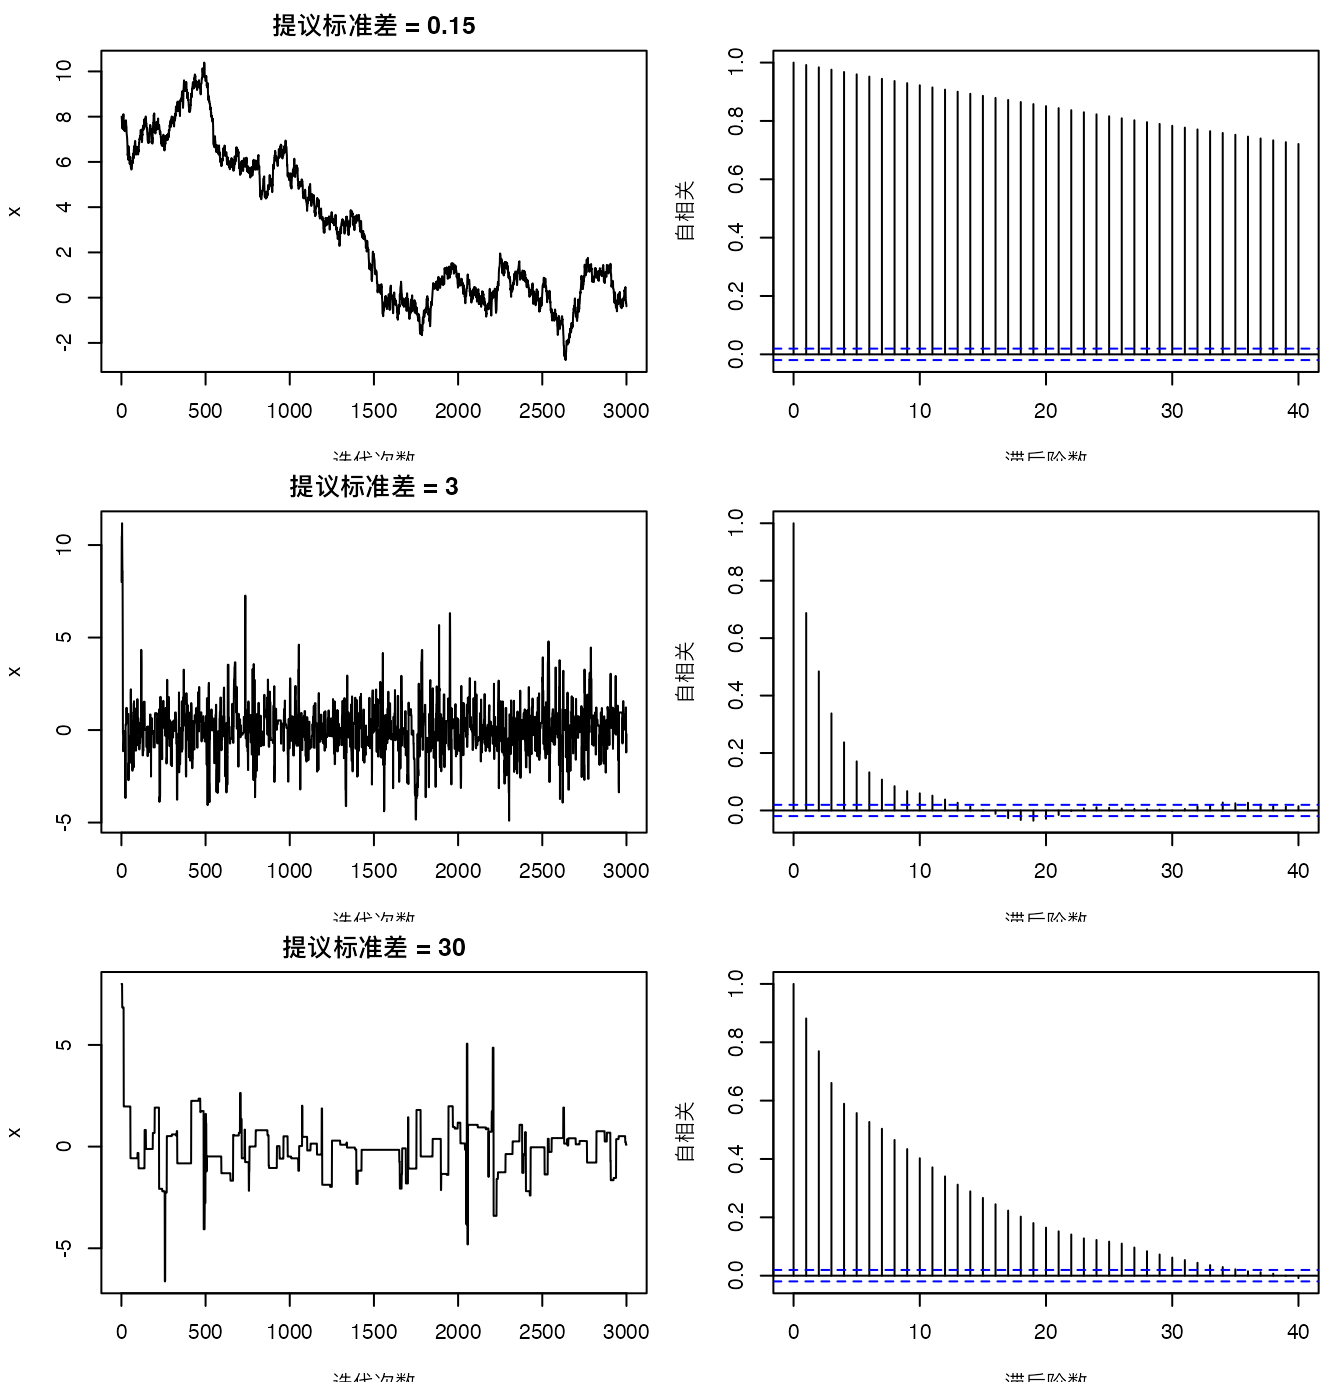
图17.2: 不同提议尺度下的轨迹与自相关。
不存在适用于所有问题的理想接受率。常见经验值来自特定目标分布和渐近条件,只能作为调节起点。最终应比较有效样本量、Monte Carlo 标准误以及单位运行时间内的有效样本数。
提议尺度的选择还牵涉一个容易忽视的原则:调节与正式抽样必须分开。尺度过大或过小,通常需要在独立的试运行或预热阶段根据接受情况和样本协方差调节。调节会使转移机制随迭代改变,因而不能不加说明地把所有预热样本当作来自一条固定的马尔科夫链。上面的比较让每条链始终使用一个固定尺度;若据此选择正式算法的尺度,这些试运行只承担调节作用,选定尺度后应另行生成正式样本。
更一般的自适应 MCMC 可以在满足特定条件时保留适应过程,但其正确性需要额外理论。使用 Stan 等成熟软件时,应区分软件用于步长和几何调节的预热与调节结束后的正式抽样;自行编写基础 MH程序时,不宜一边查看正式样本,一边反复修改提议,再把修改前后的样本直接合并。
17.4.2 有效样本量与 Monte Carlo 标准误
设平稳链上 \(h\bigl(X^{(t)}\bigr)\) 的滞后 \(k\) 自相关为 \(\rho_k\),并记\(\sigma_h^2=\operatorname{Var}_\pi\{h(X)\}\)。在适当条件下,样本均值的方差近似为
\[ \operatorname{Var}(\hat I_M) \approx \frac{\sigma_h^2}{M} \left(1+2\sum_{k=1}^{\infty}\rho_k\right). \]
括号中的量称为积分自相关时间。相应的有效样本量为
\[ M_{\mathrm{ESS}} = \frac{M}{1+2\sum_{k=1}^{\infty}\rho_k}, \]
样本均值的 Monte Carlo 标准误可估计为
\[ \widehat{\operatorname{MCSE}}(\hat I_M) \approx \frac{s_h}{\sqrt{M_{\mathrm{ESS}}}}. \]
其中 \(s_h\) 是链上 \(h\bigl(X^{(t)}\bigr)\) 的样本标准差;实际计算中的 \(M_{\mathrm{ESS}}\) 也需由有限链估计。ESS 衡量相关样本所包含的独立信息量,MCSE 则直接说明数值近似有多精确。后验标准差描述参数不确定性,MCSE 描述有限次 MCMC 迭代引入的计算误差,二者不能混为一谈。本章的 mcmc_ess() 用初始正序列作教学演示;正式分析宜采用成熟软件提供的多链 ESS 估计。
ESS 和 MCSE 都依赖所研究的函数 \(h\)。估计 \(P(\theta>c\mid\mathbf y)\) 时,应对指标序列\(\mathbb I\{\theta^{(t)}>c\}\) 检查有效样本量;参数本身的 ESS 很高,并不保证极端尾部概率同样精确。分位数的MCSE 也需要专门方法。正式报告时,应让 MCSE 小到不会影响保留位数或实质结论,而不是机械追求某个固定迭代次数。
是否稀疏化也应由信息量而不是样本外观决定。稀疏化(thinning)每隔若干次迭代只保留一个样本,可以减少文件大小,却通常不会在给定计算时间下增加信息量。若存储不是限制,应保留全部正式样本,让 ESS 和 MCSE 反映真实相关性。遇到高自相关时,优先改进参数化、提议分布或算法,而不是简单删除样本。
17.4.3 多维目标中的尺度与方向
对 \(d\) 维状态 \(\mathbf x\),对称正态随机游走可写成
\[ \mathbf x^\ast=\mathbf x^{(t)}+\boldsymbol\varepsilon, \qquad \boldsymbol\varepsilon\sim N_d(\mathbf 0,\boldsymbol\Sigma_q). \]
\(\boldsymbol\Sigma_q\) 同时决定各参数方向的步长和联合移动方向。若目标分布高度相关,而提议仍沿坐标轴作等尺度移动,链会在狭长区域中反复碰壁。适当标准化参数,或让 \(\boldsymbol\Sigma_q\) 近似目标分布的协方差结构,通常能够明显改善混合。
log_mvn <- function(x, mean, Sigma) {
  x <- as.matrix(x)
  if (ncol(x) != length(mean)) {
    x <- matrix(x, ncol = length(mean))
  }

  centered <- sweep(x, 2, mean)
  R <- chol(Sigma)
  standardized <- t(backsolve(R, t(centered), transpose = TRUE))

  -0.5 * ncol(x) * log(2 * pi) - sum(log(diag(R))) -
    0.5 * rowSums(standardized^2)
}
rw_metropolis_vec <- function(x0, n_iter, proposal_chol, log_target) {
p <- length(x0)
stopifnot(n_iter >= 2L,
identical(dim(proposal_chol), c(p, p)))
samples <- matrix(NA_real_, n_iter, p)
samples[1, ] <- x0
accepted <- logical(n_iter - 1L)
current_lp <- as.numeric(log_target(x0))
if (length(current_lp) != 1L || !is.finite(current_lp)) {
stop("初始值必须位于目标分布的支持集内。")
}
for (t in 2:n_iter) {
current <- samples[t - 1L, ]
step <- as.numeric(rnorm(p) %*% proposal_chol)
proposal <- current + step
proposal_lp <- as.numeric(log_target(proposal))
if (length(proposal_lp) == 1L && is.finite(proposal_lp) &&
log(runif(1)) < min(0, proposal_lp - current_lp)) {
samples[t, ] <- proposal
current_lp <- proposal_lp
accepted[t - 1L] <- TRUE
} else {
samples[t, ] <- current
}
}
list(samples = samples, accept_rate = mean(accepted))
}下面把目标分布设为相关系数 \(0.97\) 的二维标准正态分布。直接抽样当然更简单,这里使用已知目标分布是为了把算法误差与模型误差分开,并准确比较两种提议。
Sigma_target <- matrix(c(1, 0.97, 0.97, 1), 2, 2)
log_target_2d <- function(x) log_mvn(x, c(0, 0), Sigma_target)

proposal_iso <- diag(0.25, 2)
proposal_matched <- chol((2.38^2 / 2) * Sigma_target)

set.seed(1203)
fit_iso <- rw_metropolis_vec(
  c(0, 0), 15000, proposal_iso, log_target_2d
)
fit_matched <- rw_metropolis_vec(
  c(0, 0), 15000, proposal_matched, log_target_2d
)

burnin_2d <- 3000
post_iso <- fit_iso$samples[(burnin_2d + 1L):15000, ]
post_matched <- fit_matched$samples[(burnin_2d + 1L):15000, ]

geometry_table <- data.frame(
  proposal = c("各向同性", "匹配相关结构"),
  accept_rate = c(fit_iso$accept_rate, fit_matched$accept_rate),
  min_ess = c(
    min(apply(post_iso, 2, mcmc_ess)),
    min(apply(post_matched, 2, mcmc_ess))
  )
)

knitr::kable(geometry_table, digits = 3,
caption = "二维目标分布下的提议分布比较")| proposal | accept_rate | min_ess |
|---|---|---|
| 各向同性 | 0.591 | 95.16 |
| 匹配相关结构 | 0.355 | 1495.75 |
x_grid <- seq(-3.5, 3.5, length.out = 90)
y_grid <- seq(-3.5, 3.5, length.out = 90)
grid_2d <- expand.grid(x = x_grid, y = y_grid)
z_grid <- matrix(
  exp(log_target_2d(as.matrix(grid_2d))),
  nrow = length(x_grid), ncol = length(y_grid)
)

old_par <- par(no.readonly = TRUE)
par(mfrow = c(1, 2), mar = c(4, 4, 2, 1), family = "sans")

for (item in list(
  list(draw = post_iso, title = "各向同性提议"),
  list(draw = post_matched, title = "结构匹配提议")
)) {
  contour(x_grid, y_grid, z_grid, drawlabels = FALSE,
          xlab = expression(x[1]), ylab = expression(x[2]),
          main = item$title)
  lines(item$draw[1:1200, 1], item$draw[1:1200, 2],
        col = "#D55E00AA")
}

invisible(par(old_par))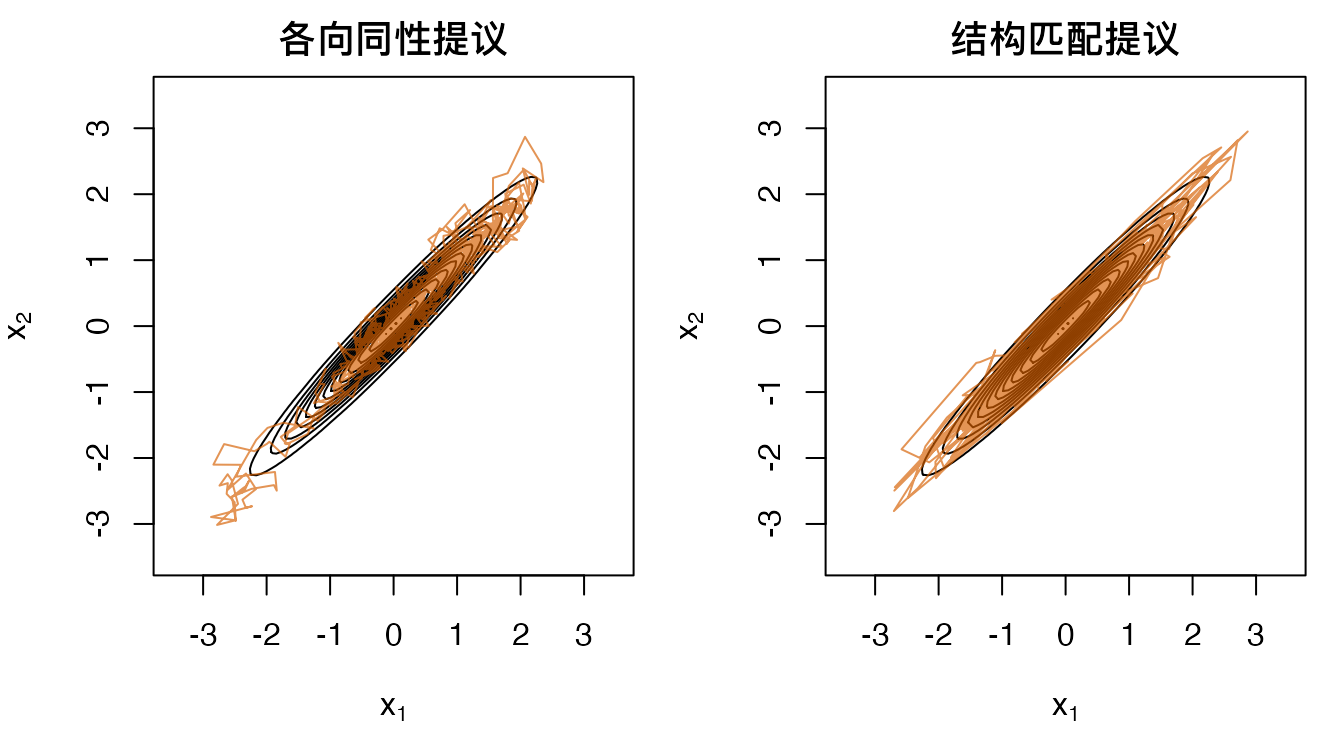
图17.3: 各向同性提议与结构匹配提议的移动轨迹。
两条链的平稳分布相同,区别只在计算效率。结构匹配提议沿目标分布的长轴和短轴按不同尺度移动,因此能用更少的相关迭代覆盖相同区域。真实问题中目标协方差未知,可由预热样本、Laplace 近似或模型结构提供初步尺度;正式抽样阶段应固定已经确定的提议机制。
17.5 Gibbs 抽样与分块更新
随机游走 MH 试图在整个参数空间中提出一次联合移动;维数增加或参数高度相关时,这种提议往往很难调节。Gibbs 抽样采取另一条路线:利用模型的条件结构,把一个高维抽样问题拆成若干较容易的低维问题。它没有消除后验相关性,而是把相关性显式放进每一步的条件分布。
17.5.1 完整条件分布与 Gibbs 更新
设目标分布为 \(\pi(x_1,\ldots,x_d)\),并且每个完整条件分布
\[ \pi(x_j\mid x_{-j}) \]
都容易抽样,其中 \(x_{-j}\) 表示除 \(x_j\) 外的其他分量。Gibbs 抽样依次从这些条件分布更新各分量。二维情形的一轮更新为
\[ X^{(t+1)}\sim\pi(x\mid Y^{(t)}),\qquad Y^{(t+1)}\sim\pi(y\mid X^{(t+1)}). \]
第二步必须使用刚生成的 \(X^{(t+1)}\)。若误用 \(X^{(t)}\),得到的是另一种并行更新机制,不能直接沿用顺序 Gibbs 抽样的结论。
Gibbs 更新也可以看作一种特殊的 MH 更新。固定 \(y\),用 \(\pi(x\mid y)\) 作为更新 \(x\) 的提议分布,则
\[ \begin{aligned} \alpha &=\min\left\{1, \frac{\pi(x^\ast,y)\pi(x^{(t)}\mid y)} {\pi(x^{(t)},y)\pi(x^\ast\mid y)} \right\}\\ &=1. \end{aligned} \]
因此 Gibbs 候选值总被接受。它不需要调节随机游走步长,但要求完整条件分布能够直接抽样。接受率为1 也不代表样本独立;参数高度相关时,逐坐标更新仍可能产生很强的自相关。
17.5.2 二维正态示例
令 \(\mathbf Z=(X,Y)^\top\),且 \(\lvert\rho\rvert<1\)。若
\[ \mathbf Z\sim N_2(\mathbf 0,\boldsymbol\Sigma), \qquad \boldsymbol\Sigma= \begin{pmatrix}1&\rho\\ \rho&1\end{pmatrix}, \]
则
\[ X\mid Y=y\sim N(\rho y,1-\rho^2),\qquad Y\mid X=x\sim N(\rho x,1-\rho^2). \]
gibbs_bvn <- function(n_iter, rho, x0 = c(0, 0)) {
  stopifnot(n_iter >= 2L, abs(rho) < 1, length(x0) == 2L)

  xy <- matrix(NA_real_, n_iter, 2)
  xy[1, ] <- x0
  conditional_sd <- sqrt(1 - rho^2)

  for (t in 2:n_iter) {
    xy[t, 1] <- rnorm(
      1, mean = rho * xy[t - 1L, 2], sd = conditional_sd
    )
    xy[t, 2] <- rnorm(
      1, mean = rho * xy[t, 1], sd = conditional_sd
    )
  }

  colnames(xy) <- c("x", "y")
  xy
}

set.seed(1204)
rho_gibbs <- 0.9
draw_gibbs <- gibbs_bvn(8000, rho_gibbs, x0 = c(-3, 3))
post_gibbs <- draw_gibbs[1001:8000, ]

gibbs_check <- rbind(
  theory = c(mean_x = 0, mean_y = 0, sd_x = 1, sd_y = 1,
             correlation = rho_gibbs),
  mcmc = c(colMeans(post_gibbs), apply(post_gibbs, 2, sd),
           cor(post_gibbs[, 1], post_gibbs[, 2]))
)

knitr::kable(gibbs_check, digits = 3,
caption = "二维正态 Gibbs 抽样的数值检查")| mean_x | mean_y | sd_x | sd_y | correlation | |
|---|---|---|---|---|---|
| theory | 0.000 | 0.00 | 1 | 1.000 | 0.9 |
| mcmc | 0.028 | 0.03 | 1 | 0.996 | 0.9 |
old_par <- par(no.readonly = TRUE)
par(family = "sans")

plot(post_gibbs[1:2500, 1], post_gibbs[1:2500, 2],
     pch = 20, col = "#0072B244", xlab = "x", ylab = "y", asp = 1)
theta <- seq(0, 2 * pi, length.out = 240)
Sigma_gibbs <- matrix(c(1, rho_gibbs, rho_gibbs, 1), 2, 2)
ellipse <- cbind(cos(theta), sin(theta)) %*% chol(Sigma_gibbs) *
  sqrt(qchisq(0.80, df = 2))
lines(ellipse, col = "#D55E00", lwd = 2)

invisible(par(old_par))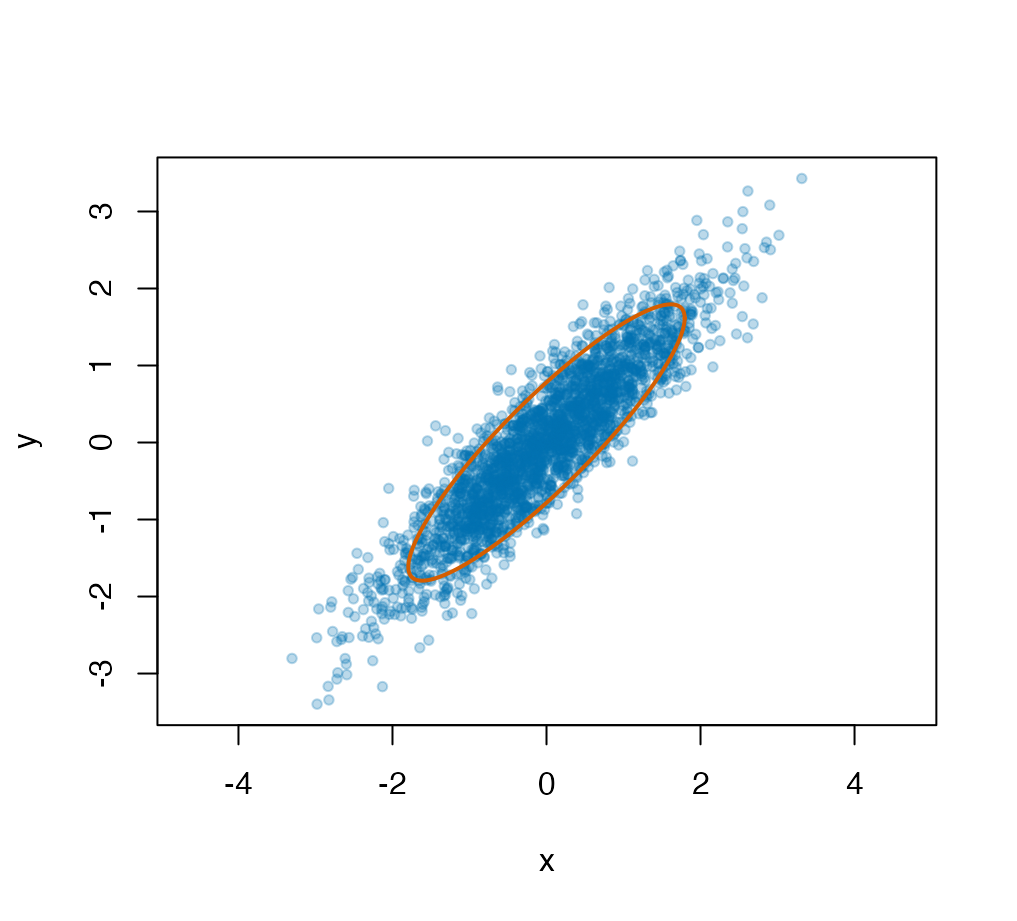
图17.4: 二维正态分布的 Gibbs 抽样结果。
完整条件分布并不总能直接抽样。如果某个条件分布只知道未归一化形式,或没有方便的随机数生成器,可以在该分量的更新中执行一次 Metropolis–Hastings 步骤。这称为 Metropolis within Gibbs。一次迭代可以同时包含直接 Gibbs更新和 MH 更新,每一步都应以其余参数的最新取值为条件。
分块方式会影响效率。高度相关的参数若能联合更新,通常优于逐个更新;但分块过大又会增加提议分布的设计难度。分块策略应依据条件分布形式和参数相关结构确定,而不是只按参数在程序中的排列顺序划分。
17.6 收敛与计算质量诊断
转移核以目标分布为平稳分布,是算法层面的性质;某一次有限长度运行是否已经充分探索目标分布,则是计算层面的问题。细致平衡证明不能代替收敛诊断,诊断良好也不能修正写错的对数密度。实际分析应先用可核验的目标分布测试实现,再只对固定调节参数后的正式样本进行多链诊断;预热样本不应混入\(\widehat R\)、ESS 或后验摘要。
17.6.1 多链比较与秩标准化 \(\widehat R\)
单条链的轨迹看似稳定,并不能证明已经探索全部目标区域。通常从分散初始值运行多条独立链,比较链内波动与链间差异。分裂 \(\widehat R\) 先把每条链分成前后两半;若链的前半段和后半段分布不同,分裂操作也会把这种非平稳性转化为链间差异。
设每条分裂链有 \(n\) 个样本,共有 \(m\) 条分裂链。记链内方差均值为 \(W\),链均值之间的方差乘以\(n\) 为 \(B\),则
\[ \widehat V^+ =\frac{n-1}{n}W+\frac{1}{n}B, \qquad \widehat R=\sqrt{\frac{\widehat V^+}{W}}. \]
现代诊断通常先对合并样本做秩正态化,以减弱重尾和异常值的影响;再对围绕中位数折叠后的样本重复计算,以发现各链尺度不同而中心相近的情形。下面的教学函数返回这两个 \(\widehat R\) 的较大值。
split_chains <- function(chains) {
  chains <- as.matrix(chains)
  n <- nrow(chains)
  m <- ncol(chains)
  half <- floor(n / 2L)

  if (m < 2L || half < 2L) {
    stop("至少需要两条链,且每条链至少包含四个样本。")
  }

  do.call(
    cbind,
    lapply(seq_len(m), function(j) {
      cbind(chains[seq_len(half), j],
            chains[(n - half + 1L):n, j])
    })
  )
}

basic_rhat <- function(split_draws) {
  split_draws <- as.matrix(split_draws)
  n <- nrow(split_draws)
  W <- mean(apply(split_draws, 2, var))
  B <- n * var(colMeans(split_draws))

  if (!is.finite(W) || W <= 0) return(NA_real_)

  var_plus <- (n - 1) / n * W + B / n
  sqrt(var_plus / W)
}

rank_normalize <- function(x) {
  r <- rank(x, ties.method = "average")
  qnorm((r - 3 / 8) / (length(r) + 1 / 4))
}

rank_folded_rhat <- function(chains) {
  split_draws <- split_chains(chains)
  n <- nrow(split_draws)

  z <- matrix(
    rank_normalize(as.vector(split_draws)), nrow = n
  )
  folded <- abs(split_draws - median(split_draws))
  z_folded <- matrix(
    rank_normalize(as.vector(folded)), nrow = n
  )

  rhat_values <- c(basic_rhat(z), basic_rhat(z_folded))
  if (all(is.na(rhat_values))) return(NA_real_)
  max(rhat_values, na.rm = TRUE)
}
initial_t4 <- c(-10, -2, 2, 10)
seed_t4 <- 1210:1213
good_fits <- Map(
function(x0, seed) {
set.seed(seed)
rw_metropolis_1d(x0, 10000, 3, log_target_t4)
},
initial_t4, seed_t4
)
good_chains <- do.call(
cbind,
lapply(good_fits, function(f) f$samples[2001:10000])
)
good_ess <- sum(apply(good_chains, 2, mcmc_ess))
good_diagnostic <- data.frame(
rank_folded_rhat = rank_folded_rhat(good_chains),
total_ess = good_ess,
mcse_mean = sd(as.numeric(good_chains)) / sqrt(good_ess)
)
knitr::kable(good_diagnostic, digits = 3,
caption = "四条自由度为 4 的 Student--t 链的基本诊断")| rank_folded_rhat | total_ess | mcse_mean |
|---|---|---|
| 1.001 | 4300 | 0.022 |
接近 1 的 \(\widehat R\) 表示链间与链内波动相容。实际工作中常把 1.01 作为需要进一步调查的起点,而不是“通过检验”的界线。\(\widehat R\) 接近 1 是必要条件之一,不能单独作为收敛证明,也不能说明ESS 已经足够。成熟软件还会分别报告 bulk ESS 和 tail ESS;本章函数的目的在于展示计算逻辑,不能替代经过充分测试的诊断软件。
17.6.2 多峰分布中的假收敛
考虑两个相距很远的正态分布组成的等权混合分布。使用较小的随机游走步长时,从左右两个峰出发的链都可能在各自峰内稳定移动,却几乎不发生跨峰跳转。
log_add_exp <- function(a, b) {
  m <- pmax(a, b)
  m + log(exp(a - m) + exp(b - m))
}

log_target_far_mix <- function(x) {
  a <- log(0.5) + dnorm(x, -6, 1, log = TRUE)
  b <- log(0.5) + dnorm(x, 6, 1, log = TRUE)
  log_add_exp(a, b)
}

set.seed(1220)
fit_left <- rw_metropolis_1d(-6, 8000, 0.8, log_target_far_mix)
set.seed(1221)
fit_right <- rw_metropolis_1d(6, 8000, 0.8, log_target_far_mix)

stuck_chains <- cbind(
  left = fit_left$samples[1001:8000],
  right = fit_right$samples[1001:8000]
)

stuck_table <- data.frame(
  chain = c("左峰初值", "右峰初值"),
  mean = colMeans(stuck_chains),
  accept_rate = c(fit_left$accept_rate, fit_right$accept_rate)
)

knitr::kable(stuck_table, digits = 3,
caption = "被困在不同模式的两条链")| chain | mean | accept_rate | |
|---|---|---|---|
| left | 左峰初值 | -5.989 | 0.755 |
| right | 右峰初值 | 5.953 | 0.755 |
stuck_diagnostic <- data.frame(
  rank_folded_rhat = rank_folded_rhat(stuck_chains)
)

knitr::kable(stuck_diagnostic, digits = 3,
caption = "两条未跨越模式的链间诊断")| rank_folded_rhat |
|---|
| 1.828 |
old_par <- par(no.readonly = TRUE)
par(mfrow = c(2, 1), mar = c(3.5, 4, 2, 1), family = "sans")

matplot(stuck_chains[1:2500, ], type = "l", lty = 1,
        col = c("#0072B2", "#D55E00"), xlab = "迭代次数",
        ylab = "x", main = "轨迹图")
legend("right", legend = colnames(stuck_chains),
       col = c("#0072B2", "#D55E00"), lty = 1, bty = "n")

plot(density(stuck_chains[, 1]), col = "#0072B2", lwd = 2,
     xlim = c(-10, 10), xlab = "x", main = "模式内密度")
lines(density(stuck_chains[, 2]), col = "#D55E00", lwd = 2)

invisible(par(old_par))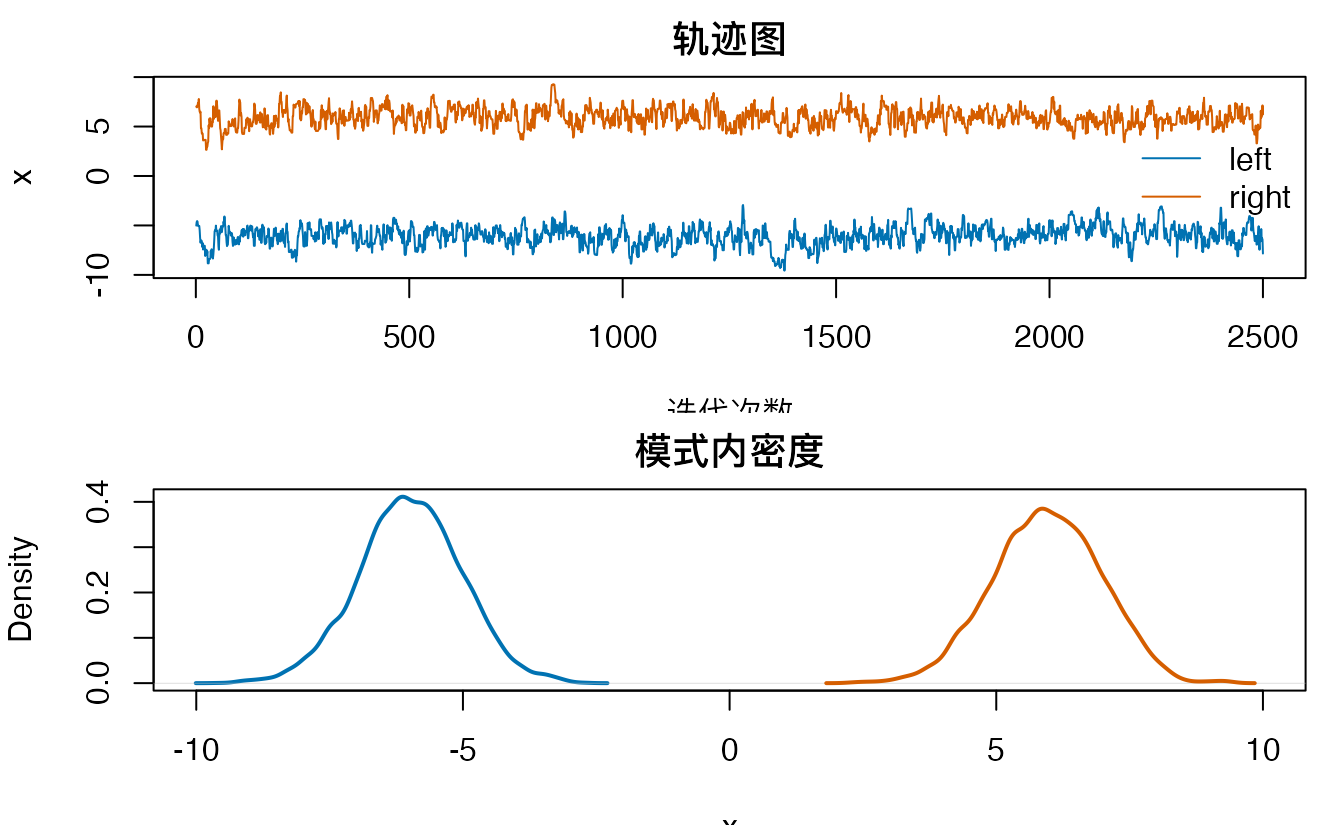
图17.5: 两条链分别停留在混合分布的不同模式。
两条链各自都有较高接受率和平稳外观,但合并结果取决于人为设置了几条左链和右链。此时应重新设计提议分布、使用跨模式更新或更适合复杂几何的算法,不能仅靠延长同一条局部随机游走链解决问题。
把前面的原理落实到一次实际分析中,至少应保留下列诊断证据。
| 检查内容 | 主要问题 | 常见信号 | 可采取的措施 |
|---|---|---|---|
| 多条链的轨迹 | 是否探索同一区域 | 链均值长期分离、趋势未消失 | 改变初值、重新评估烧入或预热、检查模式 |
| 接受率与跳跃距离 | 提议尺度是否失调 | 几乎不动或大量重复 | 调整尺度或协方差结构 |
| 自相关、ESS | 独立信息量是否足够 | 自相关衰减慢、ESS 很小 | 重参数化、改进提议或算法 |
| MCSE | 数值精度是否足够 | MCSE 影响报告位数或结论 | 增加有效样本量 |
| 秩标准化 \(\widehat R\) | 链间结果是否一致 | 明显大于 1 | 查找未混合、趋势或不同模式 |
| 支持集与结果范围 | 程序和模型是否一致 | 概率越界、方差为负 | 检查变换、对数密度和代码 |
诊断应针对最终要报告的参数和派生量进行。某些系数的链混合良好,并不保证尾部概率、极端分位数或参数组合也具有足够的有效样本量。
17.7 综合案例:银行客户认购率比较
17.7.1 数据问题与模型
UCI Bank Marketing 数据记录了葡萄牙一家银行的电话营销活动。本书使用较小的data/bank_marketing.csv 样本,共 4521 条记录。数据说明见 UCI Bank Marketing 数据页。本节比较两类客户的认购率:上一轮营销是否有成功记录。为使重点停留在抽样算法,本节把数据压缩为两个二项计数;多变量贝叶斯回归留到下一章。这个二维问题也能用数值积分处理,这里采用 MCMC 是为了完整演示多链抽样、诊断和后验变换的工作流程。
bank <- read.csv("data/bank_marketing.csv", sep = ";")
bank$subscribe <- as.integer(bank$y == "yes")
bank$prior_success <- bank$poutcome == "success"

group_levels <- c(FALSE, TRUE)
group_n <- vapply(
  group_levels,
  function(g) sum(bank$prior_success == g),
  numeric(1)
)
group_y <- vapply(
  group_levels,
  function(g) sum(bank$subscribe[bank$prior_success == g]),
  numeric(1)
)

bank_group <- data.frame(
  group = c("上一轮无成功记录", "上一轮有成功记录"),
  contacts = group_n,
  subscribers = group_y,
  sample_rate = group_y / group_n
)

knitr::kable(bank_group, digits = 3,
caption = "按上一轮营销结果分组的样本认购率")| group | contacts | subscribers | sample_rate |
|---|---|---|---|
| 上一轮无成功记录 | 4392 | 438 | 0.100 |
| 上一轮有成功记录 | 129 | 83 | 0.643 |
记第 \(g\) 组认购人数的随机变量为 \(Y_g\),观测人数为 \(y_g\),接触人数为 \(n_g\)。采用
\[ Y_g\mid p_g\overset{\mathrm{ind}}{\sim}\operatorname{Binomial}(n_g,p_g),\qquad \eta_g=\operatorname{logit}(p_g),\qquad \eta_g\sim N(0,2.5^2), \]
其中 \(g=0\) 表示没有成功记录,\(g=1\) 表示有成功记录。正态先验放在对数赔率尺度上,使参数可以在整个实数轴上随机游走。未归一化对数后验为
\[ \log\widetilde\pi(\eta_0,\eta_1) = \sum_{g=0}^1 \{y_g\eta_g-n_g\log(1+e^{\eta_g})\} -\frac{1}{2(2.5)^2}\sum_{g=0}^1\eta_g^2. \]
17.7.2 多链抽样与诊断
log(1 + exp(eta)) 在 \(\eta\) 很大时可能上溢。恒等式\(\max(\eta,0)+\log\{1+\exp(-\lvert\eta\rvert)\}\) 给出稳定计算。
log1pexp <- function(x) pmax(x, 0) + log1p(exp(-abs(x)))

log_posterior_bank <- function(eta) {
  loglik <- sum(group_y * eta - group_n * log1pexp(eta))
  logprior <- sum(dnorm(eta, mean = 0, sd = 2.5, log = TRUE))
  loglik + logprior
}
bank_initials <- rbind(
c(-4, -1),
c(-2, 0),
c(0, 2),
c(2, 4)
)
bank_proposal_chol <- diag(c(0.08, 0.30))
bank_fits <- lapply(seq_len(nrow(bank_initials)), function(j) {
set.seed(1230 + j)
rw_metropolis_vec(
x0 = bank_initials[j, ],
n_iter = 12000,
proposal_chol = bank_proposal_chol,
log_target = log_posterior_bank
)
})
bank_post <- lapply(
bank_fits,
function(f) f$samples[2001:12000, , drop = FALSE]
)
bank_chain_table <- data.frame(
chain = seq_along(bank_fits),
accept_rate = vapply(bank_fits, `[[`, numeric(1), "accept_rate")
)
knitr::kable(bank_chain_table, digits = 3,
caption = "银行案例四条链的接受率")| chain | accept_rate |
|---|---|
| 1 | 0.377 |
| 2 | 0.372 |
| 3 | 0.361 |
| 4 | 0.370 |
下面分别对 \(\eta_0\) 和 \(\eta_1\) 计算多链诊断。各链 ESS 的和可看作独立运行多条链时总有效样本量的近似。
bank_parameter_chains <- lapply(seq_len(2), function(j) {
  do.call(cbind, lapply(bank_post, function(x) x[, j]))
})

bank_ess <- vapply(
  bank_parameter_chains,
  function(x) sum(apply(x, 2, mcmc_ess)),
  numeric(1)
)

bank_diagnostic_table <- data.frame(
  parameter = c("eta_0", "eta_1"),
  rank_folded_rhat = vapply(
    bank_parameter_chains, rank_folded_rhat, numeric(1)
  ),
  total_ess = bank_ess,
  mcse_mean = vapply(
    bank_parameter_chains,
    function(x) sd(as.numeric(x)),
    numeric(1)
  ) / sqrt(bank_ess)
)

knitr::kable(bank_diagnostic_table, digits = 3,
caption = "银行案例的多链诊断")| parameter | rank_folded_rhat | total_ess | mcse_mean |
|---|---|---|---|
| eta_0 | 1.001 | 4716 | 0.001 |
| eta_1 | 1.001 | 5326 | 0.003 |
old_par <- par(no.readonly = TRUE)
par(mfrow = c(2, 1), mar = c(3.5, 4, 2, 1), family = "sans")
chain_colors <- c("#0072B2", "#D55E00", "#009E73", "#CC79A7")

for (j in seq_len(2)) {
  matplot(bank_parameter_chains[[j]][1:3000, ], type = "l",
          lty = 1, col = chain_colors, xlab = "迭代次数",
          ylab = paste0("eta_", j - 1L),
          main = paste0("Parameter eta_", j - 1L))
}

invisible(par(old_par))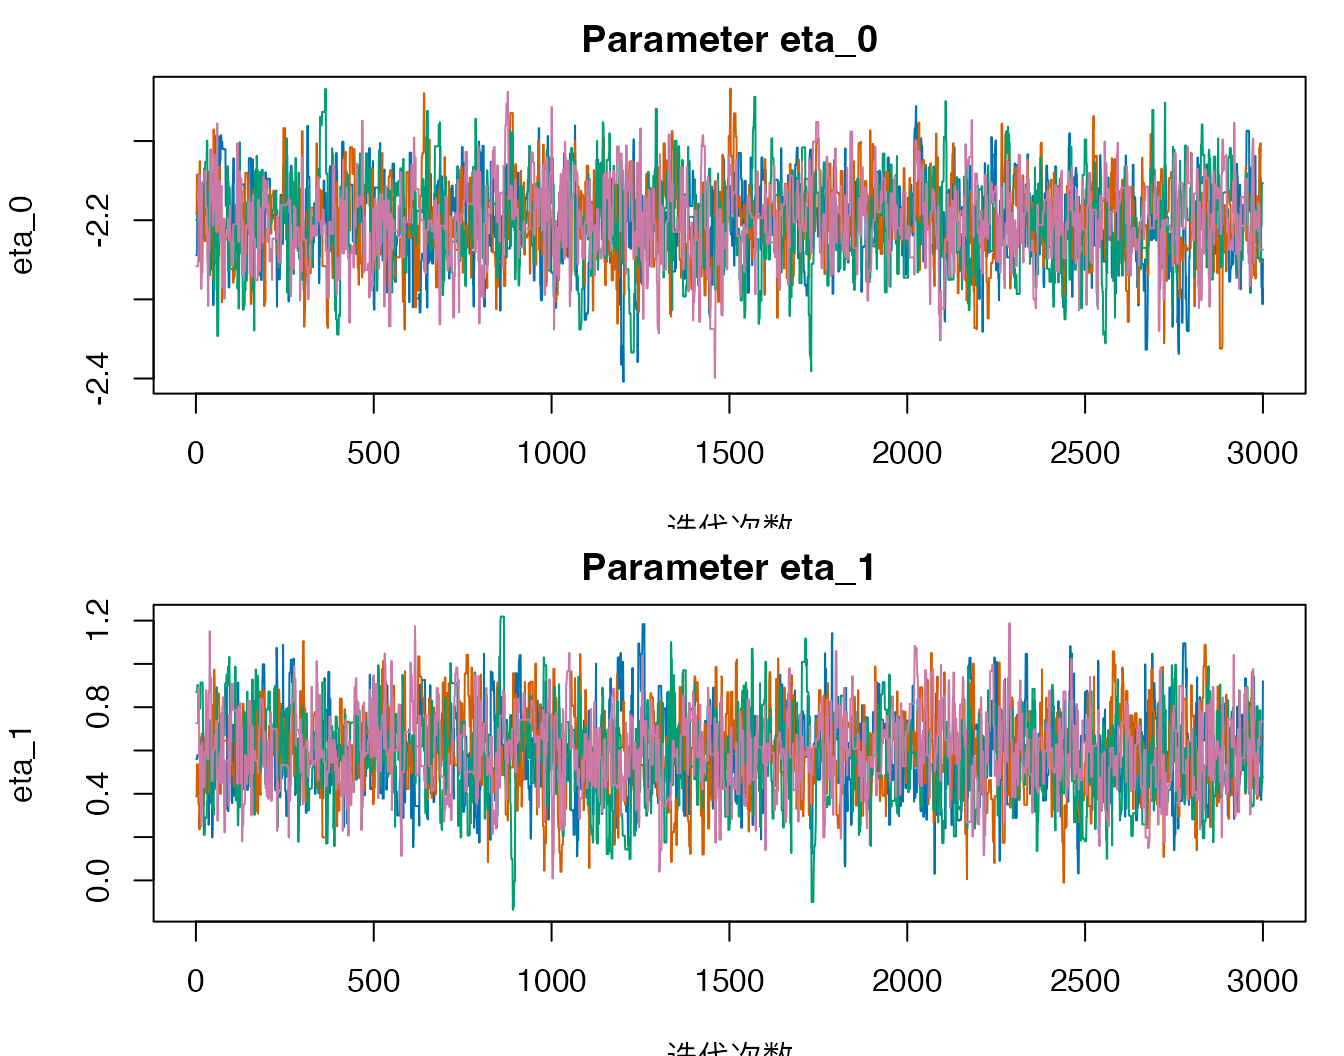
图17.6: 银行案例四条链的正式样本轨迹。
17.7.3 后验比较
把对数赔率参数变换回概率尺度,并计算认购率差与赔率比。由于这些量是每次后验抽样的函数,不需要另行运行 MCMC。
transform_bank_draws <- function(eta) {
  p_no_success <- plogis(eta[, 1])
  p_success <- plogis(eta[, 2])
  cbind(
    p_no_success = p_no_success,
    p_success = p_success,
    rate_difference = p_success - p_no_success,
    odds_ratio = exp(eta[, 2] - eta[, 1])
  )
}

bank_derived_by_chain <- lapply(bank_post, transform_bank_draws)
bank_derived <- do.call(rbind, bank_derived_by_chain)
p_no_success <- bank_derived[, "p_no_success"]
p_success <- bank_derived[, "p_success"]

summarize_posterior <- function(x) {
  c(
    mean = mean(x),
    sd = sd(x),
    q025 = unname(quantile(x, 0.025)),
    median = median(x),
    q975 = unname(quantile(x, 0.975))
  )
}

bank_posterior_table <- t(apply(bank_derived, 2, summarize_posterior))
rownames(bank_posterior_table) <- c(
  "无成功记录组认购率",
  "有成功记录组认购率",
  "认购率差",
  "赔率比"
)

knitr::kable(bank_posterior_table, digits = 3,
caption = "分组认购率及其差异的后验摘要")| mean | sd | q025 | median | q975 | |
|---|---|---|---|---|---|
| 无成功记录组认购率 | 0.100 | 0.005 | 0.091 | 0.100 | 0.109 |
| 有成功记录组认购率 | 0.642 | 0.042 | 0.558 | 0.643 | 0.723 |
| 认购率差 | 0.543 | 0.043 | 0.458 | 0.543 | 0.624 |
| 赔率比 | 16.615 | 3.236 | 11.233 | 16.308 | 23.856 |
诊断也要作用在最终报告的派生量上。非线性变换可能改变自相关和尾部行为,因此不能因为\(\eta_0,\eta_1\) 的诊断良好,就直接假定赔率比具有同样的计算精度。
bank_derived_chains <- lapply(seq_len(ncol(bank_derived)), function(j) {
  do.call(cbind, lapply(bank_derived_by_chain, function(x) x[, j]))
})

bank_derived_ess <- vapply(
  bank_derived_chains,
  function(x) sum(apply(x, 2, mcmc_ess)),
  numeric(1)
)

bank_derived_diagnostics <- data.frame(
  quantity = c("无成功记录组认购率", "有成功记录组认购率",
               "认购率差", "赔率比"),
  rank_folded_rhat = vapply(
    bank_derived_chains, rank_folded_rhat, numeric(1)
  ),
  total_ess = bank_derived_ess,
  mcse_mean = vapply(
    bank_derived_chains, function(x) sd(as.numeric(x)), numeric(1)
  ) / sqrt(bank_derived_ess)
)

knitr::kable(
  bank_derived_diagnostics, digits = 4,
  caption = "银行案例派生量的多链诊断"
)| quantity | rank_folded_rhat | total_ess | mcse_mean |
|---|---|---|---|
| 无成功记录组认购率 | 1.001 | 4742 | 0.0001 |
| 有成功记录组认购率 | 1.001 | 5347 | 0.0006 |
| 认购率差 | 1.001 | 5350 | 0.0006 |
| 赔率比 | 1.001 | 5253 | 0.0447 |
本例的两组似然和先验相互独立,所以每个 \(\eta_g\) 的边际后验都是一维的。可以用第16 章的网格法得到高精度参照,检查 MCMC 实现和摘要程序。这样的参照在复杂模型中往往不可得,但在教学例子和程序单元测试中很有价值。下面采用等距网格,因此公共步长在权重归一化时抵消;同时检查端点的对数密度,避免把截断严重的网格误当作基准。
weighted_quantile_grid <- function(x, w, probs) {
  ord <- order(x)
  x <- x[ord]
  w <- w[ord]
  w <- w / sum(w)
  cw <- cumsum(w)
  vapply(probs, function(p) x[which(cw >= p)[1L]], numeric(1))
}

bank_grid_marginal <- function(successes, trials) {
  eta <- seq(-10, 5, length.out = 30001)
  log_kernel <- successes * eta - trials * log1pexp(eta) +
    dnorm(eta, mean = 0, sd = 2.5, log = TRUE)
  endpoint_gap <- max(log_kernel[c(1L, length(log_kernel))]) -
    max(log_kernel)
  stopifnot(endpoint_gap < -20)
  w <- exp(log_kernel - max(log_kernel))
  w <- w / sum(w)
  p <- plogis(eta)

  c(
    mean = sum(w * p),
    q025 = weighted_quantile_grid(p, w, 0.025),
    q975 = weighted_quantile_grid(p, w, 0.975)
  )
}

bank_grid_reference <- t(vapply(
  seq_len(2),
  function(g) bank_grid_marginal(group_y[g], group_n[g]),
  numeric(3)
))

bank_reference_check <- data.frame(
  quantity = c("无成功记录组认购率", "有成功记录组认购率"),
  grid_mean = bank_grid_reference[, "mean"],
  mcmc_mean = bank_posterior_table[1:2, "mean"],
  grid_q025 = bank_grid_reference[, "q025"],
  mcmc_q025 = bank_posterior_table[1:2, "q025"],
  grid_q975 = bank_grid_reference[, "q975"],
  mcmc_q975 = bank_posterior_table[1:2, "q975"]
)

knitr::kable(
  bank_reference_check, digits = 4,
  caption = "MCMC 边际摘要与一维网格参照的比较"
)| quantity | grid_mean | mcmc_mean | grid_q025 | mcmc_q025 | grid_q975 | mcmc_q975 | |
|---|---|---|---|---|---|---|---|
| 无成功记录组认购率 | 无成功记录组认购率 | 0.0998 | 0.0997 | 0.0911 | 0.0910 | 0.1089 | 0.1087 |
| 有成功记录组认购率 | 有成功记录组认购率 | 0.6427 | 0.6424 | 0.5586 | 0.5575 | 0.7226 | 0.7229 |
bank_probability <- data.frame(
  quantity = c(
    "P(有成功记录组认购率更高 | 数据)",
    "每接触 100 人的后验平均预期认购人数差"
  ),
  value = c(
    mean(p_success > p_no_success),
    100 * mean(p_success - p_no_success)
  )
)

knitr::kable(bank_probability, digits = 3,
caption = "由后验样本得到的决策相关量")| quantity | value |
|---|---|
| P(有成功记录组认购率更高 | 数据) | 1.00 |
| 每接触 100 人的后验平均预期认购人数差 | 54.26 |
两组后验分布的差异反映的是历史营销结果与本轮认购之间的统计关联。客户构成、接触方式和营销策略可能同时影响分组与认购,因此不能把该差异解释为上一轮成功记录对本轮认购的因果效应。下一章将在贝叶斯回归中讨论如何同时纳入多个解释变量。
17.8 从算法输出到可信结论
MCMC 结果的核验有明确次序。后一层建立在前一层已经合理的基础上;例如,增加 ESS 不能挽救写错的目标密度,\(\widehat R\) 接近 1 也不能证明所有链共同遗漏的另一个模式不存在。
| 层次 | 首要问题 | 应保留的证据 |
|---|---|---|
| 目标分布 | 支持集、对数密度和 Jacobian 是否正确 | 解析结果、网格结果或人工输入测试 |
| 转移机制 | 提议比、接受规则和条件更新是否实现正确 | 已知目标分布上的模拟核验 |
| 状态空间探索 | 分散初值的链是否到达相同区域 | 多链轨迹、秩标准化 \(\widehat R\)、模式占比 |
| 数值精度 | 最终报告量是否有足够独立信息 | 相应函数的 ESS 与 MCSE |
| 实质解释 | 后验量是否回答原研究问题 | 参数定义、派生量计算和模型限制 |
据此,一个完整分析先写出未归一化对数密度并在简单情形下核验程序,再选择参数化、初值和提议机制。预热阶段用于调节;调节结束后固定算法设置,以不同随机种子运行多条正式链。只有当关键参数和派生量的探索与精度都达到要求,才能合并样本并给出后验结论。诊断失败时,应先定位失败属于哪一层,再决定修改模型、重参数化、改进提议,还是单纯增加正式样本。
沿着这一核验顺序,下面几种常见说法都需要特别警惕:
- 迭代次数很多,所以结果可靠。 高自相关或困在单一模式时,大量迭代仍可能只有很少信息。
- 接受率越高越好。 很小的随机游走步长可以产生接近 1 的接受率,同时造成极慢的探索。
- 任何随机游走都只需目标密度比。 非对称提议必须保留正向与反向提议密度之比。
- 舍弃一半样本即可保证收敛。 烧入比例不能替代多链诊断和目标分布结构分析。
- 把样本稀疏化就能消除相关性。 删除样本会隐藏相关性,却不会改善已经完成的计算。
- \(\widehat R\) 接近 1 就足够。 还需检查 ESS、MCSE、轨迹、尾部量和支持集。
- 只诊断模型参数即可。 非线性派生量和尾部概率可能具有不同的自相关与 Monte Carlo 误差。
- 后验区间已经包含 Monte Carlo 误差。 后验不确定性与数值近似误差需要分别报告。
可复现报告至少说明目标模型与参数化、抽样算法、链数、初始值策略、烧入或预热长度、正式迭代长度、调节后的提议设置、随机数种子,以及关键结论对应的 \(\widehat R\)、ESS 和 MCSE。只保存合并后的后验均值会丢失链间信息,使后来者无法重新检查计算质量。
17.9 本章小结
MCMC 通过构造以目标分布为平稳分布的马尔科夫链,用相关样本近似复杂分布下的期望和概率。Metropolis–Hastings 接受规则满足细致平衡,并允许直接使用未归一化密度;随机游走版本实现简单,但效率依赖提议尺度和协方差结构。非对称提议必须使用 Hastings 校正;在变换后的参数尺度上运行时,还要正确处理目标密度的 Jacobian。Gibbs 抽样利用完整条件分布逐块更新,Metropolis within Gibbs则允许在部分条件更新中嵌入 MH 步骤。基础算法中的调节应在预热阶段完成,正式抽样时固定提议机制。
MCMC 的计算结果必须伴随诊断。接受率只描述候选值是否被采用,自相关和 ESS 描述样本效率,MCSE描述数值精度,多链轨迹和秩标准化 \(\widehat R\) 用于发现初值依赖、位置差异和尺度差异。诊断应同时覆盖模型参数和最终报告的派生量;在能得到网格或解析结果时,还应把它们作为程序核验基准。任何单一指标都不能保证链已充分探索目标分布。
17.10 思考题
- 说明平稳分布与“链已经收敛到平稳分布”之间的区别。细致平衡在其中起什么作用?
- 推导随机游走提议下 Metropolis–Hastings 接受概率的简化形式。
- 推导对数正态随机游走的正反向提议密度比,并说明它与对数变换 Jacobian 的关系。
- 为什么拒绝的候选值必须记录为重复状态?如果删除重复值,样本分布会发生什么变化?
- 一条链的接受率为 0.95,能否据此判断计算质量很好?还需要查看哪些信息?
- 解释 ESS、后验标准差和 MCSE 分别衡量什么。增加原始数据量和增加 MCMC 迭代次数各会影响哪些量?
- 为什么参数本身的 ESS 很高,仍不能保证极端尾部概率具有足够精度?
- 对高度相关的二维正态目标分布,为什么逐坐标 Gibbs 抽样即使接受率为 1 也可能效率较低?
- 两条链分别稳定停留在两个模式附近时,延长其中一条链一定能解决问题吗?说明理由。
- 秩正态化和折叠分别帮助 \(\widehat R\) 发现什么问题?为什么通常不建议只为降低自相关而稀疏化?
17.11 上机实验(Lab)
Lab 1:提议尺度实验。 在 \(t_4\) 例子中设置一组更密的
proposal_sd,记录接受率、ESS、MCSE 和运行时间。画出单位时间 ESS 随提议尺度变化的图,并说明你的选择。Lab 2:相关结构实验。 把二维正态目标分布的相关系数依次改为 \(0\)、\(0.8\)、\(0.97\) 和 \(0.995\),比较各向同性提议与结构匹配提议。保持正式样本数相同,报告最小 ESS。
Lab 3:Gibbs 抽样实验。 对 \(\rho=0.2,0.8,0.98\) 分别运行二维正态 Gibbs 抽样,比较轨迹、自相关和ESS,解释完整条件方差随 \(\rho\) 的变化。
Lab 4:多峰目标实验。 为双峰混合分布设计一种能进行跨峰移动的提议机制,与局部随机游走比较。使用分散初始值、多链轨迹和模式占比评价效果。
Lab 5:银行案例复核。 改变先验标准差和提议尺度,重新运行四条链。报告两组认购率、认购率差、\(\widehat R\)、ESS 与 MCSE,并区分先验敏感性和计算误差。
Lab 6:Hastings 校正实验。 在 Gamma 例子中有意删去正反向提议密度比,比较错误链与正确链的均值、分位数和密度图。解释错误链实际偏向了哪个分布。
拓展 Lab:派生量精度实验。 对银行案例分别计算参数、认购率差、赔率比和事件\(\mathbb I\{p_1-p_0>0.5\}\) 的 ESS 与 MCSE。说明为什么不能用同一个 ESS 代表全部后验结论。