第 10 章 Monte Carlo 方法
上一章介绍了如何生成随机数。本章讨论如何用随机数解决计算问题。Monte Carlo 方法的核心思想很简单:如果一个量可以写成某个随机变量函数的期望,就可以用大量随机样本的平均值来近似它。
在经济统计中,很多问题都可以用这种思路处理。例如,复杂收入分布下的贫困率、税收规则的平均负担、预测模型的未来误差、抽样调查估计量的抽样分布,都可以通过模拟来近似。Monte Carlo 方法不一定给出解析公式,但它给出了可执行、可诊断、可复现的计算路径。
学完本章后,读者应当能够:
- 把积分、概率和统计量分布写成期望,并构造相应的 Monte Carlo 估计量;
- 计算 Monte Carlo 标准误,据此选择模拟次数和保留有效数字;
- 设计重复模拟实验,评价估计量的偏差、方差、均方误差和区间覆盖率;
- 用重要性抽样、对偶变量和控制变量降低模拟方差,并检查方法是否真正提高了效率。
本章用 \(N\) 表示一次 Monte Carlo 计算中的随机抽样次数,用 \(R\) 表示为了研究某种算法或估计量而独立重复整个实验的次数。区分这两个层次,有助于避免把数据的抽样误差与计算产生的 Monte Carlo误差混在一起。
10.1 Monte Carlo 积分
设 \(X\) 的密度为 \(f(x)\),我们希望计算
\[ \mu=\operatorname{E}\{g(X)\}=\int g(x)f(x)\,dx. \]
其中 \(X\) 是随机变量,\(f(x)\) 是其概率密度,\(g(\cdot)\) 是我们关心的函数,\(\mu\) 是目标期望或积分。若可以从 \(f(x)\) 中独立同分布地抽取样本 \(X_1,\ldots,X_N\),则 Monte Carlo 估计量为
\[ \hat\mu_N=\frac{1}{N}\sum_{i=1}^N g(X_i). \]
其中 \(N\) 是模拟次数,\(g(X_i)\) 是第 \(i\) 次模拟得到的函数值。当\(\operatorname{E}\{|g(X)|\}<\infty\) 时,大数定律保证 \(\hat\mu_N\) 随 \(N\) 增大而趋近于 \(\mu\);若进一步有\(0<\sigma_g^2=\operatorname{Var}\{g(X)\}<\infty\),中心极限定理给出
\[ \frac{\sqrt N(\hat\mu_N-\mu)}{\sigma_g} \xrightarrow{d}N(0,1). \]
因此,当 \(N\) 足够大时,可把 \(\hat\mu_N\) 的分布近似为\(N(\mu,\sigma_g^2/N)\),Monte Carlo 标准误可以估计为
\[ \widehat{\operatorname{MCSE}}(\hat\mu_N) = \frac{s_g}{\sqrt{N}}, \]
这里 \(s_g\) 是 \(g(X_1),\ldots,g(X_N)\) 的样本标准差。近似的 \(100(1-\alpha)\%\) Monte Carlo误差区间为
\[ \hat\mu_N\ \mathbin{\pm}\ z_{1-\alpha/2} \widehat{\operatorname{MCSE}}(\hat\mu_N). \]
这个标准误衡量的是“模拟平均值因为随机数而产生的波动”,不是原始经济数据的抽样误差。上述正态近似依赖有限方差;当 \(g(X)\) 或重要性权重具有重尾时,即使 \(N\) 很大,近似也可能不可靠。
很多看起来不同的问题都可以写成这个形式。例如,若要估计事件 \(A\) 的概率,可以令
\[ g(X)=\mathbb I\{X\in A\}, \]
则
\[ P(X\in A)=\operatorname{E}\!\left[\mathbb I\{X\in A\}\right]. \]
若要计算普通积分
\[ I=\int_a^b h(x)\,dx, \]
可以令 \(U\sim \operatorname{Unif}(a,b)\),则
\[ I=(b-a)\operatorname{E}\{h(U)\}. \]
这说明 Monte Carlo 不只是“做很多次模拟”,而是把难算的量改写成可以由样本平均近似的期望。
Monte Carlo 估计
- 明确目标量 \(\mu=\operatorname{E}\{g(X)\}\)。
- 设计随机变量生成方法,从目标分布或合适的辅助分布中生成 \(X_1,\ldots,X_N\)。
- 计算模拟值 \(z_i=g(X_i)\),\(i=1,\ldots,N\)。
- 用 \(\hat\mu_N=\bar z\) 估计 \(\mu\)。
- 用 \(s_z/\sqrt{N}\) 报告 Monte Carlo 标准误,并说明模拟次数 \(N\) 和随机种子。
下面先写一个小函数,用于汇总 Monte Carlo 估计值和模拟误差。
mc_summary <- function(z, level = 0.95) {
  stopifnot(length(z) >= 2L, all(is.finite(z)),
            length(level) == 1L, level > 0, level < 1)
  n <- length(z)
  alpha <- 1 - level
  estimate <- mean(z)
  se <- sd(z) / sqrt(n)
  q <- qnorm(1 - alpha / 2)
  c(estimate = estimate,
    mc_se = se,
    lower = estimate - q * se,
    upper = estimate + q * se)
}
先看一个最直接的积分例子。因为
\[ \pi=\int_0^1\frac{4}{1+x^2}\,dx =\operatorname{E}\left\{\frac{4}{1+U^2}\right\},\qquad U\sim \operatorname{Unif}(0,1), \]
所以只需生成均匀随机数并计算函数值的平均数。这里积分区间长度恰好为 1;一般的 \([a,b]\) 区间还要乘以 \(b-a\)。
set.seed(2025)
N_pi <- 20000
u <- runif(N_pi)
pi_result <- mc_summary(4 / (1 + u^2))

c(pi_result,
  exact = pi,
  standardized_error = unname(
    (pi_result["estimate"] - pi) / pi_result["mc_se"]))
#>           estimate              mc_se              lower              upper
#>           3.139171           0.004556           3.130240           3.148101
#>              exact standardized_error
#>           3.141593          -0.531566
standardized_error 把实际误差除以估计的 Monte Carlo 标准误。它不应被机械地要求小于 1,但若在多次独立运行中经常出现很大的绝对值,就应检查程序、方差估计或中心极限定理的适用性。对于这个一维光滑积分,确定性求积通常更快;这个例子的作用是展示“积分如何变成期望”,而不是说明 Monte Carlo在一维积分中占优。
10.2 例:补贴规则的平均支出
延续第 7 章的模拟收入分布。设家庭收入 \(Y\) 服从对数正态分布,低收入补贴函数为
\[ g(y)= \begin{cases} 2(1-y/4), & 0<y<4,\\ 0, & y\geq 4. \end{cases} \]
其中 \(Y\) 可以理解为家庭年收入,单位为万元;\(g(y)\) 是该收入水平下的补贴金额,单位同样为万元。我们希望估计每户平均补贴支出
\[ \mu=\operatorname{E}\{g(Y)\}. \]
如果直接积分不方便,可以用 Monte Carlo 方法估计。
set.seed(2026)
N <- 100000
meanlog_income <- log(8)
sdlog_income <- 0.6
poverty_line <- 4

income <- rlnorm(N, meanlog = meanlog_income,
                 sdlog = sdlog_income)
subsidy <- ifelse(income < poverty_line,
                  2 * (1 - income / poverty_line), 0)

subsidy_result <- mc_summary(subsidy)

# 解析值只用于核对模拟程序
poverty_exact <- plnorm(poverty_line, meanlog_income,
                        sdlog_income)
truncated_income_mean <-
  exp(meanlog_income + sdlog_income^2 / 2) *
  pnorm((log(poverty_line) - meanlog_income -
           sdlog_income^2) / sdlog_income)
subsidy_exact <- 2 * (poverty_exact -
                        truncated_income_mean / poverty_line)

c(subsidy_result, exact = subsidy_exact)
#>  estimate     mc_se     lower     upper     exact
#> 0.0586503 0.0006198 0.0574354 0.0598651 0.0583092
这个区间不是传统意义上由抽样调查误差形成的置信区间,而是 Monte Carlo 计算误差的近似区间。它回答的是:在给定收入模型和模拟次数下,随机模拟本身带来的误差有多大。若模型设定改变,例如收入分布的均值、离散程度或补贴规则改变,估计目标 \(\mu\) 本身也会改变。实际问题往往没有 exact 可供比较;这里给出解析值,是为了示范在可能时如何用已知结果校验代码。
类似地,贫困率也可以写成指示函数的期望。若贫困线设为 4 万元,则贫困率为
\[ p=P(Y<4)=\operatorname{E}\!\left[\mathbb I\{Y<4\}\right]. \]
poverty_indicator <- as.numeric(income < poverty_line)
c(mc_summary(poverty_indicator), exact = poverty_exact)
#> estimate    mc_se    lower    upper    exact
#> 0.124300 0.001043 0.122255 0.126345 0.123995
对于二元指示变量,Monte Carlo 标准误也可以写成
\[ \sqrt{\frac{\hat p(1-\hat p)}{N}}, \]
其中 \(\hat p\) 是模拟得到的比例。这个公式与样本比例的标准误形式相同,但这里的随机性来自模拟次数。
10.3 模拟次数与误差
Monte Carlo 标准误按 \(1/\sqrt{N}\) 的速度下降。也就是说,如果希望误差大约减半,模拟次数需要增加到原来的 4 倍。这一点和许多数值积分方法不同:Monte Carlo 在低维问题中未必最快,但其收敛速度通常不直接依赖积分维数,因此在高维问题中很有价值。
一次运行的实际误差 \(\hat\mu_N-\mu\) 带有偶然性,不能用它来判断一般的误差速度。下面对每个 \(N\)独立重复 \(R=250\) 次,比较估计量的经验均方根误差(RMSE)与平均的 Monte Carlo 标准误。
set.seed(1)
Ns <- c(100, 1000, 10000, 100000)
R_error <- 250
out <- data.frame(N = Ns, bias = NA_real_, rmse = NA_real_,
                  mean_mc_se = NA_real_)

for (j in seq_along(Ns)) {
  estimates <- standard_errors <- numeric(R_error)

  for (r in seq_len(R_error)) {
    y <- rlnorm(Ns[j], meanlog = meanlog_income,
                sdlog = sdlog_income)
    z <- ifelse(y < poverty_line,
                2 * (1 - y / poverty_line), 0)
    estimates[r] <- mean(z)
    standard_errors[r] <- sd(z) / sqrt(Ns[j])
  }

  out$bias[j] <- mean(estimates - subsidy_exact)
  out$rmse[j] <- sqrt(mean((estimates - subsidy_exact)^2))
  out$mean_mc_se[j] <- mean(standard_errors)
}

out_show <- out
out_show$N <- format(out_show$N, scientific = FALSE, trim = TRUE)
knitr::kable(out_show, row.names = FALSE,
digits = c(0, 5, 5, 5))| N | bias | rmse | mean_mc_se |
|---|---|---|---|
| 100 | -0.00031 | 0.01976 | 0.01895 |
| 1000 | 0.00028 | 0.00603 | 0.00618 |
| 10000 | 0.00028 | 0.00205 | 0.00196 |
| 100000 | 0.00001 | 0.00066 | 0.00062 |
reference_rate <- out$rmse[1] * sqrt(Ns[1] / Ns)
plot(out$N, out$rmse, log = "xy", type = "b", pch = 19,
     xlab = "Simulation size N", ylab = "Empirical RMSE",
     xaxt = "n")
axis(1, at = Ns, labels = format(Ns, scientific = FALSE))
lines(out$N, reference_rate, lty = 2)
legend("topright", c("Empirical RMSE", expression(N^{-1/2})),
       lty = c(1, 2), pch = c(19, NA), bty = "n")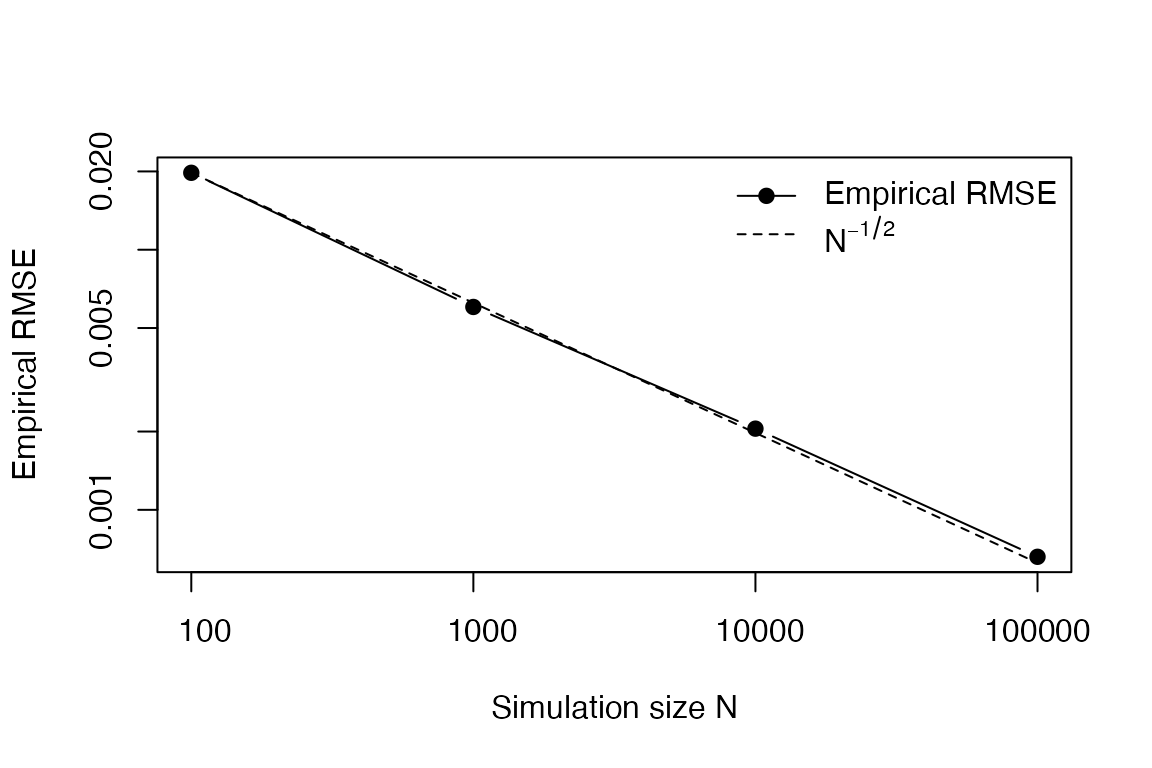
图10.1: Monte Carlo 均方根误差随模拟次数的变化。虚线按 \(N^{-1/2}\) 下降,并在第一个点处与经验 RMSE 对齐。
表中的 RMSE 和平均标准误不会完全相等:前者依赖已知解析值并通过重复实验估计,后者来自每次运行内部的样本方差。但在独立同分布且方差有限时,两者应当接近;图 10.1 也应呈现接近 \(N^{-1/2}\) 的下降趋势。
实际工作中,不能只报告模拟均值,也要报告 Monte Carlo 标准误或至少说明模拟次数。否则读者无法判断结果的小数位是否有意义。例如,如果 Monte Carlo 标准误为 0.01,那么报告 0.376241 并没有太多意义,通常报告到 0.38 或 0.376 已经足够。
有时可以用一次较小规模的预模拟来估计需要的模拟次数。若希望 95% Monte Carlo 误差区间的半宽度不超过 \(\epsilon\),可近似要求
\[ 1.96\frac{s_g}{\sqrt{N}}\leq \epsilon, \]
即
\[ N\geq \left(\frac{1.96s_g}{\epsilon}\right)^2. \]
这里 \(s_g\) 可由预模拟得到。下面以平均补贴支出为例,估计若希望半宽度不超过 0.002 万元,大约需要多少次模拟。
set.seed(7)
N_pilot <- 3000
y_pilot <- rlnorm(N_pilot, meanlog = meanlog_income,
                  sdlog = sdlog_income)
z_pilot <- ifelse(y_pilot < poverty_line,
                  2 * (1 - y_pilot / poverty_line), 0)

epsilon <- 0.002
critical_value <- qnorm(0.975)
required_N <- ceiling((critical_value * sd(z_pilot) / epsilon)^2)

set.seed(8)
y_final <- rlnorm(required_N, meanlog = meanlog_income,
                  sdlog = sdlog_income)
z_final <- ifelse(y_final < poverty_line,
                  2 * (1 - y_final / poverty_line), 0)
final_result <- mc_summary(z_final)

sample_size_plan <- data.frame(
  pilot_sd = sd(z_pilot),
  epsilon = epsilon,
  required_N = required_N,
  achieved_half_width = unname(
    (final_result["upper"] - final_result["lower"]) / 2)
)
knitr::kable(sample_size_plan, row.names = FALSE,
digits = c(4, 4, 0, 4))| pilot_sd | epsilon | required_N | achieved_half_width |
|---|---|---|---|
| 0.1887 | 0.002 | 34214 | 0.0021 |
这个公式只是近似规划工具,因为预模拟中的 \(s_g\) 本身也有误差。achieved_half_width 使用最终模拟的方差重新计算,因而不一定恰好小于目标值。若精度要求是硬约束,可以分批增加模拟次数,并在每一批后重新计算标准误;同时应预先规定停止规则,避免看到“满意”的随机结果才停止。
10.4 用模拟研究估计量性质
Monte Carlo 方法还可以用来研究估计量在重复抽样下的表现。假设我们关心一个简单消费函数
\[ C_i=\beta_0+\beta_1 Y_i+\varepsilon_i, \]
其中 \(C_i\) 是消费支出,\(Y_i\) 是收入,\(\varepsilon_i\) 是随机扰动。若真实边际消费倾向为\(\beta_1=0.6\),我们可以反复生成样本并估计线性回归,观察 \(\hat\beta_1\) 的抽样分布。
设第 \(r\) 次模拟得到估计量 \(\hat\theta^{(r)}\),真实值为 \(\theta\),重复次数为 \(R\)。常见评价指标为
\[ \widehat{\operatorname{Bias}} =\frac{1}{R}\sum_{r=1}^R\left(\hat\theta^{(r)}-\theta\right), \]
\[ \widehat{\operatorname{Var}} =\frac{1}{R-1}\sum_{r=1}^R \left(\hat\theta^{(r)}-\overline{\hat\theta}\right)^2, \]
以及
\[ \widehat{\operatorname{MSE}} =\frac{1}{R}\sum_{r=1}^R \left(\hat\theta^{(r)}-\theta\right)^2. \]
这里 \(\overline{\hat\theta}=R^{-1}\sum_{r=1}^R\hat\theta^{(r)}\)。偏差衡量估计量平均是否偏离真实值,方差衡量重复抽样下是否稳定,均方误差同时考虑偏差和方差。若每次模拟还构造一个置信区间,则覆盖率是包含真实参数的区间比例;名义 95% 区间的经验覆盖率应接近 0.95。
set.seed(2)

simulate_beta1 <- function(n, R = 1000) {
  beta1_hat <- beta1_se <- numeric(R)
  covered <- logical(R)

  for (r in seq_len(R)) {
    income <- rlnorm(n, meanlog = log(8), sdlog = 0.5)
    consumption <- 1 + 0.6 * income + rnorm(n, sd = 2)
    fit <- lm(consumption ~ income)
    beta1_hat[r] <- coef(fit)[2]
    beta1_se[r] <- summary(fit)$coefficients[2, 2]
    half_width <- qt(0.975, df = n - 2) * beta1_se[r]
    covered[r] <- abs(beta1_hat[r] - 0.6) <= half_width
  }

  c(n = n,
    bias = mean(beta1_hat) - 0.6,
    mc_se_bias = sd(beta1_hat) / sqrt(R),
    empirical_sd = sd(beta1_hat),
    mean_model_se = mean(beta1_se),
    coverage_95 = mean(covered),
    mse = mean((beta1_hat - 0.6)^2))
}

ols_out <- as.data.frame(
  do.call(rbind, lapply(c(50, 200, 1000), simulate_beta1))
)

knitr::kable(ols_out, row.names = FALSE, digits = 4)| n | bias | mc_se_bias | empirical_sd | mean_model_se | coverage_95 | mse |
|---|---|---|---|---|---|---|
| 50 | 1e-04 | 2e-03 | 0.0624 | 0.0618 | 0.943 | 0.0039 |
| 200 | 1e-04 | 1e-03 | 0.0303 | 0.0297 | 0.947 | 0.0009 |
| 1000 | -1e-04 | 4e-04 | 0.0134 | 0.0131 | 0.945 | 0.0002 |
这个实验帮助我们把“估计量是随机变量”这句话具体化。每次样本不同,估计结果也不同;重复模拟后,我们可以近似观察估计量的偏差、方差、均方误差和区间覆盖率。empirical_sd 是 \(R\) 个斜率估计的标准差,mean_model_se 是每次回归所报告标准误的平均值;二者接近是标准误公式校准良好的一个信号。
注意这里有两层误差:每个样本中的回归估计有抽样误差;我们用有限的 \(R\) 次模拟总结这些性质,又会产生 Monte Carlo 误差。例如,若 \(s_{\hat\beta_1}\) 表示 \(R\) 个\(\hat\beta_1^{(r)}\) 的样本标准差,则偏差估计的 Monte Carlo 标准误为\(s_{\hat\beta_1}/\sqrt R\),即表中的 mc_se_bias。类似地,覆盖率估计的标准误约为 \(\sqrt{\hat c(1-\hat c)/R}\)。因此,不能只凭偏差估计的正负号或覆盖率的小幅偏离判断方法优劣。
10.5 例:信用组合损失模拟
Monte Carlo 在经济金融风险分析中也很常见。考虑一个由 \(m\) 个小微企业贷款构成的组合。第 \(j\) 个企业给定的贷款暴露额为 \(a_j\),违约指示随机变量为 \(D_j\),违约损失率为 \(\ell\)。组合损失为
\[ L=\sum_{j=1}^m a_jD_j\ell. \]
其中 \(D_j=1\) 表示违约,\(D_j=0\) 表示未违约。若已知或已估计每个企业的违约概率 \(p_j\),可以通过模拟 \(D_j\sim \operatorname{Bernoulli}(p_j)\) 得到组合损失分布。为突出 Monte Carlo 计算,下面暂时假设各企业是否违约相互独立,且违约损失率固定;数据也是模拟的,不对应任何真实金融机构。记\(N_{\mathrm{loss}}\) 为组合损失的模拟次数。
set.seed(2028)
m <- 300
N_loss <- 5000

risk_score <- rnorm(m)
exposure <- runif(m, min = 0.5, max = 3.0)
default_prob <- plogis(-3 + 0.8 * risk_score)
lgd <- 0.45
loss_threshold <- 22

loss <- numeric(N_loss)
default_count <- numeric(N_loss)

for (i in seq_len(N_loss)) {
  default <- rbinom(m, size = 1, prob = default_prob)
  loss[i] <- sum(exposure * default * lgd)
  default_count[i] <- sum(default)
}

exact_expected_loss <- sum(exposure * default_prob * lgd)
prob_exceed <- mean(loss > loss_threshold)

c(exact_mean = exact_expected_loss,
  simulated_mean = mean(loss),
  mc_se_mean = sd(loss) / sqrt(N_loss),
  loss_sd = sd(loss),
  VaR_95 = unname(quantile(loss, 0.95)),
  prob_loss_gt_22 = prob_exceed,
  mc_se_prob = sqrt(prob_exceed * (1 - prob_exceed) / N_loss),
  mean_default_count = mean(default_count))
#>         exact_mean     simulated_mean         mc_se_mean            loss_sd
#>          15.071524          15.069733           0.049759           3.518497
#>             VaR_95    prob_loss_gt_22         mc_se_prob mean_default_count
#>          21.053706           0.029800           0.002405          19.369200
这里 simulated_mean 是平均损失,VaR_95 是模拟损失分布的 95% 分位数,prob_loss_gt_22 是损失超过 22 个单位的概率。在独立违约模型下,期望损失有解析值\(\ell\sum_{j=1}^m a_jp_j\),因而可以用 exact_mean 校验模拟均值。均值与阈值超越概率的 Monte Carlo 标准误分别列在 mc_se_mean 和 mc_se_prob 中。
分位数的标准误不能用 sd(loss) / sqrt(N_loss) 代替。可以增加 \(N_{\mathrm{loss}}\) 后检查结果是否稳定,或使用专门的分位数标准误方法。更重要的是,真实贷款违约往往受共同经济冲击影响;独立性假设会低估组合损失的尾部风险。这属于模型不确定性,不能靠增加模拟次数消除。
10.6 重要性抽样
有时我们关心的是罕见事件,例如高收入尾部概率、极端亏损概率或违约概率。如果直接从原分布抽样,罕见事件出现次数很少,估计会很不稳定。重要性抽样通过改变抽样分布来提高效率。
设目标积分为
\[ \mu=\int g(x)f(x)\,dx. \]
如果从另一个更容易覆盖重要区域的密度 \(q(x)\) 抽样,并且在 \(g(x)f(x)\ne 0\) 的区域都有\(q(x)>0\),则
\[ \mu=\int g(x)\frac{f(x)}{q(x)}q(x)\,dx =\operatorname{E}_q\left\{g(X)\frac{f(X)}{q(X)}\right\}. \]
其中 \(w(x)=f(x)/q(x)\) 称为重要性权重,\(q\) 称为提议分布。关键是 \(q(x)\) 要在\(|g(x)|f(x)\) 贡献大的区域给出足够概率。如果 \(q(x)\) 在某些重要区域太小,权重就会非常大,估计可能由少数样本支配。为了使用通常的标准误公式,还需要\(\operatorname{E}_q[\{g(X)w(X)\}^2]<\infty\)。
下面估计收入超过 40 万元的尾部概率。直接模拟中超过阈值的样本很少;重要性抽样改从高收入区域更常见的对数正态分布中抽样,再用权重修正。这里保留解析值只是为了核对程序。
set.seed(3)
N <- 20000
threshold <- 40

# 直接 Monte Carlo
y_direct <- rlnorm(N, meanlog = meanlog_income,
                   sdlog = sdlog_income)
z_direct <- as.numeric(y_direct > threshold)
direct_result <- mc_summary(z_direct)

# 重要性抽样:从更偏向高收入区域的分布中抽样
proposal_meanlog <- log(35)
y_imp <- rlnorm(N, meanlog = proposal_meanlog,
                sdlog = sdlog_income)
log_w <- dlnorm(y_imp, meanlog_income, sdlog_income,
                log = TRUE) -
  dlnorm(y_imp, proposal_meanlog, sdlog_income,
         log = TRUE)
w <- exp(log_w)
z_imp <- as.numeric(y_imp > threshold) * w
importance_result <- mc_summary(z_imp)

tail_exact <- plnorm(threshold, meanlog_income,
                     sdlog_income, lower.tail = FALSE)
result_table <- data.frame(
  method = c("direct", "importance"),
  estimate = c(direct_result["estimate"],
               importance_result["estimate"]),
  mc_se = c(direct_result["mc_se"],
            importance_result["mc_se"]),
  lower = c(direct_result["lower"],
            importance_result["lower"]),
  upper = c(direct_result["upper"],
            importance_result["upper"]),
  tail_draws = c(sum(y_direct > threshold),
                 sum(y_imp > threshold))
)
knitr::kable(result_table, row.names = FALSE, digits = 6)| method | estimate | mc_se | lower | upper | tail_draws |
|---|---|---|---|---|---|
| direct | 0.003750 | 0.000432 | 0.002903 | 0.004597 | 75 |
| importance | 0.003711 | 0.000048 | 0.003617 | 0.003804 | 8299 |
raw_weight_ess <- sum(w)^2 / sum(w^2)
direct_reference_var <- tail_exact * (1 - tail_exact) / N
target_efficiency_gain <- unname(
  direct_reference_var / importance_result["mc_se"]^2)
equivalent_direct_N <- unname(
  tail_exact * (1 - tail_exact) /
    importance_result["mc_se"]^2)

c(exact = tail_exact,
  raw_weight_ess = raw_weight_ess,
  target_efficiency_gain = target_efficiency_gain,
  equivalent_direct_N = equivalent_direct_N)
#>                  exact         raw_weight_ess target_efficiency_gain
#>              3.655e-03              2.535e+02              7.992e+01
#>    equivalent_direct_N
#>              1.598e+06
tail_draws 显示提议分布把更多模拟资源放到了目标事件上。target_efficiency_gain 用直接抽样的理论方差除以重要性抽样的估计方差;大于 1 才表示对当前目标量实现了方差缩减。
重要性抽样不是简单地“换一个分布抽样”。如果 \(q(x)\) 选得不好,权重可能极端不稳定,估计反而变差。因此,实际使用时还要检查最大权重、权重分位数以及
\[ \operatorname{ESS}_w= \frac{\left(\sum_{i=1}^N w_i\right)^2}{\sum_{i=1}^N w_i^2}. \]
raw_weight_ess 是原始权重离均匀程度的诊断,常用于判断提议分布对整个目标分布 \(f\) 的覆盖情况,但它不是当前尾部概率估计的“有效样本数”。本例刻意把 \(q\) 移到右尾,因此它对整个 \(f\) 的覆盖可能并不好,却仍能高效估计右尾概率。应把权重诊断与目标量自身的标准误一起看,不能仅凭一个 ESS 判定方法好坏。equivalent_direct_N 则根据当前目标量的方差,给出直接抽样达到同等标准误大约需要的样本量。
10.7 方差缩减的基本思想
Monte Carlo 方法的成本主要来自随机误差。除了增加 \(N\),还可以通过更聪明的抽样降低方差。方差缩减方法的目标不是改变估计对象,而是在估计同一个 \(\mu\) 时,让估计量更稳定。
10.7.1 对偶变量法
最简单的例子是对偶变量法。若要估计
\[ \operatorname{E}\{h(U)\},\quad U\sim \operatorname{Unif}(0,1), \]
可以同时使用 \(U\) 和 \(1-U\):
\[ \hat\mu_{\mathrm{anti}}=\frac{1}{N}\sum_{i=1}^N \frac{h(U_i)+h(1-U_i)}{2}. \]
当 \(h\) 是单调函数时,\(h(U_i)\) 和 \(h(1-U_i)\) 往往负相关,从而降低方差。
set.seed(4)
R <- 1000
N_pairs <- 100
plain <- anti <- numeric(R)

for (r in seq_len(R)) {
  # 两种方法都调用 h() 共 2 * N_pairs 次
  plain[r] <- mean(exp(runif(2 * N_pairs)))
  u <- runif(N_pairs)
  anti[r] <- mean((exp(u) + exp(1 - u)) / 2)
}

truth <- exp(1) - 1
antithetic_comparison <- data.frame(
  method = c("independent", "antithetic"),
  mean = c(mean(plain), mean(anti)),
  sd = c(sd(plain), sd(anti)),
  rmse = c(sqrt(mean((plain - truth)^2)),
           sqrt(mean((anti - truth)^2)))
)
knitr::kable(antithetic_comparison, row.names = FALSE,
digits = 5)| method | mean | sd | rmse |
|---|---|---|---|
| independent | 1.718 | 0.03432 | 0.03430 |
| antithetic | 1.718 | 0.00646 | 0.00646 |
这里估计的是 \(\operatorname{E}\{\exp(U)\}=e-1\)。公平的效率比较必须控制计算预算,所以两种方法在每次重复实验中都计算 \(2N_{\mathrm{pairs}}\) 次指数函数。若对偶变量法有效,其 sd 和 rmse 都应小于独立抽样。
10.7.2 控制变量法
控制变量法利用一个期望已知、且与目标变量相关的辅助变量。设 \(Z=g(X)\) 是目标模拟值,\(H\) 是辅助变量,且 \(\operatorname{E}(H)=\eta\) 已知。对任意常数 \(a\),
\[ \tilde\mu=\bar Z-a(\bar H-\eta) \]
仍然估计 \(\operatorname{E}(Z)\)。如果 \(H\) 与 \(Z\) 高度相关,选择合适的 \(a\) 可以显著降低方差。理论上的最优系数为
\[ a^\ast=\frac{\operatorname{Cov}(Z,H)}{\operatorname{Var}(H)}. \]
实践中 \(a^\ast\) 通常未知,可以用预模拟估计。若反复执行同一类计算,预模拟的成本可由后续多次运行分摊。为清楚地区分“估计系数”和“评价方法”两个阶段,下面先用一批独立样本估计 \(a^\ast\),再固定该系数比较两种方法。
在平均补贴支出的例子中,补贴金额 \(Z=g(Y)\) 与低收入指示变量\(H=\mathbb I\{Y<4\}\) 高度相关,而后者的期望
\[ \operatorname{E}(H)=P(Y<4) \]
可以由对数正态分布函数算出。因此可以把低收入指示变量作为控制变量。
set.seed(5)
N_coefficient <- 10000
income_for_coefficient <- rlnorm(
  N_coefficient, meanlog = meanlog_income,
  sdlog = sdlog_income
)
subsidy_for_coefficient <- ifelse(
  income_for_coefficient < poverty_line,
  2 * (1 - income_for_coefficient / poverty_line), 0
)
poverty_for_coefficient <- as.numeric(
  income_for_coefficient < poverty_line
)
a_pilot <- cov(subsidy_for_coefficient,
               poverty_for_coefficient) /
  var(poverty_for_coefficient)

set.seed(6)
R <- 1000
N <- 500

plain <- control <- numeric(R)

for (r in seq_len(R)) {
  y <- rlnorm(N, meanlog = meanlog_income,
              sdlog = sdlog_income)
  z <- ifelse(y < poverty_line,
              2 * (1 - y / poverty_line), 0)
  h <- as.numeric(y < poverty_line)

  plain[r] <- mean(z)
  control[r] <- mean(z) - a_pilot * (mean(h) - poverty_exact)
}

control_comparison <- data.frame(
  method = c("plain", "control"),
  mean = c(mean(plain), mean(control)),
  bias = c(mean(plain), mean(control)) - subsidy_exact,
  sd = c(sd(plain), sd(control)),
  rmse = c(sqrt(mean((plain - subsidy_exact)^2)),
           sqrt(mean((control - subsidy_exact)^2)))
)
knitr::kable(control_comparison, row.names = FALSE,
digits = 5)| method | mean | bias | sd | rmse |
|---|---|---|---|---|
| plain | 0.05856 | 0.00025 | 0.00860 | 0.00860 |
| control | 0.05845 | 0.00014 | 0.00509 | 0.00509 |
控制变量法提醒我们:模拟设计可以利用统计模型中已知的结构。若某个辅助量期望已知,并且与目标量相关,就可能用它修正随机波动。若直接用当前样本同时估计 \(a^\ast\) 和 \(\mu\),有限样本下可能引入小量偏差;独立预模拟、样本分割或交叉拟合可以避免或减弱这个问题。
10.8 Monte Carlo 结果如何报告
一个可复现的 Monte Carlo 分析至少应说明以下内容:
- 目标量是什么,例如均值、概率、分位数、回归系数偏差或均方误差;
- 随机变量如何生成,包括分布、参数、依赖结构和样本量;
- 模拟次数 \(N\) 或重复次数 \(R\),以及提前规定的停止规则;
- 随机种子、软件版本和足以复现结果的主要代码;
- 与目标量匹配的 Monte Carlo 标准误或其他稳定性检查;
- 若使用重要性抽样或方差缩减方法,应说明提议分布、权重诊断、辅助变量和计算预算。
报告的小数位也应与 Monte Carlo 误差相称。例如标准误约为 0.003 时,把估计值写成 0.376241 会制造虚假的精确感。对均值可以直接使用本章的 \(s_g/\sqrt N\);概率可使用二项比例公式;分位数、最大值等非线性目标则需要与其对应的误差评估方法,不能套用均值的公式。
尤其要区分“模型不确定性”“真实抽样误差”和“Monte Carlo 误差”。本章主要处理第三类误差:在模型和目标量已经明确时,计算近似本身还有多不稳定。下一章将转向 Bootstrap、Jackknife 和置换检验,它们更多从已经观测到的数据出发,用重采样近似统计量的抽样分布。
10.9 本章小结
Monte Carlo 方法用随机样本平均值近似期望和积分。它的理论基础是大数定律和中心极限定理,后者的常用误差公式要求模拟值具有有限方差。实际报告中应给出模拟次数、Monte Carlo 标准误和可复现细节。Monte Carlo 不仅可以计算复杂积分,也可以通过重复抽样研究估计量的偏差、方差、均方误差和区间覆盖率。解析结果可以校验程序,却不是方法成立的前提。重要性抽样、对偶变量法和控制变量法进一步说明,评价模拟设计时既要比较方差,也要控制计算预算并检查方法特有的诊断量。
10.10 思考题
- 证明在 \(\operatorname{E}\{|g(X)|\}<\infty\) 时,普通 Monte Carlo 估计量 \(\hat\mu_N\) 是 \(\mu\) 的无偏估计。若用 \(U\sim \operatorname{Unif}(a,b)\) 计算 \(\int_a^b h(x)\,dx\) 时漏乘 \(b-a\),估计量会收敛到什么?
- 大数定律和中心极限定理在本章中各自解决什么问题?若 \(\operatorname{E}\{|g(X)|\}<\infty\) 但\(\operatorname{Var}\{g(X)\}=\infty\),为什么样本平均仍可能收敛,而通常的\(s_g/\sqrt N\) 误差公式却不可靠?
- 为什么不能用一次运行的 \(|\hat\mu_N-\mu|\) 证明误差按 \(N^{-1/2}\) 下降?若要把 Monte Carlo标准误从 0.01 降到 0.001,模拟次数需要扩大多少倍?
- 区分原始数据的抽样误差、模型不确定性和 Monte Carlo 误差。增加模拟次数能够减小哪一种误差?为什么贷款违约相关性设错不能通过增大 \(N\) 来补救?
- 在估计量模拟实验中,\(n\) 和 \(R\) 分别控制什么?一个偏差估计为正、或 95% 区间的经验覆盖率为0.943,为什么都不能单凭该数值断定估计方法存在系统问题?
- 重要性抽样为什么要求 \(q(x)>0\) 覆盖所有满足 \(g(x)f(x)\ne0\) 的区域?原始权重 ESS 很小时,为什么某个特定目标量的估计仍可能比直接抽样精确?
- 比较普通抽样与对偶变量法时,为什么要控制函数计算次数,而不能只让两种方法使用相同数量的随机数?什么样的函数 \(h\) 可能使 \(h(U)\) 与 \(h(1-U)\) 无法产生所需的负相关?
- 控制变量的期望为什么必须已知?若用当前样本同时估计最优系数 \(a^\ast\) 和目标期望,可能产生什么问题?独立预模拟、样本分割或交叉拟合分别如何帮助解决这个问题?
10.11 上机实验(Lab)
每份实验报告至少应写明目标量、数据生成过程或概率模型、随机种子、\(N\) 与 \(R\)、估计值及其Monte Carlo 标准误,并附可复现代码。比较算法时应控制主要计算预算;存在解析答案时,还应报告实际误差并检查它与标准误是否相称。
Lab 1:积分、概率与误差区间。 分别估计\(\int_0^1 4/(1+x^2)\,dx\) 和标准正态分布下的 \(P(X>2)\)。令\(N\in\{10^2,10^3,10^4,10^5\}\),对每个 \(N\) 独立重复至少 500 次。比较经验偏差、RMSE、平均Monte Carlo 标准误和 95% 误差区间的覆盖率,并用双对数图检查 \(N^{-1/2}\) 速度。说明小 \(N\) 下尾部概率的正态误差区间为何可能失效。
Lab 2:补贴支出的精度规划与敏感性。 用预模拟分别规划误差区间半宽度不超过 0.01、0.005 和0.002 所需的 \(N\),再用独立随机数验证实际半宽度。随后令收入分布的
sdlog取 0.3、0.6 和0.9,比较平均补贴、贫困率及两者的 Monte Carlo 标准误,并用解析结果校验代码。Lab 3:回归估计量的模拟研究。 对 \(n\in\{50,200,1000\}\) 重复消费函数实验,保存每次的\(\hat\beta_1\)、模型标准误和置信区间。报告偏差、偏差的 Monte Carlo 标准误、经验标准差、平均模型标准误、MSE 和覆盖率。再令误差标准差变为 \(0.25Y_i\),说明哪些指标显示通常的同方差标准误已经失准。
Lab 4:重要性抽样的提议分布选择。 估计 \(P(Y>40)\),把提议对数正态分布的中位数分别设为 20、30、35 和 50。对每个方案独立重复至少 200 次,比较偏差、RMSE、平均估计标准误、原始权重 ESS、尾部样本数和计算时间。根据目标量的精度选择方案,并解释为什么不能只选择 ESS 最大者。
Lab 5:信用组合的共同冲击。 先复现独立违约模型,再用单因子 Gaussian 构造相关违约:每次组合模拟生成共同冲击 \(F_i\) 和企业冲击 \(\varepsilon_{ij}\),令\(D_{ij}=\mathbb I\{\sqrt\rho F_i+\sqrt{1-\rho}\varepsilon_{ij}<\Phi^{-1}(p_j)\}\)。取\(\rho\in\{0,0.1,0.3,0.5\}\),比较期望损失、损失标准差、95% 与 99% 分位数和超过阈值的概率。验证各企业的边际违约概率仍为 \(p_j\),并说明相关性为何主要改变尾部风险。
拓展 Lab:方差缩减的公平比较。 第一部分用普通抽样和对偶变量法估计 \(\operatorname{E}\{\exp(U)\}\),在相同函数计算次数下改变样本量并比较 RMSE。第二部分用控制变量法估计对数正态变量的 \(\operatorname{E}(Y^2)\),以 \(Y\) 为控制变量,用独立预模拟估计控制系数。报告普通估计与控制变量估计的偏差、标准差、RMSE、方差缩减倍数及计算时间。