第 5 章 求根算法
5.1 学习目标与路线
在统计计算中,我们经常需要求解形如 \(f(x)=0\) 的方程。未知量可以是分位数、参数估计量、置信区间端点,也可以是经济模型中的均衡价格或投资项目的内部收益率。例如:
- 求 \(F(q)-0.95=0\),得到分布函数 \(F\) 的 95% 分位数;
- 求 score 方程 \(\ell'(\theta)=0\),得到极大似然估计的候选值;
- 求需求减供给 \(D(p)-S(p)=0\),得到市场均衡价格;
- 求净现值 \(\operatorname{NPV}(r)=0\),得到投资项目的内部收益率。
本章只讨论一维实数方程。重点不是罗列算法,而是建立一套可以检查的工作流:先把问题正确地写成方程,确定定义域和可能的根,再选择算法,最后验证数值结果及其统计或经济含义。
学完本章后,读者应该能够:
- 把分位数、估计方程和净现值等问题写成 \(f(x)=0\);
- 根据定义域、连续性、导数信息和变号区间选择二分法、Newton 法、割线法或
uniroot(); - 用作图和网格扫描寻找候选括根区间,并意识到这种方法可能漏掉不变号的根;
- 同时使用函数残差、区间宽度或相对步长、迭代上限和收敛状态检查结果;
- 识别不连续点、重根、多根、导数为零、迭代震荡和参数越界等失败情形;
- 解释为什么“求得 score 的根”不等于已经证明该点是极大似然估计。
本章的核心内容是求根工作流、二分法、Newton 法和 uniroot();割线法与形式化的收敛阶可作为拓展内容。需要用到的先修知识包括 R 函数与循环、连续性和导数、累积分布函数与分位数,以及第3 章介绍的浮点数、绝对误差和相对误差。
5.2 求根问题的基本设定
设 \(f(x)\) 是一维函数,我们希望找到 \(x^\ast\),使得
\[ f(x^\ast)=0. \]
在调用算法以前,至少要回答四个问题:\(f\) 在哪里有定义?它在候选区间内是否连续?根是否存在且是否唯一?找到这个根以后,它是否满足原问题的约束?score 方程的根只是驻点候选;如果最优值位于参数空间边界,一阶条件甚至不必等于 0。因此,数值求根不能替代模型层面的判断。
5.2.1 从问题到结果的工作流
一个可靠的一维求根分析通常按下面的顺序进行:
- 定义方程与定义域。 写清 \(f(x)\)、参数单位和允许范围,例如贴现率必须满足 \(r>-1\)。
- 定位候选根。 利用理论、图形或网格计算寻找变号区间,并检查是否可能存在多个根或不连续点。
- 选择算法。 有连续函数和变号区间时优先使用括区间方法;有可靠导数和好初值时才考虑 Newton 法。
- 执行并诊断。 设置迭代上限,保存迭代轨迹,报告停止原因和最终函数残差。
- 回到原问题验证。 对 MLE 检查目标函数和边界,对分位数检查 \(F(\hat q)\),对 IRR 检查\(\operatorname{NPV}(\hat r)\) 并讨论多根的经济含义。
| 已知条件 | 建议方法 | 必须补充的检查 |
|---|---|---|
| 连续且已有变号区间 | uniroot() 或二分法 |
区间、残差、定义域 |
| 导数可靠且初值接近根 | Newton 法 | 导数、步长、残差、是否越界 |
| 导数难算但有两个好初值 | 割线法 | 分母、步长、残差 |
| 可能存在多个根 | 先网格扫描,再逐区间求根 | 网格分辨率及不变号的根 |
| 区间内可能不连续 | 先拆分定义域 | 不能仅依赖端点异号 |
5.2.2 “足够接近”是什么意思
数值算法通常返回近似值 \(\hat x\)。常见诊断包括函数残差 \(|f(\hat x)|\)、相邻迭代步长以及括根区间宽度。对开放式方法,一个与尺度相适应的步长条件可以写成
\[ |x_{n+1}-x_n| \leq \epsilon_{\mathrm{abs}} +\epsilon_{\mathrm{rel}}\max(1,|x_{n+1}|). \]
但小步长可能只是算法停滞,小函数残差也未必意味着位置误差很小。若 \(x^\ast\) 是单根,函数受到小扰动\(\Delta f\) 时,一阶近似给出
\[ \Delta x\approx -\frac{\Delta f}{f'(x^\ast)}. \]
根附近越平坦,位置对函数误差越敏感。例如在 \(f(x)=(x-1)^3\) 中,\(x=1.001\) 的函数残差只有\(10^{-9}\),位置误差却是 \(10^{-3}\)。另一方面,把 \(f\) 乘以 \(10^{-12}\) 不会改变根,却会改变任何固定的绝对函数容差。因此,函数残差、位置变化和问题尺度应一起报告;仅凭一个布尔型的“收敛”不足以判断结果可靠。
本章的教学函数统一返回根、最终函数值、迭代次数、收敛状态、停止原因和迭代轨迹。实际项目还应记录函数评价次数、参数尺度以及算法版本。
5.3 二分法
二分法(bisection method)也称区间减半法,是一维连续函数求根中最稳健的方法之一。它的核心依据是介值定理:如果 \(f(x)\) 在区间 \([a,b]\) 上连续,且 \(f(a)\) 与 \(f(b)\) 异号,即
\[ f(a)f(b)<0, \]
那么 \([a,b]\) 内至少存在一个根。
二分法的思想很朴素:每次取区间中点,判断根落在左半区间还是右半区间,然后把区间长度缩小一半。
二分法
- 选择初始区间 \([a,b]\),确认 \(f\) 连续且两个端点函数值异号,或某个端点本身就是根。
- 计算中点 \(c=(a+b)/2\)。
- 如果函数残差或区间半宽达到相应容差,停止迭代,输出 \(c\)。
- 保留端点函数值异号的那个半区间。
- 重复第 2–4 步,直到满足停止条件。
若初始区间长度为 \(L_0=b_0-a_0\),第 \(n\) 次迭代计算的中点到区间中某个根的距离至多为
\[ \frac{L_0}{2^n}. \]
因此,二分法虽然不快,却能在运行前计算达到给定位置精度所需的迭代次数。下面的实现不使用fa * fb 判断符号,因为乘法可能上溢或下溢;它还分别记录函数残差和区间半宽。
is_finite_real_scalar <- function(x) {
  is.numeric(x) && !is.complex(x) &&
    length(x) == 1L && is.finite(x)
}

bisection_root <- function(f, a, b,
                           x_tol = 1e-8,
                           rel_tol = sqrt(.Machine$double.eps),
                           f_rel_tol = 1e-10,
                           f_scale = NULL,
                           max_iter = 100L) {
  if (!is.function(f)) stop("f 必须是函数。")
  if (!is_finite_real_scalar(a) || !is_finite_real_scalar(b) || a >= b) {
    stop("a 和 b 必须是有限标量,并满足 a < b。")
  }
  controls_ok <- vapply(
    list(x_tol, rel_tol, f_rel_tol),
    function(z) is_finite_real_scalar(z) && z >= 0,
    logical(1)
  )
  if (!all(controls_ok)) {
    stop("所有容差必须是有限的非负数。")
  }
  if (!is_finite_real_scalar(max_iter) || max_iter < 1 ||
      max_iter != floor(max_iter) || max_iter > .Machine$integer.max) {
    stop("max_iter 必须是正整数。")
  }

  eval_f <- function(x) {
    value <- f(x)
    if (!is_finite_real_scalar(value)) {
      stop("迭代过程中 f(x) 必须是有限数值标量。")
    }
    as.numeric(value)
  }
  opposite_sign <- function(x, y) {
    (x < 0 && y > 0) || (x > 0 && y < 0)
  }

  fa <- eval_f(a)
  fb <- eval_f(b)
  endpoint_trace <- function(x, fx) {
    data.frame(
      iter = 0L, lower = a, upper = b, f_lower = fa, f_upper = fb,
      x = x, fx = fx, scaled_residual = 0,
      half_width = b / 2 - a / 2
    )
  }

  if (fa == 0) {
    return(list(
      root = a, value = fa, iter = 0L, f_evals = 2L,
      converged = TRUE,
      scaled_residual = 0, reason = "左端点是精确零点。",
      bracket = c(a, b),
      trace = endpoint_trace(a, fa)
    ))
  }
  if (fb == 0) {
    return(list(
      root = b, value = fb, iter = 0L, f_evals = 2L,
      converged = TRUE,
      scaled_residual = 0, reason = "右端点是精确零点。",
      bracket = c(a, b),
      trace = endpoint_trace(b, fb)
    ))
  }
  if (!opposite_sign(fa, fb)) {
    stop("初始区间两端函数值必须异号,或某个端点为精确零点。")
  }
  if (is.null(f_scale)) f_scale <- max(abs(fa), abs(fb))
  if (!is_finite_real_scalar(f_scale) || f_scale <= 0) {
    stop("f_scale 必须是有限正数。")
  }

  trace <- data.frame(
    iter = seq_len(max_iter), lower = NA_real_, upper = NA_real_,
    f_lower = NA_real_, f_upper = NA_real_,
    x = NA_real_, fx = NA_real_, scaled_residual = NA_real_,
    half_width = NA_real_
  )

  for (iter in seq_len(max_iter)) {
    midpoint <- a / 2 + b / 2
    fm <- eval_f(midpoint)
    scaled_residual <- abs(fm) / f_scale
    half_width <- b / 2 - a / 2
    trace[iter, 2:9] <- c(
      a, b, fa, fb, midpoint, fm, scaled_residual, half_width
    )

    residual_ok <- scaled_residual <= f_rel_tol
    interval_ok <- half_width <=
      x_tol + rel_tol * max(1, abs(midpoint))
    if (residual_ok || interval_ok) {
      reason <- if (residual_ok) {
        "函数残差达到容差。"
      } else {
        "括根区间半宽达到位置容差。"
      }
      return(list(
        root = midpoint, value = fm, iter = iter,
        f_evals = iter + 2L, converged = TRUE,
        scaled_residual = scaled_residual,
        reason = reason, bracket = c(a, b),
        trace = trace[seq_len(iter), , drop = FALSE]
      ))
    }
    if (midpoint == a || midpoint == b) {
      return(list(
        root = midpoint, value = fm, iter = iter,
        f_evals = iter + 2L, converged = FALSE,
        scaled_residual = scaled_residual,
        reason = "有限精度下中点与端点重合,区间无法继续缩小。",
        bracket = c(a, b),
        trace = trace[seq_len(iter), , drop = FALSE]
      ))
    }

    if (opposite_sign(fa, fm)) {
      b <- midpoint
      fb <- fm
    } else {
      a <- midpoint
      fa <- fm
    }
  }

  list(
    root = midpoint, value = fm, iter = max_iter,
    f_evals = max_iter + 2L, converged = FALSE,
    scaled_residual = scaled_residual,
    reason = "达到最大迭代次数。", bracket = c(a, b), trace = trace
  )
}
代码中的 scaled_residual 等于 \(|f(x)|/s_f\)。默认尺度 \(s_f\) 是两个初始端点函数值绝对值的最大值,因而把整个方程乘以非零常数不会改变停止判断;如果问题有自然尺度,应通过 f_scale 明确给出。位置精度仍主要由区间半宽控制。
5.3.1 例:求 \(\sqrt 5\)
求 \(\sqrt 5\) 可以转化为求
\[ f(x)=x^2-5 \]
在区间 \([0,4]\) 上的根。
sqrt5_equation <- function(x) x^2 - 5
bis <- bisection_root(
  sqrt5_equation, a = 0, b = 4,
  x_tol = 1e-10, rel_tol = 0, f_rel_tol = 0
)

c(
  estimate = bis$root,
  residual = abs(bis$value),
  scaled_residual = bis$scaled_residual,
  iterations = bis$iter,
  absolute_error = abs(bis$root - sqrt(5))
)
#>        estimate        residual scaled_residual      iterations  absolute_error
#>       2.236e+00       2.545e-10       2.314e-11       3.600e+01       5.692e-11
bis$reason
#> [1] "括根区间半宽达到位置容差。"
在不使用函数残差提前停止的情况下,使区间中点误差界不超过 \(10^{-10}\) 所需的二分次数至多为
二分法最突出的优点是可靠并且有明确误差界;缺点是只利用函数值的符号,因而收敛速度较慢。即使算法报告成功,仍应输出 bis$value 和 bis$bracket,而不只打印 bis$root。
5.3.2 使用二分法时要注意什么
二分法看起来简单,但在实际使用时仍有几个容易忽略的问题。
第一,函数必须在区间内连续。比如 \(f(x)=1/x\) 在 \([-1,1]\) 两端异号,但 \(x=0\) 不是根,而是函数不连续点。
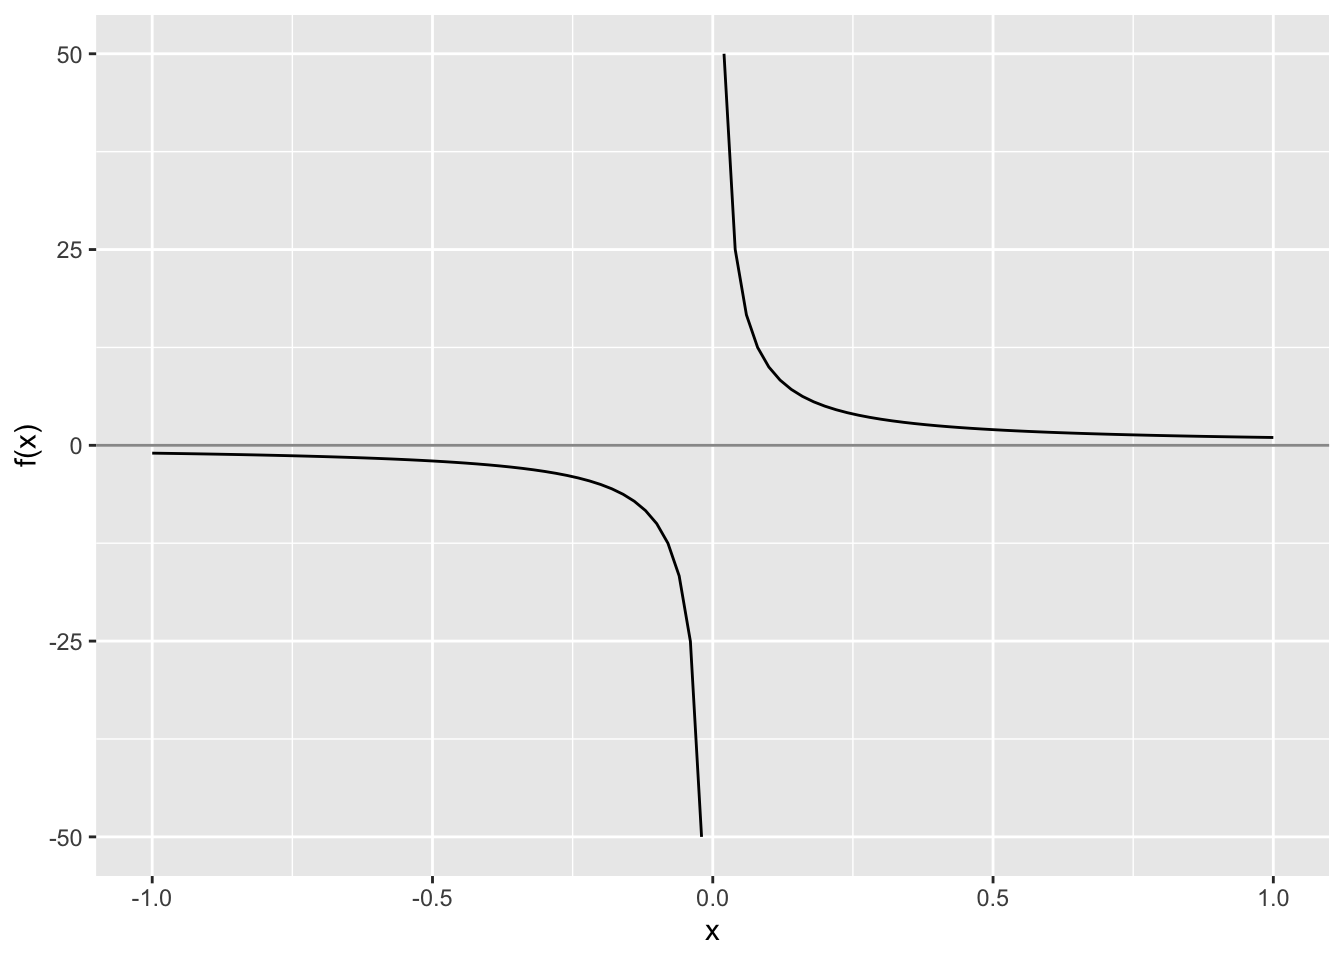
图5.1: 两端异号不一定表示中间有根:函数可能不连续
本章实现会在第一次取到 \(x=0\) 时发现函数值不是有限数并停止,而不是把靠近渐近线的点报告成根:
tryCatch(
  bisection_root(function(x) 1 / x, -1, 1),
  error = function(e) e$message
)
#> [1] "迭代过程中 f(x) 必须是有限数值标量。"
有限值检查仍不能识别所有不连续函数。例如一个从 \(-1\) 跳到 1 的阶跃函数在整个计算过程中都可能返回有限值,二分法最终只会因为区间很窄而停止,此时函数残差仍为 1。连续性必须由问题结构和图形共同确认,不能交给求根器猜测。
第二,如果根的位置只是“擦过”横轴,函数在根的两侧没有变号,二分法无法直接使用。例如 \(f(x)=x^2\) 在 \(x=0\) 有根,但任意对称区间两端函数值同号。
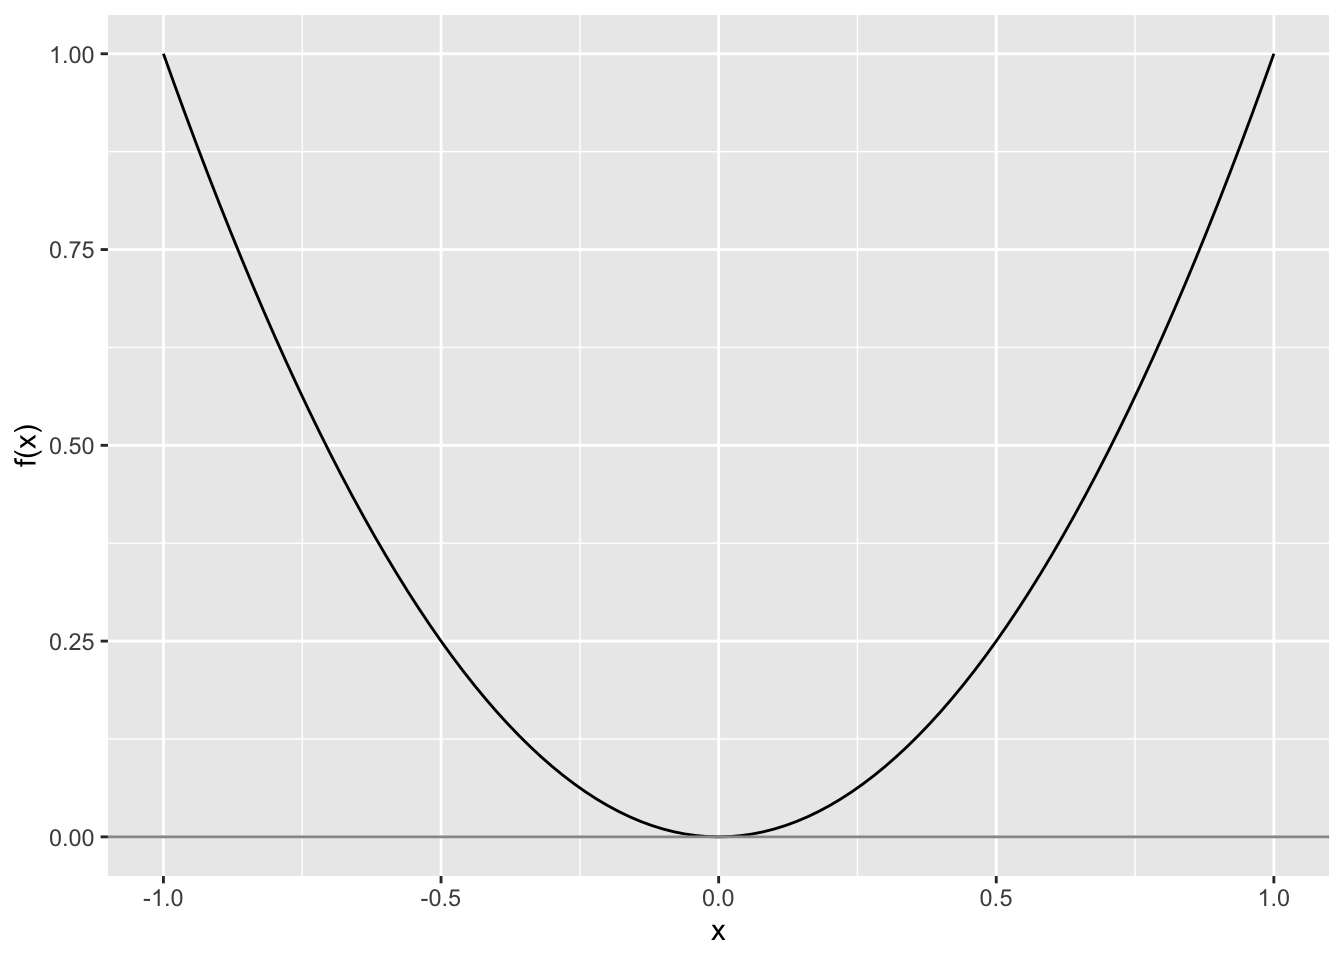
图5.2: 函数在根处没有变号时,二分法无法直接定位根
第三,如果区间内有多个根,一次二分通常只能返回其中一个。下面的辅助函数先在递增网格上寻找精确零点和相邻变号区间,然后可以对每个小区间分别调用求根器。
scan_sign_changes <- function(f, grid) {
  if (!is.function(f)) stop("f 必须是函数。")
  if (!is.numeric(grid) || length(grid) < 2L ||
      any(!is.finite(grid)) || any(diff(grid) <= 0)) {
    stop("grid 必须包含至少两个严格递增的有限数值。")
  }

  fx <- vapply(grid, function(x) {
    value <- f(x)
    if (!is.numeric(value) || length(value) != 1L || !is.finite(value)) {
      stop("网格上的函数值必须是有限数值标量。")
    }
    as.numeric(value)
  }, numeric(1))

  exact_id <- which(fx == 0)
  left <- fx[-length(fx)]
  right <- fx[-1L]
  change_id <- which(
    (left < 0 & right > 0) | (left > 0 & right < 0)
  )

  list(
    exact = data.frame(x = grid[exact_id], fx = fx[exact_id]),
    brackets = data.frame(
      lower = grid[change_id], upper = grid[change_id + 1L],
      f_lower = fx[change_id], f_upper = fx[change_id + 1L]
    )
  )
}
网格扫描不是存在性证明:网格过粗会漏掉距离很近的两个根,不变号的偶重根不会被变号检查发现,不连续点还可能制造虚假的变号。因此它应与函数定义域、图形和理论信息结合使用。
5.4 牛顿法
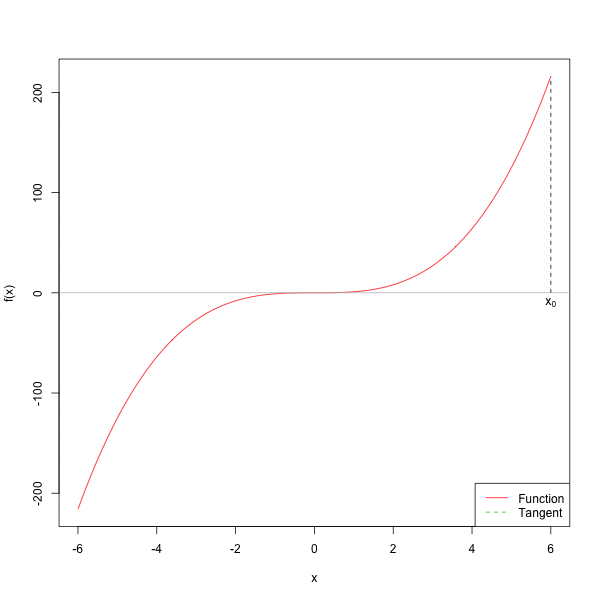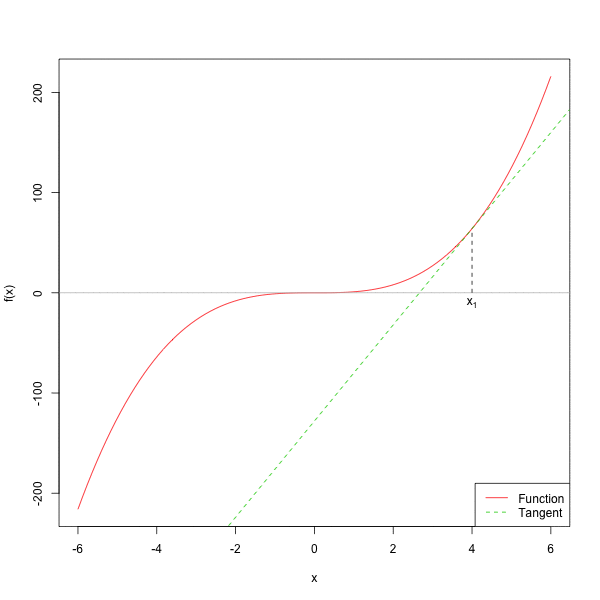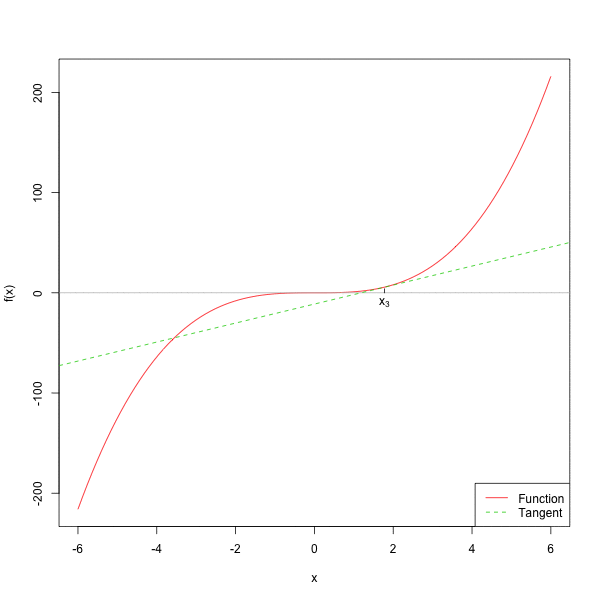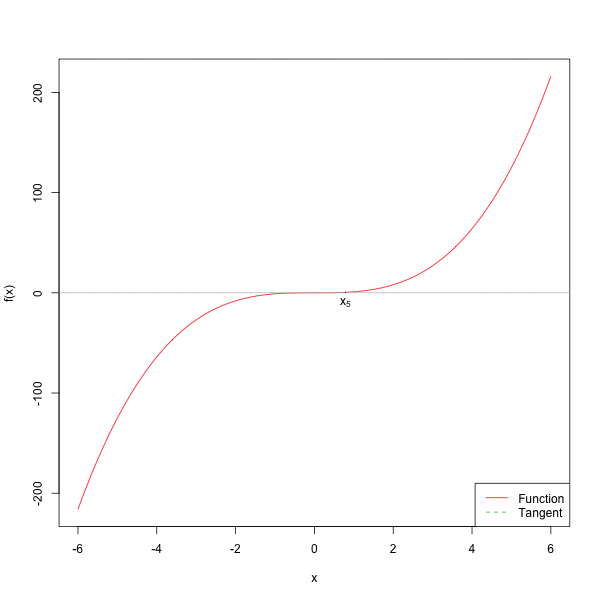
二分法可靠但慢。牛顿法(Newton method,也称 Newton–Raphson method)则通常收敛很快。它的思想是:在当前点 \(x_n\) 附近,用切线近似函数,然后取切线与横轴的交点作为新的估计。
假设 \(f\) 可导,且 \(x^\ast\) 是 \(f(x)=0\) 的根。在当前点 \(x_n\) 处做一阶泰勒展开:
\[ f(x) \approx f(x_n) + f'(x_n)(x-x_n). \]
令右边等于 0,得到
\[ x = x_n - \frac{f(x_n)}{f'(x_n)}. \]
于是牛顿法的迭代公式为
\[ x_{n+1}=x_n-\frac{f(x_n)}{f'(x_n)}. \]
牛顿法
- 选择初始点 \(x_0\)。
- 计算 \(f(x_n)\) 和 \(f'(x_n)\)。
- 检查尺度化函数残差;若达到容差,停止迭代。
- 若导数为 0、函数值不是有限数,或更新越出定义域,停止并报告失败原因。
- 更新
\[ x_{n+1}=x_n-\frac{f(x_n)}{f'(x_n)}. \]
- 检查新点的函数残差和尺度化步长;小步长但大残差应判为停滞,而不是成功。
- 重复第 2–6 步,同时限制最大迭代次数。
下面的图给出了牛顿法的几何直觉。
下面实现一个适合教学和调试的 newton_root()。这里要求用户同时给出 \(f(x)\) 和 \(f'(x)\)。函数不会把导数与固定的 .Machine$double.eps 比较,因为导数的数值会随 \(f\) 的整体缩放而改变;真正进入更新的是尺度不变的比值 \(f(x)/f'(x)\)。
newton_root <- function(f, df, x0,
                        x_tol = 1e-10,
                        rel_tol = sqrt(.Machine$double.eps),
                        f_rel_tol = 1e-10,
                        f_scale = NULL,
                        max_iter = 100L) {
  if (!is.function(f) || !is.function(df)) stop("f 和 df 必须是函数。")
  if (!is_finite_real_scalar(x0)) stop("x0 必须是有限实数标量。")
  controls_ok <- vapply(
    list(x_tol, rel_tol, f_rel_tol),
    function(z) is_finite_real_scalar(z) && z >= 0,
    logical(1)
  )
  if (!all(controls_ok)) {
    stop("所有容差必须是有限的非负数。")
  }
  if (!is_finite_real_scalar(max_iter) || max_iter < 1 ||
      max_iter != floor(max_iter) || max_iter > .Machine$integer.max) {
    stop("max_iter 必须是正整数。")
  }

  eval_scalar <- function(fun, x) {
    value <- tryCatch(fun(x), error = function(e) NA_real_)
    if (!is_finite_real_scalar(value)) {
      return(NA_real_)
    }
    as.numeric(value)
  }

  x <- as.numeric(x0)
  fx <- eval_scalar(f, x)
  if (!is.finite(fx)) stop("初始点的 f(x0) 必须是有限数值标量。")
  if (fx == 0) {
    trace <- data.frame(
      iter = 0L, x = x, fx = fx,
      scaled_residual = 0, step = NA_real_
    )
    return(list(
      root = x, value = fx, scaled_residual = 0, last_step = NA_real_,
      iter = 0L, f_evals = 1L, df_evals = 0L,
      converged = TRUE, reason = "初始点是精确零点。",
      trace = trace
    ))
  }
  if (is.null(f_scale)) f_scale <- abs(fx)
  if (!is_finite_real_scalar(f_scale) || f_scale <= 0) {
    stop("f_scale 必须是有限正数。")
  }

  scaled_residual <- abs(fx) / f_scale
  trace <- data.frame(
    iter = 0L, x = x, fx = fx,
    scaled_residual = scaled_residual, step = NA_real_
  )
  if (scaled_residual <= f_rel_tol) {
    return(list(
      root = x, value = fx, scaled_residual = scaled_residual,
      last_step = NA_real_, iter = 0L, f_evals = 1L, df_evals = 0L,
      converged = TRUE,
      reason = "尺度化函数残差达到容差。", trace = trace
    ))
  }

  for (iter in seq_len(max_iter)) {
    dfx <- eval_scalar(df, x)
    if (!is.finite(dfx) || dfx == 0) {
      return(list(
        root = x, value = fx, scaled_residual = scaled_residual,
        last_step = NA_real_, iter = iter - 1L,
        f_evals = iter, df_evals = iter, converged = FALSE,
        reason = "导数为 0 或不是有限数值。", trace = trace
      ))
    }

    step <- -fx / dfx
    x_new <- x + step
    if (!is.finite(step) || !is.finite(x_new)) {
      return(list(
        root = x, value = fx, scaled_residual = scaled_residual,
        last_step = step, iter = iter - 1L,
        f_evals = iter, df_evals = iter, converged = FALSE,
        reason = "Newton 更新不是有限数值。", trace = trace
      ))
    }

    fx_new <- eval_scalar(f, x_new)
    if (!is.finite(fx_new)) {
      trace <- rbind(trace, data.frame(
        iter = iter, x = x_new, fx = NA_real_,
        scaled_residual = NA_real_, step = step
      ))
      return(list(
        root = x, value = fx, scaled_residual = scaled_residual,
        last_step = step, iter = iter - 1L,
        f_evals = iter + 1L, df_evals = iter, converged = FALSE,
        reason = "新迭代点处的函数值无效,可能越出定义域。",
        trace = trace
      ))
    }

    scaled_new <- abs(fx_new) / f_scale
    trace <- rbind(trace, data.frame(
      iter = iter, x = x_new, fx = fx_new,
      scaled_residual = scaled_new, step = step
    ))

    if (scaled_new <= f_rel_tol) {
      return(list(
        root = x_new, value = fx_new, scaled_residual = scaled_new,
        last_step = step, iter = iter,
        f_evals = iter + 1L, df_evals = iter, converged = TRUE,
        reason = "尺度化函数残差达到容差。", trace = trace
      ))
    }
    step_small <- abs(step) <=
      x_tol + rel_tol * max(1, abs(x_new))
    if (step_small) {
      return(list(
        root = x_new, value = fx_new, scaled_residual = scaled_new,
        last_step = step, iter = iter,
        f_evals = iter + 1L, df_evals = iter, converged = FALSE,
        reason = "步长很小,但函数残差未达到容差;算法发生停滞。",
        trace = trace
      ))
    }

    x <- x_new
    fx <- fx_new
    scaled_residual <- scaled_new
  }

  list(
    root = x, value = fx, scaled_residual = scaled_residual,
    last_step = step, iter = max_iter,
    f_evals = max_iter + 1L, df_evals = max_iter, converged = FALSE,
    reason = "达到最大迭代次数。", trace = trace
  )
}
5.4.1 例:再次求 \(\sqrt 5\)
对 \(f(x)=x^2-5\),有 \(f'(x)=2x\)。
sqrt5_derivative <- function(x) 2 * x

nr <- newton_root(sqrt5_equation, sqrt5_derivative, x0 = 5)
c(
  estimate = nr$root,
  residual = abs(nr$value),
  scaled_residual = nr$scaled_residual,
  iterations = nr$iter,
  function_evaluations = nr$f_evals,
  derivative_evaluations = nr$df_evals,
  absolute_error = abs(nr$root - sqrt(5))
)
#>               estimate               residual        scaled_residual
#>              2.236e+00              8.429e-13              4.214e-14
#>             iterations   function_evaluations derivative_evaluations
#>              5.000e+00              6.000e+00              5.000e+00
#>         absolute_error
#>              1.883e-13
nr$trace
#>   iter     x        fx scaled_residual       step
#> 1    0 5.000 2.000e+01       1.000e+00         NA
#> 2    1 3.000 4.000e+00       2.000e-01 -2.000e+00
#> 3    2 2.333 4.444e-01       2.222e-02 -6.667e-01
#> 4    3 2.238 9.070e-03       4.535e-04 -9.524e-02
#> 5    4 2.236 4.106e-06       2.053e-07 -2.026e-03
#> 6    5 2.236 8.429e-13       4.214e-14 -9.181e-07
在这个例子中,牛顿法只需很少几步就得到高精度近似。这也是牛顿法在统计计算中非常常用的原因。
5.4.2 牛顿法什么时候会出问题
牛顿法快,但它不如二分法稳健。常见问题包括:
- 初始值离目标根太远,迭代可能收敛到另一个根或跑出定义域;
- 导数接近 0 时,更新步长可能非常大;
- 函数形状复杂时,迭代可能震荡或发散;
- 重根处 \(f'(x^\ast)=0\),通常会失去平方收敛;
- 如果函数不可导或导数难以计算,每次迭代的成本可能很高。
下面的例子展示周期震荡。对 \(f(x)=x^3-2x+2\),从 \(x_0=0\) 出发时,迭代依次到达 1、0、1、0,并不是因为导数在这两个点为 0,而是 Newton 映射恰好形成了二周期。
f_bad <- function(x) x^3 - 2 * x + 2
df_bad <- function(x) 3 * x^2 - 2

nr_bad <- newton_root(f_bad, df_bad, x0 = 0, max_iter = 8)
nr_bad$converged
#> [1] FALSE
nr_bad$reason
#> [1] "达到最大迭代次数。"
nr_bad$trace
#>   iter x fx scaled_residual step
#> 1    0 0  2             1.0   NA
#> 2    1 1  1             0.5    1
#> 3    2 0  2             1.0   -1
#> 4    3 1  1             0.5    1
#> 5    4 0  2             1.0   -1
#> 6    5 1  1             0.5    1
#> 7    6 0  2             1.0   -1
#> 8    7 1  1             0.5    1
#> 9    8 0  2             1.0   -1
如果参数必须为正,直接在原尺度上迭代还可能产生负值。一种常见策略是令 \(x=\exp(\eta)\),改在无约束的 \(\eta\) 尺度求根;另一种策略是在 Newton 步越出可信区间时缩短步长或回退到二分法。这正是混合算法兼顾速度与可靠性的基本思想。
5.5 割线法(拓展)
牛顿法需要导数。如果导数不好写或计算成本较高,可以使用割线法(secant method)。割线法用最近两个点的函数值近似导数:
\[ f'(x_n)\approx \frac{f(x_n)-f(x_{n-1})}{x_n-x_{n-1}}. \]
代入牛顿法公式,得到
\[ x_{n+1}=x_n-f(x_n)\frac{x_n-x_{n-1}}{f(x_n)-f(x_{n-1})}. \]
割线法不保证像二分法那样稳健,但通常比二分法快,而且不需要显式导数。由于它没有始终保留括根区间,两个函数值过于接近时会产生不可靠的大步长。
secant_root <- function(f, x0, x1,
                        x_tol = 1e-10,
                        rel_tol = sqrt(.Machine$double.eps),
                        f_rel_tol = 1e-10,
                        f_scale = NULL,
                        max_iter = 100L) {
  if (!is.function(f)) stop("f 必须是函数。")
  if (!is_finite_real_scalar(x0) || !is_finite_real_scalar(x1)) {
    stop("x0 和 x1 必须是有限实数标量。")
  }
  controls_ok <- vapply(
    list(x_tol, rel_tol, f_rel_tol),
    function(z) is_finite_real_scalar(z) && z >= 0,
    logical(1)
  )
  if (!all(controls_ok)) {
    stop("所有容差必须是有限的非负数。")
  }
  if (!is_finite_real_scalar(max_iter) || max_iter < 1 ||
      max_iter != floor(max_iter) || max_iter > .Machine$integer.max) {
    stop("max_iter 必须是正整数。")
  }

  eval_f <- function(x) {
    value <- tryCatch(f(x), error = function(e) NA_real_)
    if (!is_finite_real_scalar(value)) {
      return(NA_real_)
    }
    as.numeric(value)
  }

  x0 <- as.numeric(x0)
  x1 <- as.numeric(x1)
  f0 <- eval_f(x0)
  if (!is.finite(f0)) stop("f(x0) 必须是有限数值标量。")
  if (f0 == 0) {
    trace <- data.frame(
      iter = 0L, x = x0, fx = f0,
      scaled_residual = 0, step = NA_real_
    )
    return(list(
      root = x0, value = f0, scaled_residual = 0,
      last_step = NA_real_, iter = 0L, f_evals = 1L,
      converged = TRUE, reason = "x0 是精确零点。", trace = trace
    ))
  }

  f1 <- eval_f(x1)
  if (!is.finite(f1)) stop("f(x1) 必须是有限数值标量。")
  if (is.null(f_scale)) f_scale <- max(abs(f0), abs(f1))
  if (!is_finite_real_scalar(f_scale) || f_scale <= 0) {
    stop("f_scale 必须是有限正数。")
  }
  trace <- data.frame(
    iter = c(0L, 0L), x = c(x0, x1), fx = c(f0, f1),
    scaled_residual = abs(c(f0, f1)) / f_scale,
    step = c(NA_real_, x1 - x0)
  )
  if (f1 == 0) {
    return(list(
      root = x1, value = f1, scaled_residual = 0,
      last_step = x1 - x0, iter = 0L, f_evals = 2L,
      converged = TRUE, reason = "x1 是精确零点。", trace = trace
    ))
  }

  for (iter in seq_len(max_iter)) {
    local_scale <- max(abs(f0), abs(f1))
    f0_scaled <- f0 / local_scale
    f1_scaled <- f1 / local_scale
    denom_scaled <- f1_scaled - f0_scaled
    denom_unreliable <- !is.finite(denom_scaled) ||
      abs(denom_scaled) <= 8 * .Machine$double.eps
    if (denom_unreliable) {
      return(list(
        root = x1, value = f1,
        scaled_residual = abs(f1) / f_scale,
        last_step = NA_real_, iter = iter - 1L,
        f_evals = iter + 1L, converged = FALSE,
        reason = "相邻函数值在当前精度下无法形成可靠割线。",
        trace = trace
      ))
    }

    step <- -(f1_scaled / denom_scaled) * (x1 - x0)
    x2 <- x1 + step
    if (!is.finite(step) || !is.finite(x2)) {
      return(list(
        root = x1, value = f1,
        scaled_residual = abs(f1) / f_scale,
        last_step = step, iter = iter - 1L,
        f_evals = iter + 1L, converged = FALSE,
        reason = "割线更新不是有限数值。", trace = trace
      ))
    }

    f2 <- eval_f(x2)
    if (!is.finite(f2)) {
      trace <- rbind(trace, data.frame(
        iter = iter, x = x2, fx = NA_real_,
        scaled_residual = NA_real_, step = step
      ))
      return(list(
        root = x1, value = f1,
        scaled_residual = abs(f1) / f_scale,
        last_step = step, iter = iter - 1L,
        f_evals = iter + 2L, converged = FALSE,
        reason = "新迭代点处的函数值无效,可能越出定义域。",
        trace = trace
      ))
    }

    scaled_new <- abs(f2) / f_scale
    trace <- rbind(trace, data.frame(
      iter = iter, x = x2, fx = f2,
      scaled_residual = scaled_new, step = step
    ))
    if (scaled_new <= f_rel_tol) {
      return(list(
        root = x2, value = f2, scaled_residual = scaled_new,
        last_step = step, iter = iter, f_evals = iter + 2L,
        converged = TRUE, reason = "尺度化函数残差达到容差。",
        trace = trace
      ))
    }
    step_small <- abs(step) <=
      x_tol + rel_tol * max(1, abs(x2))
    if (step_small) {
      return(list(
        root = x2, value = f2, scaled_residual = scaled_new,
        last_step = step, iter = iter, f_evals = iter + 2L,
        converged = FALSE,
        reason = "步长很小,但函数残差未达到容差;算法发生停滞。",
        trace = trace
      ))
    }

    x0 <- x1
    f0 <- f1
    x1 <- x2
    f1 <- f2
  }

  list(
    root = x1, value = f1, scaled_residual = abs(f1) / f_scale,
    last_step = step, iter = max_iter, f_evals = max_iter + 2L,
    converged = FALSE, reason = "达到最大迭代次数。", trace = trace
  )
}
sec <- secant_root(sqrt5_equation, x0 = 2, x1 = 5)
c(
estimate = sec$root,
residual = abs(sec$value),
scaled_residual = sec$scaled_residual,
updates = sec$iter,
function_evaluations = sec$f_evals
)
#> estimate residual scaled_residual
#> 2.236e+00 6.217e-15 3.109e-16
#> updates function_evaluations
#> 6.000e+00 8.000e+005.6 实际求解与方法比较
R 自带的 uniroot() 是实际工作中常用的一维求根工具。它要求连续函数和变号区间,内部使用保留括根区间的插值策略,并在需要时回退到更稳健的区间步骤。与手写教学函数相比,它通常兼顾可靠性与速度。下面显式指定精度并要求把不收敛作为错误处理:
uni <- uniroot(
  sqrt5_equation,
  interval = c(0, 4),
  tol = 1e-12,
  check.conv = TRUE
)

c(
  estimate = uni$root,
  function_value = uni$f.root,
  estimated_precision = uni$estim.prec,
  iterations = uni$iter
)
#>            estimate      function_value estimated_precision          iterations
#>           2.236e+00           7.727e-13           5.009e-13           8.000e+00
stopifnot(abs(uni$root - sqrt(5)) < 1e-10)
uniroot() 的停止判断主要针对 \(x\) 的变化,所以仍应检查 f.root。参数 extendInt 可以自动扩展区间,但只有在定义域和函数穿越方向明确时才适合使用;盲目扩展区间可能越过不连续点或进入数值下溢区域。
5.6.1 怎样公平比较算法
只比较迭代次数并不公平:二分法每步通常新增一次函数评价,Newton 每步还需要一次导数评价,割线法需要两个起点,而混合算法的每一步可能采用不同操作。下面在同一个问题上一次性保存四种结果,同时报告实际误差、函数评价和导数评价。
bis_cmp <- bisection_root(
  sqrt5_equation, 0, 4,
  x_tol = 1e-12, rel_tol = 0, f_rel_tol = 0
)
newton_cmp <- newton_root(
  sqrt5_equation, sqrt5_derivative, 5,
  x_tol = 1e-12, rel_tol = 0, f_rel_tol = 1e-12
)
secant_cmp <- secant_root(
  sqrt5_equation, 2, 5,
  x_tol = 1e-12, rel_tol = 0, f_rel_tol = 1e-12
)

uniroot_counter <- new.env(parent = emptyenv())
uniroot_counter$n <- 0L
counted_sqrt5 <- function(x) {
  uniroot_counter$n <- uniroot_counter$n + 1L
  sqrt5_equation(x)
}
uni_cmp <- uniroot(
  counted_sqrt5, c(0, 4), tol = 1e-12, check.conv = TRUE
)

method_comparison <- data.frame(
  method = c("Bisection", "Newton", "Secant", "uniroot"),
  estimate = c(
    bis_cmp$root, newton_cmp$root,
    secant_cmp$root, uni_cmp$root
  ),
  absolute_error = abs(c(
    bis_cmp$root, newton_cmp$root,
    secant_cmp$root, uni_cmp$root
  ) - sqrt(5)),
  absolute_residual = abs(c(
    bis_cmp$value, newton_cmp$value,
    secant_cmp$value, uni_cmp$f.root
  )),
  iterations_or_updates = c(
    bis_cmp$iter, newton_cmp$iter,
    secant_cmp$iter, uni_cmp$iter
  ),
  function_evaluations = c(
    bis_cmp$f_evals, newton_cmp$f_evals,
    secant_cmp$f_evals, uniroot_counter$n
  ),
  derivative_evaluations = c(0L, newton_cmp$df_evals, 0L, 0L)
)

method_comparison_display <- transform(
  method_comparison,
  estimate = formatC(estimate, format = "f", digits = 12),
  absolute_error = formatC(absolute_error, format = "e", digits = 3),
  absolute_residual = formatC(absolute_residual, format = "e", digits = 3)
)
knitr::kable(
  method_comparison_display,
  row.names = FALSE,
  col.names = c(
    "方法", "根估计", "绝对误差", "绝对残差",
    "迭代或更新次数", "函数评价次数", "导数评价次数"
  )
)| 方法 | 根估计 | 绝对误差 | 绝对残差 | 迭代或更新次数 | 函数评价次数 | 导数评价次数 |
|---|---|---|---|---|---|---|
| Bisection | 2.236067977500 | 3.801e-13 | 1.701e-12 | 42 | 44 | 0 |
| Newton | 2.236067977500 | 1.883e-13 | 8.429e-13 | 5 | 6 | 5 |
| Secant | 2.236067977500 | 1.332e-15 | 6.217e-15 | 6 | 8 | 0 |
| uniroot | 2.236067977500 | 1.728e-13 | 7.727e-13 | 8 | 11 | 0 |
迭代轨迹比最终迭代次数更能说明收敛行为。图中纵轴是真实根已知时的绝对误差;在真实问题中,这一误差通常不可直接计算,需要用区间宽度、步长和残差代替。
trace_error <- function(result, method) {
  data.frame(
    method = method,
    step_index = seq_len(nrow(result$trace)) - 1L,
    error = pmax(
      abs(result$trace$x - sqrt(5)),
      .Machine$double.eps
    )
  )
}

convergence_trace <- rbind(
  trace_error(bis_cmp, "Bisection"),
  trace_error(newton_cmp, "Newton"),
  trace_error(secant_cmp, "Secant")
)

ggplot(convergence_trace, aes(step_index, error, color = method)) +
  geom_line(linewidth = 0.7) +
  geom_point(size = 1.4) +
  scale_y_log10() +
  labs(x = "Iteration index", y = "Absolute error", color = "Method") +
  theme_minimal()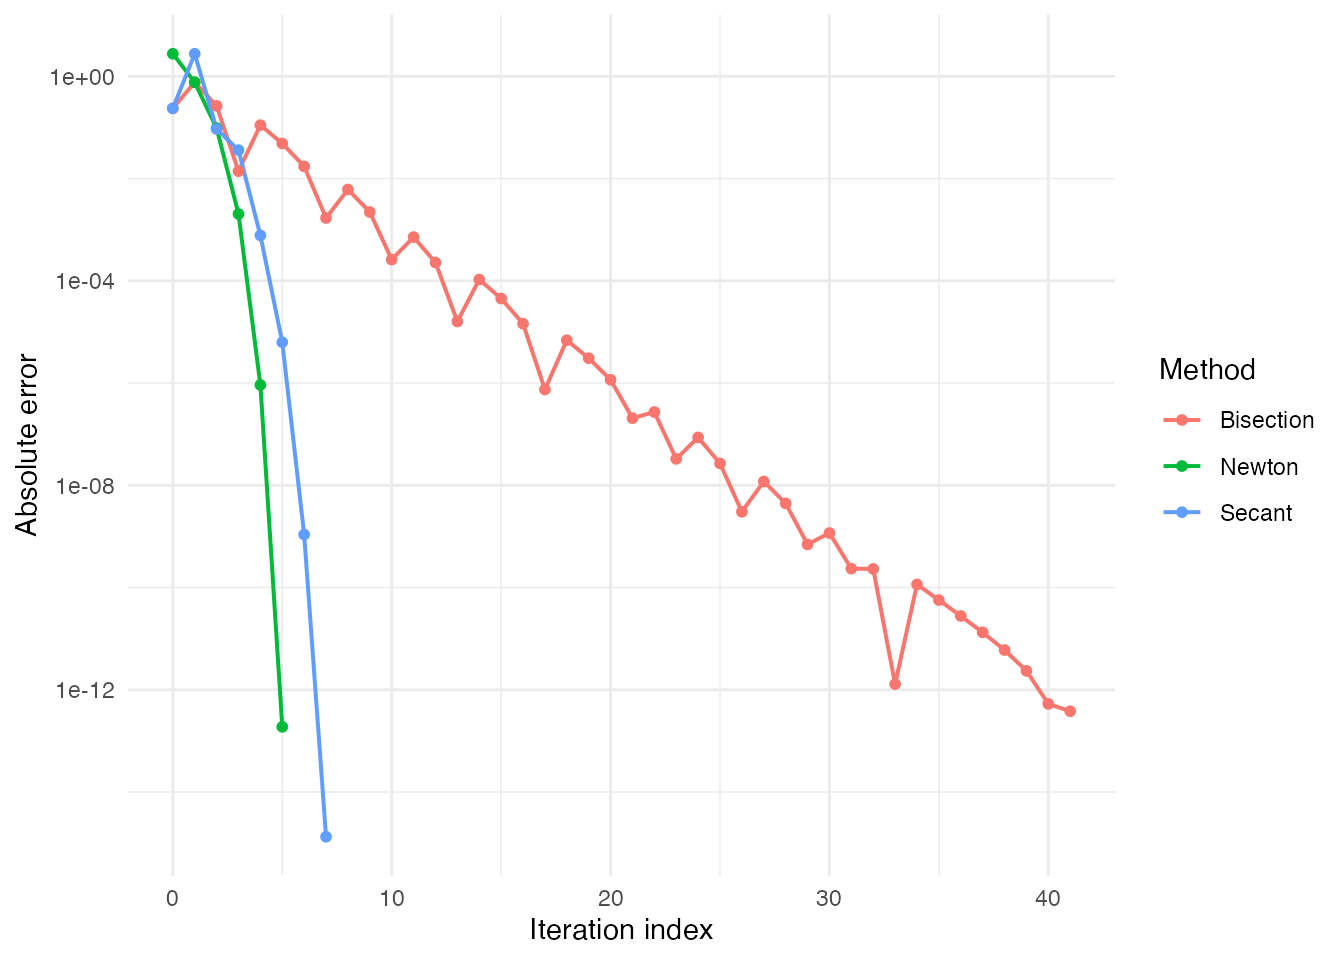
图5.3: 三种教学算法求解平方根问题时的迭代误差
5.6.2 数值检查:方程缩放不应改变根
同一个方程乘以非零常数后,根和迭代路径不应改变。下面把 \(x^2-5\) 分别乘以 \(10^{-20}\)、1 和\(10^{20}\);尺度化残差使三种教学算法保持一致。
scale_factors <- c(1e-20, 1, 1e20)

scaling_check <- do.call(rbind, lapply(scale_factors, function(s) {
  scaled_f <- function(x) s * sqrt5_equation(x)
  scaled_df <- function(x) s * sqrt5_derivative(x)
  fits <- list(
    Bisection = bisection_root(
      scaled_f, 0, 4, x_tol = 1e-10,
      rel_tol = 0, f_rel_tol = 1e-12
    ),
    Newton = newton_root(
      scaled_f, scaled_df, 5,
      rel_tol = 0, f_rel_tol = 1e-12
    ),
    Secant = secant_root(
      scaled_f, 2, 5,
      rel_tol = 0, f_rel_tol = 1e-12
    )
  )
  data.frame(
    scale = s,
    method = names(fits),
    estimate = vapply(fits, function(z) z$root, numeric(1)),
    iterations = vapply(fits, function(z) z$iter, integer(1)),
    converged = vapply(fits, function(z) z$converged, logical(1)),
    row.names = NULL
  )
}))

stopifnot(
  all(scaling_check$converged),
  max(abs(scaling_check$estimate - sqrt(5))) < 1e-8
)
scaling_check$absolute_error <- abs(scaling_check$estimate - sqrt(5))
scaling_check_display <- transform(
  scaling_check,
  scale = formatC(scale, format = "e", digits = 0),
  estimate = formatC(estimate, format = "f", digits = 12),
  absolute_error = formatC(absolute_error, format = "e", digits = 3)
)
knitr::kable(
  scaling_check_display,
  row.names = FALSE,
  col.names = c("缩放倍数", "方法", "根估计", "迭代次数", "收敛", "绝对误差")
)| 缩放倍数 | 方法 | 根估计 | 迭代次数 | 收敛 | 绝对误差 |
|---|---|---|---|---|---|
| 1e-20 | Bisection | 2.236067977501 | 34 | TRUE | 1.290e-12 |
| 1e-20 | Newton | 2.236067977500 | 5 | TRUE | 1.883e-13 |
| 1e-20 | Secant | 2.236067977500 | 6 | TRUE | 1.332e-15 |
| 1e+00 | Bisection | 2.236067977501 | 34 | TRUE | 1.290e-12 |
| 1e+00 | Newton | 2.236067977500 | 5 | TRUE | 1.883e-13 |
| 1e+00 | Secant | 2.236067977500 | 6 | TRUE | 1.332e-15 |
| 1e+20 | Bisection | 2.236067977501 | 34 | TRUE | 1.290e-12 |
| 1e+20 | Newton | 2.236067977500 | 5 | TRUE | 1.883e-13 |
| 1e+20 | Secant | 2.236067977500 | 6 | TRUE | 1.332e-15 |
5.7 应用案例
5.7.1 项目内部收益率:括根与多根
对现金流 \(C_0,C_1,\ldots,C_T\),贴现率为 \(r\) 时的净现值为
\[ \operatorname{NPV}(r) =\sum_{t=0}^T\frac{C_t}{(1+r)^t}, \qquad r>-1. \]
内部收益率(IRR)是满足 \(\operatorname{NPV}(r)=0\) 的贴现率。定义域 \(r>-1\) 不是算法自动知道的,必须由使用者提供。
npv <- function(rate, cash_flow) {
  if (!is.numeric(cash_flow) || is.complex(cash_flow) ||
      length(cash_flow) < 2L || any(!is.finite(cash_flow))) {
    stop("cash_flow 必须是至少含两个元素的有限实数向量。")
  }
  time <- seq_along(cash_flow) - 1L
  vapply(rate, function(r) {
    if (!is_finite_real_scalar(r) || r <= -1) return(NA_real_)
    sum(cash_flow / (1 + r)^time)
  }, numeric(1))
}

cash_flow_regular <- c(-100, 30, 40, 50)
regular_target <- function(r) npv(r, cash_flow_regular)
irr_regular <- uniroot(
  regular_target, c(0, 1), tol = 1e-12, check.conv = TRUE
)

data.frame(
  irr = irr_regular$root,
  npv_residual = irr_regular$f.root,
  estimated_precision = irr_regular$estim.prec
)
#>       irr npv_residual estimated_precision
#> 1 0.08896    7.105e-15           9.417e-13
上面的现金流先负后正,NPV 在定义域内单调下降,因而变号根是唯一的。非常规现金流则可能有多个IRR。对 \((-100,230,-132)\),先用网格寻找全部候选变号区间:
cash_flow_multiple <- c(-100, 230, -132)
multiple_target <- function(r) npv(r, cash_flow_multiple)

irr_scan <- scan_sign_changes(
  multiple_target,
  seq(0.071, 0.229, length.out = 101)
)
irr_scan$brackets
#>     lower  upper   f_lower   f_upper
#> 1 0.09944 0.1010 -0.004659  0.008328
#> 2 0.19898 0.2006  0.007023 -0.003907

multiple_irr <- vapply(seq_len(nrow(irr_scan$brackets)), function(j) {
  interval <- unlist(irr_scan$brackets[j, c("lower", "upper")])
  uniroot(
    multiple_target, interval,
    tol = 1e-12, check.conv = TRUE
  )$root
}, numeric(1))

irr_multiple_result <- data.frame(
  irr = multiple_irr,
  npv_residual = multiple_target(multiple_irr)
)
stopifnot(
  length(multiple_irr) == 2L,
  max(abs(sort(multiple_irr) - c(0.1, 0.2))) < 1e-10
)
knitr::kable(irr_multiple_result, digits = 12, row.names = FALSE)| irr | npv_residual |
|---|---|
| 0.1 | 0 |
| 0.2 | 0 |
irr_plot_data <- rbind(
  data.frame(
    rate = seq(0, 0.35, length.out = 300),
    NPV = npv(seq(0, 0.35, length.out = 300), cash_flow_regular),
    cash_flow_type = "Conventional"
  ),
  data.frame(
    rate = seq(0.05, 0.25, length.out = 300),
    NPV = npv(seq(0.05, 0.25, length.out = 300), cash_flow_multiple),
    cash_flow_type = "Non-conventional"
  )
)

ggplot(irr_plot_data, aes(rate, NPV)) +
  geom_hline(yintercept = 0, color = "gray65") +
  geom_line(color = "#2C7FB8", linewidth = 0.8) +
  facet_wrap(~cash_flow_type, scales = "free_y") +
  labs(x = "Discount rate", y = "Net present value") +
  theme_minimal()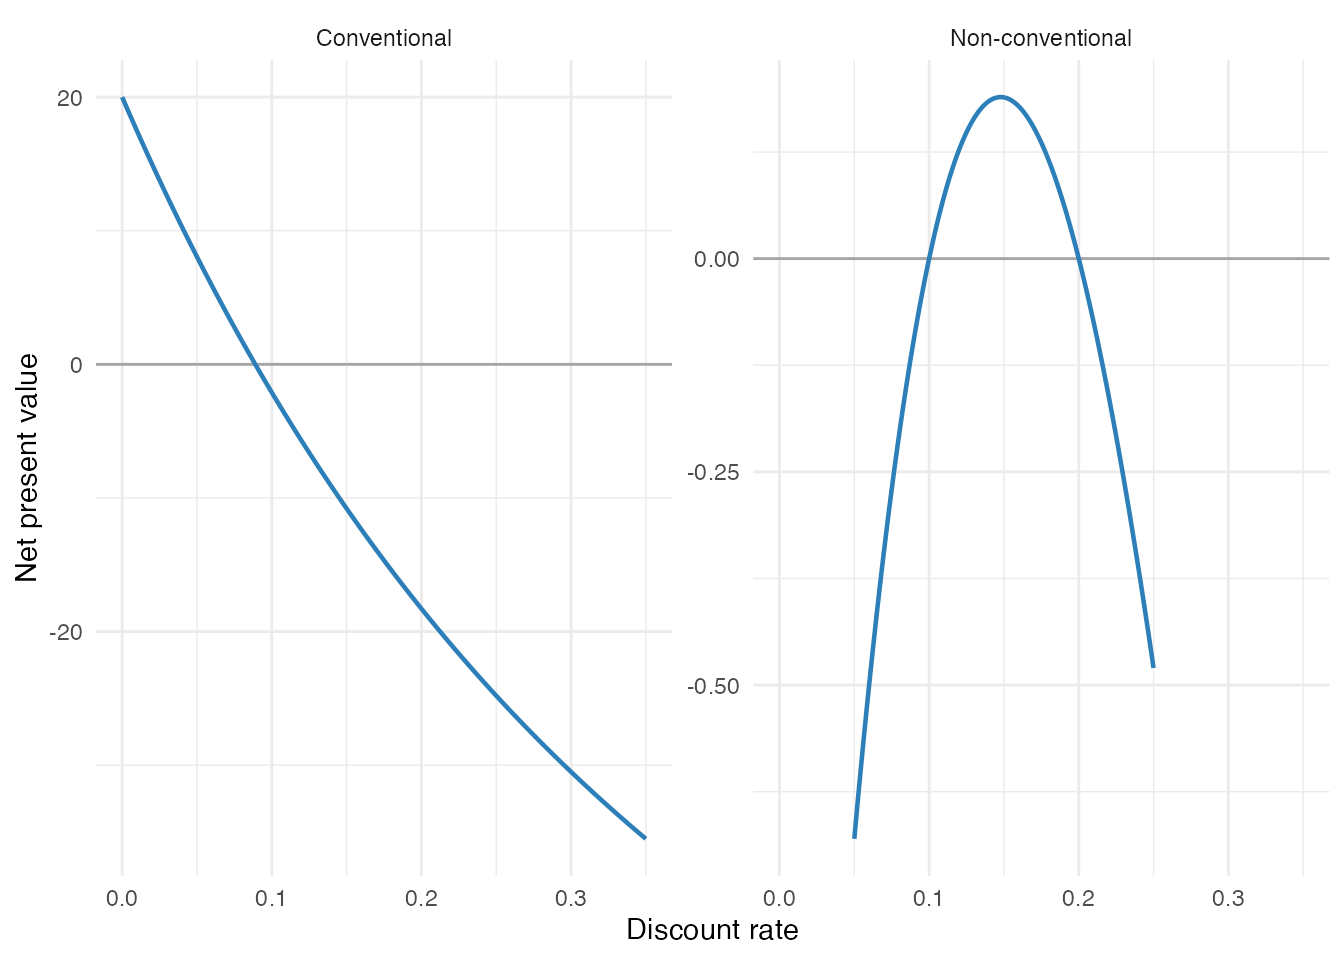
图5.4: 常规与非常规现金流的净现值曲线
数值算法可以找到 10% 和 20% 两个根,却不能决定“哪个 IRR 正确”。多 IRR 是现金流结构带来的经济解释问题,此时应回到给定资本成本下的 NPV,而不能机械挑选某个根。
5.7.2 Gamma 模型的极大似然估计
假设随机变量\(X_1,\ldots,X_n\overset{\mathrm{iid}}{\sim}\operatorname{Gamma}(\alpha,\beta)\),其中 \(\alpha\) 是形状参数,\(\beta\) 是速率参数;其观测值记为 \(x_1,\ldots,x_n\)。将 \(\beta\) 剖面化为\(\hat\beta(\alpha)=\alpha/\bar x\) 后,\(\alpha\) 满足
\[ g(\alpha) =\log(\alpha)-\psi(\alpha) -\left\{\log(\bar x)-\overline{\log x}\right\}=0, \qquad \alpha>0, \]
其中 \(\bar x=n^{-1}\sum_{i=1}^n x_i\),\(\overline{\log x}=n^{-1}\sum_{i=1}^n\log x_i\),\(\psi\) 是 digamma 函数。由 Jensen 不等式,花括号内的量非负;对非退化样本它为正,而且\(g'(\alpha)=1/\alpha-\psi_1(\alpha)<0\),所以存在唯一有限根。为自动满足 \(\alpha>0\),下面令\(\eta=\log\alpha\),在 \(\eta\) 尺度上求根。
set.seed(2026)
spending_k <- rgamma(300, shape = 4, rate = 0.8)

if (any(!is.finite(spending_k)) || any(spending_k <= 0)) {
  stop("Gamma 样本必须严格为正且有限。")
}
c_value <- log(mean(spending_k)) - mean(log(spending_k))
if (c_value <= 100 * .Machine$double.eps) {
  stop("样本近乎常数,不存在稳定的有限 shape 估计。")
}

shape_score_eta <- function(eta) {
  alpha <- exp(eta)
  eta - digamma(alpha) - c_value
}

bracket_decreasing_root <- function(f, center,
                                    half_width = 1,
                                    max_expand = 20L) {
  for (j in seq_len(max_expand)) {
    interval <- center + c(-half_width, half_width)
    values <- vapply(interval, f, numeric(1))
    if (all(is.finite(values)) && values[1] >= 0 && values[2] <= 0) {
      return(interval)
    }
    half_width <- 2 * half_width
  }
  stop("未能为单调下降方程找到变号区间。")
}

alpha_mom <- mean(spending_k)^2 / var(spending_k)
eta_interval <- bracket_decreasing_root(
  shape_score_eta, center = log(alpha_mom)
)
eta_fit <- uniroot(
  shape_score_eta, eta_interval,
  tol = 1e-12, check.conv = TRUE
)
alpha_hat <- exp(eta_fit$root)
beta_hat <- alpha_hat / mean(spending_k)

gamma_estimates <- data.frame(
  parameter = c("shape alpha", "rate beta"),
  generating_value = c(4, 0.8),
  estimate = c(alpha_hat, beta_hat)
)
knitr::kable(gamma_estimates, digits = 6, row.names = FALSE)| parameter | generating_value | estimate |
|---|---|---|
| shape alpha | 4.0 | 4.5480 |
| rate beta | 0.8 | 0.8891 |
gamma_diagnostics <- c(
  score_residual = shape_score_eta(eta_fit$root),
  profile_score_derivative = 1 / alpha_hat - trigamma(alpha_hat),
  lower_eta = eta_interval[1],
  upper_eta = eta_interval[2]
)
gamma_diagnostics
#>           score_residual profile_score_derivative                lower_eta
#>               -2.220e-16               -2.593e-02                5.348e-01
#>                upper_eta
#>                2.535e+00
stopifnot(
  abs(gamma_diagnostics["score_residual"]) < 1e-9,
  gamma_diagnostics["profile_score_derivative"] < 0
)
这里能够把 score 根判定为唯一的 profile MLE 候选,是因为方程单调穿过 0;一般模型中的 score 根还可能是极小点、鞍点,或者不如边界解。近乎常数的样本会把 \(\hat\alpha\) 推向很大数值,并使log(alpha) - digamma(alpha) 发生消减误差,实际软件需要进一步使用渐近展开或专用估计算法。
5.7.3 混合状态损失分布的分位数
设损失变量在正常状态和压力状态下服从不同正态分布,其混合分布函数为
\[ F_L(\ell) =0.85\Phi\!\left(\frac{\ell-1}{0.8}\right) +0.15\Phi\!\left(\frac{\ell-5}{1.5}\right). \]
概率水平 \(p\) 下的风险价值(VaR)是方程 \(F_L(q_p)-p=0\) 的根。
loss_cdf <- function(loss) {
  0.85 * pnorm(loss, mean = 1, sd = 0.8) +
    0.15 * pnorm(loss, mean = 5, sd = 1.5)
}

probability_levels <- c(0.90, 0.95, 0.99)
loss_quantiles <- vapply(probability_levels, function(p) {
  uniroot(
    function(q) loss_cdf(q) - p,
    c(-5, 15), tol = 1e-12, check.conv = TRUE
  )$root
}, numeric(1))

quantile_result <- data.frame(
  probability = probability_levels,
  quantile = loss_quantiles,
  cdf_at_quantile = loss_cdf(loss_quantiles),
  residual = loss_cdf(loss_quantiles) - probability_levels
)
stopifnot(max(abs(quantile_result$residual)) < 1e-10)
knitr::kable(quantile_result, digits = 10, row.names = FALSE)| probability | quantile | cdf_at_quantile | residual |
|---|---|---|---|
| 0.90 | 4.354 | 0.90 | 0 |
| 0.95 | 5.646 | 0.95 | 0 |
| 0.99 | 7.252 | 0.99 | 0 |
这个计算假设混合分布及其参数已经给定,并没有计入模型估计误差。当尾部密度很小时,分位数方程在根附近较平坦,CDF 的微小误差可能转化为更明显的分位数误差,这正是前面根条件性公式的统计例子。
5.7.4 分类概率的截距再校准(拓展)
设已有分类模型给出 logit 得分 \(\eta_i\)。当部署总体的目标发生率为 \(\pi^\ast\) 时,可以只调整截距\(\delta\),使
\[ \frac{1}{n}\sum_{i=1}^n \operatorname{logit}^{-1}(\eta_i+\delta)-\pi^\ast=0. \]
左侧关于 \(\delta\) 单调递增,因此对 \(0<\pi^\ast<1\) 有唯一有限根。
set.seed(2027)
logit_score <- rnorm(800, mean = -1, sd = 1.1)
target_rates <- c(0.05, 0.15, 0.30)

delta_hat <- vapply(target_rates, function(target_rate) {
  calibration_equation <- function(delta) {
    mean(plogis(logit_score + delta)) - target_rate
  }
  uniroot(
    calibration_equation, c(-20, 20),
    tol = 1e-12, check.conv = TRUE
  )$root
}, numeric(1))

calibration_result <- data.frame(
  target_rate = target_rates,
  intercept_shift = delta_hat,
  calibrated_mean = vapply(delta_hat, function(delta) {
    mean(plogis(logit_score + delta))
  }, numeric(1))
)
stopifnot(
  max(abs(calibration_result$calibrated_mean - target_rates)) < 1e-10
)
knitr::kable(calibration_result, digits = 8, row.names = FALSE)| target_rate | intercept_shift | calibrated_mean |
|---|---|---|
| 0.05 | -2.4445 | 0.05 |
| 0.15 | -1.1073 | 0.15 |
| 0.30 | -0.0623 | 0.30 |
这一步只校准总体平均概率,不会自动修复排序能力、协变量漂移或分组校准误差。数值方程得到满足,仍不等于整个预测模型已经适合新的部署人群。
5.8 收敛速度与重根(拓展)
设 \(e_n=|x_n-x^\ast|\)。如果存在 \(p\geq1\) 和 \(0<C<\infty\),使
\[ \lim_{n\to\infty}\frac{e_{n+1}}{e_n^p}=C, \]
则称迭代具有 \(p\) 阶收敛。当 \(p=1\) 且 \(C<1\) 时是线性收敛;\(p>1\) 时是超线性收敛。对足够光滑的函数和简单根,在初值充分接近根时,Newton 法通常二阶收敛,割线法的阶约为\((1+\sqrt5)/2\approx1.618\)。二分法严格减半的是括根区间宽度;中点实际误差的相邻比值不一定收敛到 \(1/2\)。
这些结论都是局部结论,不能保证算法从任意初值收敛。如果 \(x^\ast\) 是重数为 \(m>1\) 的根,普通Newton 法通常退化为
\[ e_{n+1}\approx\frac{m-1}{m}e_n. \]
例如对 \(f(x)=(x-1)^2\),从 \(x_0=2\) 出发时误差大约每次减半:
double_root_fit <- newton_root(
  function(x) (x - 1)^2,
  function(x) 2 * (x - 1),
  x0 = 2,
  f_rel_tol = 1e-12,
  max_iter = 50
)

double_root_trace <- transform(
  double_root_fit$trace,
  error = abs(x - 1)
)
double_root_trace$error_ratio <- c(
  NA_real_,
  double_root_trace$error[-1L] /
    double_root_trace$error[-nrow(double_root_trace)]
)
knitr::kable(
  head(double_root_trace[, c("iter", "x", "error", "error_ratio")], 10),
  digits = 8,
  row.names = FALSE
)| iter | x | error | error_ratio |
|---|---|---|---|
| 0 | 2.000 | 1.000000 | NA |
| 1 | 1.500 | 0.500000 | 0.5 |
| 2 | 1.250 | 0.250000 | 0.5 |
| 3 | 1.125 | 0.125000 | 0.5 |
| 4 | 1.062 | 0.062500 | 0.5 |
| 5 | 1.031 | 0.031250 | 0.5 |
| 6 | 1.016 | 0.015625 | 0.5 |
| 7 | 1.008 | 0.007812 | 0.5 |
| 8 | 1.004 | 0.003906 | 0.5 |
| 9 | 1.002 | 0.001953 | 0.5 |
若重数 \(m\) 已知,修正迭代\(x_{n+1}=x_n-m f(x_n)/f'(x_n)\) 可以恢复局部平方收敛。但真实统计问题中通常并不知道重数,因此更重要的是识别收敛变慢和根附近条件性变差。
5.9 进一步阅读
关于统计问题中的一维求根、估计方程与数值诊断,可参见 Monahan (2011) 和Gentle (2009);Newton 法、保护步和全局化策略与下一章的优化方法密切相关,可参见Nocedal and Wright (2006);有限精度、停止准则和数值稳定性可参见 Higham (2002)。
5.10 本章小结
一维求根不是“调用一个函数并读取 $root”,而是从定义域、连续性和候选区间开始的完整分析。二分法和 uniroot() 利用变号区间提供全局可靠性;Newton 法在简单根附近很快,但依赖导数、初值和定义域;割线法不需要导数,却仍可能出现不可靠的大步长。实际工作中,有连续函数和变号区间时通常优先使用 uniroot(),手写算法主要用于理解和诊断。
可靠报告至少包含根的近似值、原始与尺度化函数残差、区间宽度或最后步长、函数评价次数、收敛状态和停止原因。小残差不必意味着小位置误差,小步长可能只是停滞,端点异号也只有在连续性成立时才保证有根。整体缩放方程不应改变算法结论,多根和重根则需要额外的扫描与结构判断。
IRR 案例说明数值算法无法替代经济解释;Gamma 案例说明 score 根只有在进一步验证后才能解释为 MLE;混合损失分位数和分类截距校准说明求根是统计建模与预测工作流中的基础工具。下一章将从一维方程的根进一步转向多维、带约束或带惩罚目标函数的优化。
5.11 思考题
- 方程 \(f(x)=0\) 与 \(10^{-12}f(x)=0\) 有相同的根。为什么只使用固定的 \(|f(x)|<\epsilon\) 作为停止条件会得到不同结论?怎样构造更合理的诊断?
- 为什么 \(f(a)\) 和 \(f(b)\) 异号仍不足以保证 \([a,b]\) 内存在根?连续性成立时能保证存在,为什么仍不能保证根唯一?
- 比较函数残差、相邻步长和括根区间半宽。三者分别提供什么信息?举例说明小步长为什么可能只是停滞,小函数残差为什么可能对应较大的位置误差。
- score 方程 \(\ell'(\theta)=0\) 的根为什么不一定是极大似然估计?还应检查哪些驻点、边界和目标函数信息?
- Newton 法的迭代次数通常少于二分法,为什么其总计算成本不一定更低?公平比较求根算法时应报告哪些指标?
- 网格扫描怎样帮助寻找多个根?为什么它仍可能漏掉偶重根或距离很近的两个根,并可能把不连续点误认为候选根?
- 非常规现金流存在两个 IRR 时,选择哪个根为什么不是求根算法能够回答的问题?
- 对必须为正的参数,直接在原尺度使用 Newton 法与令 \(\theta=\exp(\eta)\) 后在对数尺度求根各有什么优缺点?
- 分位数方程的导数是概率密度。为什么尾部密度较小会使高分位数对 CDF 误差更加敏感?
5.12 上机实验(Lab)
每份实验报告至少应包括问题与定义域、初值或括根区间的来源、可运行代码、根与函数残差、位置诊断、函数评价次数、收敛状态和结果解释。失败也是有效结果,但必须给出可复现的失败原因。
- Lab 1:统一的求根诊断报告。 对 \(\cos(x)-x\)、\(10^{-20}\{\cos(x)-x\}\)、\(1/x\)、\((x-1)^2\) 和 \(x^3-2x+2\),分别选择适当的二分法、Newton 法、割线法或
uniroot()。生成统一表格,报告方法、初值或区间、根、残差、迭代与函数评价次数、收敛状态和停止原因,并解释每个失败案例属于不连续、不变号、尺度、重根还是震荡问题。 - Lab 2:IRR 的括根、多根与经济解释。 对常规现金流 \((-100,30,40,50)\) 和非常规现金流\((-100,230,-132)\),先画 NPV 曲线,再用不同网格寻找全部变号区间,分别用手写二分法和
uniroot()求根。比较网格分辨率、最终残差和函数评价次数,并写一段不超过 200 字的经济解释。 - Lab 3:收敛速度与计算成本。 对 \(x^3-x-1=0\) 和 \(\cos(x)-x=0\),比较二分法、Newton 法、割线法和
uniroot()。统一位置精度,记录函数及导数评价次数,绘制对数误差或可用诊断随迭代变化的图。再对 \((x-1)^2\) 比较普通 Newton 法与已知重数的修正 Newton 法。 - Lab 4:Gamma MLE 的样本与数值敏感性。 分别令样本量为 20、100 和 1000,重复模拟 Gamma数据并估计 \(\alpha\)、\(\beta\)。比较估计误差、score 残差和括根区间;再构造近乎常数的正值样本,说明固定区间为何可能失败,以及为什么该问题在数值和统计上都难以估计。
- Lab 5:混合损失分布的尾部分位数。 计算 90%、95%、99% 和 99.5% VaR,报告 CDF 残差;分别对压力状态权重和均值施加小扰动,比较各分位数的变化,并结合根附近密度解释高分位数的敏感性。
- 拓展 Lab:分类模型截距再校准。 模拟一组 logit 得分,分别把目标发生率设为 5%、15% 和30%,求截距修正并验证平均预测概率。随后考察极端目标率、过窄初始区间和含非有限得分时的行为,说明总体平均校准为什么不能代替分组校准和判别能力评价。