第 7 章 数值积分与 Laplace 法
7.1 学习目标与路线
概率、期望、归一化常数和混合分布都以积分为共同语言。上一章讨论了如何寻找目标函数的最大点;本章进一步研究两个问题:怎样近似曲线下的整体面积,以及怎样利用最大点附近的局部曲率近似这个面积。
例如,若非负随机变量 \(Y\) 表示家庭年收入,\(f(y)\) 是其密度,\(c>0\) 是低收入线,则低收入比例为
\[ P(Y<c)=\int_0^c f(y)\,dy. \]
若 \(s(y)\) 是收入为 \(y\) 时的补贴额,并且 \(\operatorname{E}\{|s(Y)|\}<\infty\),则每户期望补贴为
\[ \operatorname{E}\{s(Y)\}=\int_0^\infty s(y)f(y)\,dy. \]
分布或政策规则稍微复杂以后,这些积分就未必有闭式解。计算统计的任务不只是给出一个近似数值,还要说明近似来自哪里、误差如何检查,以及在哪些情形下结果不可信。
学完本章后,读者应当能够:
- 把概率、期望、归一化常数和边际概率写成积分,并明确积分域、被积函数和目标精度;
- 实现复合中点、梯形和 Simpson 公式,解释它们在光滑条件下的收敛阶,并用网格加密检查误差;
- 使用 R 的
integrate(),读取误差估计与细分次数,处理已知折点、无穷区间和变量变换; - 在对数尺度上稳定地计算很小的正积分,区分求积误差、Laplace 截断误差和统计抽样误差;
- 从局部二次展开推导一维和多维 Laplace 近似,并由最大点和曲率构造局部正态近似;
- 识别边界峰、多峰、强偏斜、厚尾和病态 Hessian 等失败情形,并用解析结果或自适应积分校准近似。
本章需要一元 Taylor 展开、概率密度与期望、基本 R 函数,以及第 3 章的绝对误差和相对误差。Laplace 近似还会使用第 6 章的最大化与 Hessian 矩阵。本章以复合求积、integrate() 的诊断、Laplace 推导、Beta 型积分校准例和 Poisson–lognormal 混合案例为主;Gaussian 求积、多峰修正和多维实现可作为选读内容。
7.2 统计积分的基本问题
设目标为
\[ I=\int_D q(x)\,dx, \]
其中 \(D\) 是积分域,\(q(x)\) 是被积函数。统计学中的常见例子包括:
- 分布函数 \(F(c)=P(X\leq c)=\int_{-\infty}^c f(x)\,dx\);
- 期望 \(\operatorname{E}\{r(X)\}=\int r(x)f(x)\,dx\);
- 正函数的归一化常数 \(Z=\int_D g(x)\,dx\);
- 混合分布 \(p(y)=\int p(y\mid z)f(z)\,dz\)。
其中有些积分可以解析求解,例如 Beta 函数积分和 Gaussian 积分;多数实际模型则需要数值求积、确定性近似或随机模拟。本章讨论前两类方法,第 10 章再介绍 Monte Carlo 积分。
开始数值积分之前,需要明确以下问题:
- 目标和积分域是什么? 写清常数是否属于被积函数、端点是否包含奇点、积分域是否有限,以及最终需要积分本身还是对数积分。计算完整的归一化常数或混合概率时,不能遗漏被积函数中的常数因子。
- 被积函数有什么结构? 检查平滑性、已知折点、窄峰、长尾、正负抵消和多个峰。先画图或粗略扫描通常比盲目收紧容差更有用。
- 采用哪种方法? 一维光滑有限区间可用复合或 Gaussian 求积;一般的一维问题优先尝试成熟的自适应算法;有明显集中峰且维数较高时可考虑 Laplace;更高维或复杂形状常需 Monte Carlo。
- 误差依据是什么? 固定网格要做加密比较,自适应算法要读取状态和误差估计,Laplace 要检查峰值、边界、曲率与形状;有解析答案或独立算法时应进行核对。
- 结论对设置是否稳定? 改变网格、容差、积分区间、参数化和优化区间,确认报告的小数位不会随合理设置明显变化。
数值程序返回“成功”只表示其内部停止准则被触发,并不自动证明积分目标写对了、所有峰都被找到,或近似误差已经小于统计抽样误差。
本章只讨论正函数的积分、归一化和局部近似。后续章节还会在不同模型中使用网格、Laplace 和随机积分方法。
7.3 有限区间上的复合求积
7.3.1 中点、梯形与 Simpson 公式
先考虑有限区间上的一维积分
\[ I=\int_a^b q(x)\,dx. \]
把 \([a,b]\) 等分成 \(m\) 个小区间,步长为 \(\Delta=(b-a)/m\),网格点为\(x_j=a+j\Delta\)。复合中点公式在每段中点计算函数值:
\[ M_m = \Delta\sum_{j=1}^m q\left\{a+\left(j-\frac12\right)\Delta\right\}. \]
复合梯形公式用直线连接每段的两个端点:
\[ T_m = \Delta\left\{ \frac{q(x_0)}2+\sum_{j=1}^{m-1}q(x_j)+\frac{q(x_m)}2 \right\}. \]
当 \(m\) 为偶数时,复合 Simpson 公式在相邻两段上拟合二次曲线:
\[ S_m =\frac{\Delta}{3} \left\{ q(x_0)+q(x_m) +4\sum_{\substack{j=1\\j\text{ 为奇数}}}^{m-1}q(x_j) +2\sum_{\substack{j=2\\j\text{ 为偶数}}}^{m-2}q(x_j) \right\}. \]
下面用一个函数实现三种复合公式。代码显式检查定义域、网格数、向量化输出和非有限函数值,使错误尽量在产生误导结果以前暴露出来。
composite_quadrature <- function(f, a, b, m = 100L,
                                 rule = c("midpoint", "trapezoid", "simpson")) {
  rule <- match.arg(rule)
  if (length(a) != 1L || length(b) != 1L ||
      !is.finite(a) || !is.finite(b) || a >= b) {
    stop("a 和 b 必须是有限数,并满足 a < b。")
  }
  if (length(m) != 1L || !is.finite(m) || m < 1 || m != floor(m)) {
    stop("m 必须是正整数。")
  }
  m <- as.integer(m)
  if (rule == "simpson" && m %% 2L != 0L) {
    stop("Simpson 公式要求 m 为偶数。")
  }

  evaluate <- function(x) {
    y <- f(x)
    if (!is.numeric(y) || length(y) != length(x) || any(!is.finite(y))) {
      stop("f 必须返回与输入等长的有限数值向量。")
    }
    y
  }

  delta <- (b - a) / m
  if (rule == "midpoint") {
    x_mid <- a + (seq_len(m) - 0.5) * delta
    return(delta * sum(evaluate(x_mid)))
  }

  x <- seq(a, b, length.out = m + 1L)
  y <- evaluate(x)
  if (rule == "trapezoid") {
    return(delta * (sum(y) - 0.5 * y[1L] - 0.5 * y[m + 1L]))
  }

  odd <- seq.int(2L, m, by = 2L)
  even <- if (m >= 4L) seq.int(3L, m - 1L, by = 2L) else integer(0)
  delta / 3 * (y[1L] + y[m + 1L] +
                 4 * sum(y[odd]) + 2 * sum(y[even]))
}
对足够光滑的函数,在固定区间上令 \(m\) 增大时,中点和梯形公式的误差通常为 \(O(m^{-2})\),Simpson公式的误差通常为 \(O(m^{-4})\)。更具体地,若 \(q''\) 在 \([a,b]\) 上连续,则梯形误差满足
\[ |I-T_m| \leq \frac{(b-a)^3}{12m^2} \max_{a\leq x\leq b}|q''(x)|. \]
若 \(q^{(4)}\) 连续,则 Simpson 公式有相应的四阶误差界。这些结论依赖光滑性;尖点、不连续和端点奇异都可能使理论收敛阶下降。
7.3.2 网格加密与经验收敛阶
考虑
\[ I=\int_0^2 \exp(-x^2/2)\,dx =\sqrt{2\pi}\{\Phi(2)-\Phi(0)\}. \]
它有解析答案,适合检查实现。若误差近似为 \(e_m=Cm^{-p}\),把网格数加倍以后应有\(e_m/e_{2m}\approx2^p\),因此可以用
\[ \hat p=\log_2(e_m/e_{2m}) \]
估计收敛阶。
下面用五档网格计算并作图;为使纸面表格紧凑,只展示 \(m=4,16,64\) 三档。表中的经验阶仍由相邻倍增网格计算。
quad_demo <- function(x) exp(-x^2 / 2)
quad_exact <- sqrt(2 * pi) * (pnorm(2) - pnorm(0))
quad_m <- c(4L, 8L, 16L, 32L, 64L)
quad_rules <- c("midpoint", "trapezoid", "simpson")

quad_convergence <- expand.grid(
  rule = quad_rules,
  m = quad_m,
  stringsAsFactors = FALSE
)
quad_convergence$estimate <- mapply(
  function(rule, m) composite_quadrature(quad_demo, 0, 2, m, rule),
  quad_convergence$rule, quad_convergence$m
)
quad_convergence$absolute_error <-
  abs(quad_convergence$estimate - quad_exact)
quad_convergence$observed_order <- NA_real_

for (rule_now in quad_rules) {
  idx <- which(quad_convergence$rule == rule_now)
  err <- quad_convergence$absolute_error[idx]
  quad_convergence$observed_order[idx[-1L]] <-
    log(err[-length(err)] / err[-1L]) / log(2)
}

quad_show <- quad_convergence
quad_show$rule <- c(midpoint = "中点", trapezoid = "梯形",
                    simpson = "Simpson")[quad_show$rule]
quad_table_display <- subset(quad_show, m %in% c(4L, 16L, 64L))
quad_table_display$estimate <- formatC(
  quad_table_display$estimate, format = "f", digits = 10
)
quad_table_display$absolute_error <- formatC(
  quad_table_display$absolute_error, format = "e", digits = 2
)
quad_table_display$observed_order <- ifelse(
  is.na(quad_table_display$observed_order),
  "--",
  formatC(quad_table_display$observed_order, format = "f", digits = 2)
)
knitr::kable(
  quad_table_display,
  position = if (knitr::is_latex_output()) "H" else "",
  caption = "三种复合求积公式的网格加密结果",
  row.names = FALSE
)| rule | m | estimate | absolute_error | observed_order |
|---|---|---|---|---|
| 中点 | 4 | 1.1990856825 | 2.80e-03 | – |
| 梯形 | 4 | 1.1906738356 | 5.61e-03 | – |
| Simpson | 4 | 1.1961656804 | 1.22e-04 | – |
| 中点 | 16 | 1.1964641505 | 1.76e-04 | 2.00 |
| 梯形 | 16 | 1.1959356698 | 3.52e-04 | 2.00 |
| Simpson | 16 | 1.1962876400 | 3.73e-07 | 4.07 |
| 中点 | 64 | 1.1962990266 | 1.10e-05 | 2.00 |
| 梯形 | 64 | 1.1962659865 | 2.20e-05 | 2.00 |
| Simpson | 64 | 1.1962880119 | 1.44e-09 | 4.00 |
stopifnot(
  tail(quad_convergence$observed_order[quad_convergence$rule == "midpoint"], 1) > 1.9,
  tail(quad_convergence$observed_order[quad_convergence$rule == "trapezoid"], 1) > 1.9,
  tail(quad_convergence$observed_order[quad_convergence$rule == "simpson"], 1) > 3.8
)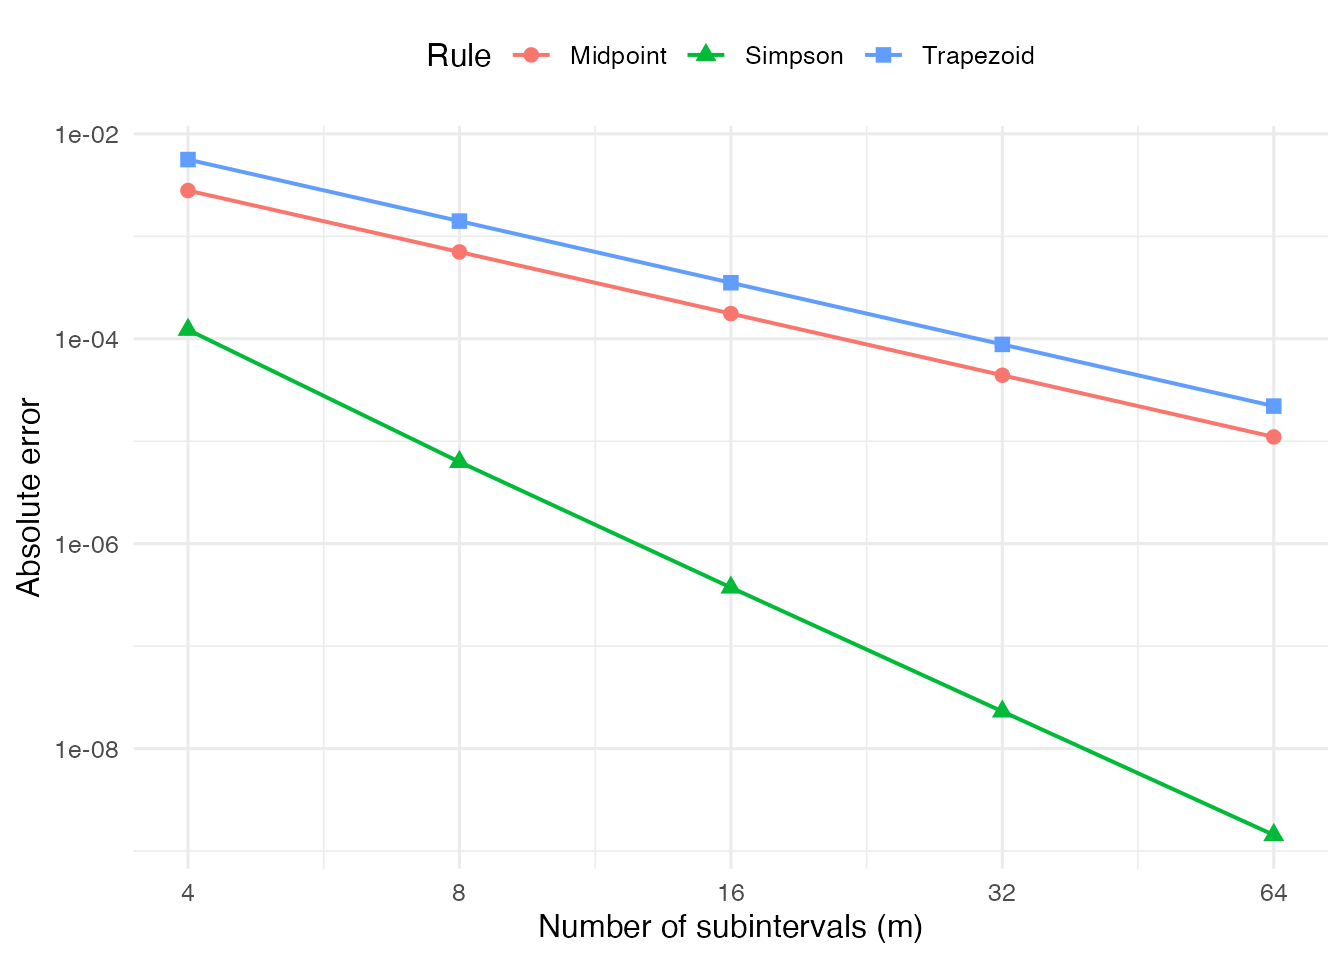
图7.1: 光滑被积函数上三种复合公式的绝对误差;斜率越陡,误差随网格加密下降越快。
表和图中的经验阶逐渐接近 2、2 和 4,既验证了理论,也检查了代码。继续增大 \(m\) 并不保证误差永远按同一速度下降:截断误差足够小时,浮点舍入、函数计算误差和相邻大数抵消会开始占主导。
真实问题通常没有 quad_exact。如果已知方法阶数为 \(p\),可以用连续两次近似之差构造误差量级:
\[ |I-Q_{2m}| \approx \frac{|Q_{2m}-Q_m|}{2^p-1}. \]
这是基于渐近误差模型的估计,不是无条件保证。实践中至少应继续加密一次,确认差值比例与假定的收敛阶相符。
7.3.3 Gaussian 求积(选读)
复合公式固定使用等距节点。Gaussian 求积则同时选择节点和权重,使有限个函数值对多项式尽可能精确。\(r\) 点 Gauss–Legendre 公式在 \([-1,1]\) 上写成
\[ \int_{-1}^1 q(x)\,dx \approx \sum_{j=1}^r w_jq(z_j), \]
并能精确积分次数不超过 \(2r-1\) 的多项式。通过线性变换即可用于任意有限区间。下面的教学实现使用对称三对角 Jacobi 矩阵的特征值和特征向量生成节点与权重,这也连接了第 4 章的对称特征分解。
gauss_legendre_rule <- function(r) {
  if (length(r) != 1L || !is.finite(r) || r < 1 || r != floor(r)) {
    stop("r 必须是正整数。")
  }
  r <- as.integer(r)
  J <- matrix(0, nrow = r, ncol = r)
  if (r > 1L) {
    k <- seq_len(r - 1L)
    off_diag <- k / sqrt(4 * k^2 - 1)
    J[cbind(k, k + 1L)] <- off_diag
    J[cbind(k + 1L, k)] <- off_diag
  }
  eig <- eigen(J, symmetric = TRUE)
  ord <- order(eig$values)
  data.frame(
    node = eig$values[ord],
    weight = 2 * eig$vectors[1L, ord]^2
  )
}

gauss_legendre <- function(f, a, b, r = 8L) {
  rule <- gauss_legendre_rule(r)
  x <- (a + b) / 2 + (b - a) / 2 * rule$node
  y <- f(x)
  if (!is.numeric(y) || length(y) != length(x) || any(!is.finite(y))) {
    stop("f 必须返回与输入等长的有限数值向量。")
  }
  (b - a) / 2 * sum(rule$weight * y)
}

gauss_comparison <- data.frame(r = c(2L, 4L, 8L, 16L))
gauss_comparison$estimate <- vapply(
  gauss_comparison$r,
  function(r) gauss_legendre(quad_demo, 0, 2, r),
  numeric(1)
)
gauss_comparison$absolute_error <-
  abs(gauss_comparison$estimate - quad_exact)

gauss_table_display <- transform(
  gauss_comparison,
  estimate = formatC(estimate, format = "f", digits = 12),
  absolute_error = formatC(absolute_error, format = "e", digits = 2)
)
knitr::kable(
  gauss_table_display,
  position = if (knitr::is_latex_output()) "H" else "",
  caption = "Gauss--Legendre 求积的节点数与误差",
  row.names = FALSE
)| r | estimate | absolute_error |
|---|---|---|
| 2 | 1.202780276224 | 6.49e-03 |
| 4 | 1.196306384267 | 1.84e-05 |
| 8 | 1.196288013324 | 1.84e-12 |
| 16 | 1.196288013323 | 2.22e-16 |
Gaussian 求积对光滑函数非常高效,但节点数增加仍不能修复错误积分域、遗漏的窄峰或未处理的奇点。正式项目通常调用经过测试的实现,而不是复制这段教学代码。
7.4 自适应积分、容差与变量变换
7.4.1 integrate() 返回的不只是积分值
R 的 integrate() 使用自适应求积:它估计不同子区间的误差,把更多函数评价放到较困难的区域。调用结果中的 value 是积分近似,abs.error 是绝对误差估计,subdivisions 是使用的子区间数,message 则说明算法是否正常结束。误差估计是算法诊断,不是严格证明;函数形状没有被采样到时,误差估计本身也可能过于乐观。
假设家庭年收入 \(Y\) 的单位为万元。令 \(\mu=\log 8\)、\(\sigma=0.6\),并采用假设的对数正态模型
\[ \log Y\sim N(\mu,\sigma^2). \]
下面计算收入低于 4 万元的比例,并用解析分布函数核对自适应、梯形和 Simpson 结果。
income_mu <- log(8)
income_sigma <- 0.6
poverty_line <- 4
income_density <- function(y) {
  dlnorm(y, meanlog = income_mu, sdlog = income_sigma)
}

poverty_exact <- plnorm(
  poverty_line,
  meanlog = income_mu,
  sdlog = income_sigma
)
poverty_adaptive <- integrate(
  income_density,
  lower = 0,
  upper = poverty_line,
  rel.tol = 1e-10,
  abs.tol = 0
)

poverty_comparison <- data.frame(
  method = c("解析分布函数", "integrate()", "复合梯形", "复合 Simpson"),
  estimate = c(
    poverty_exact,
    poverty_adaptive$value,
    composite_quadrature(income_density, 0, poverty_line, 200L, "trapezoid"),
    composite_quadrature(income_density, 0, poverty_line, 200L, "simpson")
  )
)
poverty_comparison$absolute_error <-
  abs(poverty_comparison$estimate - poverty_exact)
poverty_comparison$relative_error <-
  poverty_comparison$absolute_error / poverty_exact

poverty_table_display <- transform(
  poverty_comparison,
  estimate = formatC(estimate, format = "f", digits = 10),
  absolute_error = formatC(absolute_error, format = "e", digits = 2),
  relative_error = formatC(relative_error, format = "e", digits = 2)
)
knitr::kable(
  poverty_table_display,
  position = if (knitr::is_latex_output()) "H" else "",
  caption = "低收入比例的四种计算结果",
  row.names = FALSE
)| method | estimate | absolute_error | relative_error |
|---|---|---|---|
| 解析分布函数 | 0.1239949943 | 0.00e+00 | 0.00e+00 |
| integrate() | 0.1239949943 | 1.39e-17 | 1.12e-16 |
| 复合梯形 | 0.1239956520 | 6.58e-07 | 5.30e-06 |
| 复合 Simpson | 0.1239949943 | 8.25e-13 | 6.65e-12 |
data.frame(
  estimated_abs_error = poverty_adaptive$abs.error,
  subdivisions = poverty_adaptive$subdivisions,
  message = poverty_adaptive$message
)
#>   estimated_abs_error subdivisions message
#> 1           3.387e-14            3      OK

stopifnot(
  poverty_adaptive$message == "OK",
  abs(poverty_adaptive$value - poverty_exact) < 1e-10
)
参数 rel.tol 和 abs.tol 分别控制相对与绝对目标。粗略地说,算法试图把误差控制在与\(\max\{\texttt{abs.tol},\texttt{rel.tol}|I|\}\) 相当的尺度。当积分非常接近 0 时,仅给相对容差没有意义;当积分极小但非零时,过大的默认绝对容差又可能使结果只有很差的相对精度。后面的混合概率案例会展示如何处理这种情形。
使用 integrate() 时,被积函数必须接受数值向量并返回等长向量。如果原函数只接受标量,可以显式使用 vapply() 或 Vectorize() 包装,但应意识到这样做不一定高效。
7.4.2 已知折点与分段积分
固定网格会把函数评价平均分配到整个区间,自适应算法也只能根据已经观察到的函数值判断哪里困难。若已知被积函数在某些位置不光滑,直接按这些位置分段通常更可靠。
假设收入低于 4 万元的家庭获得分段线性补贴
\[ s(y)= \begin{cases} 2(1-y/4), & 0<y<4,\\ 0, & y\geq4, \end{cases} \]
其中补贴单位同样为万元。\(y=4\) 是导数发生变化的已知位置;由于其右侧被积函数恒为 0,只需计算\([0,4]\) 上的积分。
subsidy_rule <- function(y) {
  ifelse(0 < y & y < poverty_line, 2 * (1 - y / poverty_line), 0)
}
subsidy_y_scale <- integrate(
  function(y) subsidy_rule(y) * income_density(y),
  lower = 0,
  upper = poverty_line,
  rel.tol = 1e-10,
  abs.tol = 0
)

c(expected_subsidy = subsidy_y_scale$value,
  estimated_abs_error = subsidy_y_scale$abs.error)
#>    expected_subsidy estimated_abs_error
#>           5.831e-02           7.592e-14
如果一个税收规则在多个阈值处跳跃或改变斜率,应分别积分各段再相加。这样既把已知结构告诉了算法,也便于逐段检查哪一部分贡献最大。
7.4.3 无穷区间、变量变换与 Jacobian
integrate() 可以直接接受 -Inf 和 Inf,内部会对无穷区间作变换。另一种常用策略是根据问题结构自己变换变量。例如令 \(y=\exp(z)\),则 \(dy=\exp(z)dz\),所以
\[ \int_0^\infty q(y)\,dy = \int_{-\infty}^{\infty}q\{\exp(z)\}\exp(z)\,dz. \]
额外的 \(\exp(z)\) 是变量变换的 Jacobian,不能省略。对当前对数正态模型,\(f_Y\{\exp(z)\}\exp(z)\) 恰好是 \(N(\mu,\sigma^2)\) 密度。若用\(\phi(\,\cdot\,;\mu,\sigma^2)\) 表示该正态密度,则补贴积分也可写为
\[ \operatorname{E}\{s(Y)\} = \int_{-\infty}^{\log 4} s\{\exp(z)\}\phi(z;\mu,\sigma^2)\,dz. \]
subsidy_log_scale <- integrate(
  function(z) {
    subsidy_rule(exp(z)) * dnorm(z, mean = income_mu, sd = income_sigma)
  },
  lower = -Inf,
  upper = log(poverty_line),
  rel.tol = 1e-10,
  abs.tol = 0
)

subsidy_transform_check <- data.frame(
  parameterization = c("收入 y 尺度", "对数收入 z 尺度"),
  estimate = c(subsidy_y_scale$value, subsidy_log_scale$value),
  estimated_abs_error = c(
    subsidy_y_scale$abs.error,
    subsidy_log_scale$abs.error
  )
)
subsidy_transform_display <- transform(
  subsidy_transform_check,
  estimate = formatC(estimate, format = "f", digits = 10),
  estimated_abs_error = formatC(
    estimated_abs_error, format = "e", digits = 2
  )
)
knitr::kable(
  subsidy_transform_display,
  position = if (knitr::is_latex_output()) "H" else "",
  caption = "两种参数化下的期望补贴",
  row.names = FALSE
)| parameterization | estimate | estimated_abs_error |
|---|---|---|
| 收入 y 尺度 | 0.0583091950 | 7.59e-14 |
| 对数收入 z 尺度 | 0.0583091950 | 1.01e-12 |
精确积分在正确加入 Jacobian 后不依赖参数化,但不同参数化的数值难度可能明显不同。变量变换可把正值或概率参数映射到整条实线,也可能减轻端点奇异;反过来,遗漏 Jacobian 会直接改变目标积分。
这个期望是在给定收入模型和政策规则下的理论量。第 10 章将用随机模拟近似同一个积分;第11 章的 Bootstrap 主要评估有限数据引起的抽样不确定性。求积误差、模拟误差和抽样误差来源不同,不应混为一谈。
7.5 Laplace 近似
7.5.1 从局部二次形状到 Gaussian 面积
考虑正的可积函数 \(g(x)\),定义对数被积函数
\[ \ell(x)=\log g(x). \]
假设 \(\ell(x)\) 在积分域内部的 \(x_0\) 处有一个占主导的最大值,且 \(\ell''(x_0)<0\)。由于\(\ell'(x_0)=0\),在 \(x_0\) 附近作二阶 Taylor 展开得到
\[ \ell(x) \approx \ell(x_0)+\frac12\ell''(x_0)(x-x_0)^2. \]
指数化后,\(g(x)\) 在峰值附近近似为一个未归一化 Gaussian 核:
\[ g(x) \approx \exp\{\ell(x_0)\} \exp\left\{-\frac{(x-x_0)^2}{2w_0^2}\right\}, \qquad w_0^2=-\frac{1}{\ell''(x_0)}. \]
把这个局部二次形状延伸到整条实线并积分,就得到常用的一维公式
\[ \int g(x)\,dx \approx \exp\{\ell(x_0)\} \sqrt{\frac{2\pi}{-\ell''(x_0)}}. \]
这里 \(x_0\) 决定位置,\(-\ell''(x_0)\) 是负曲率,\(w_0\) 则是峰的局部宽度。对\(g(x)=\exp(-x^2/2)\),有 \(x_0=0\)、\(\ell''(0)=-1\),公式精确给出 \(\sqrt{2\pi}\)。对一般固定函数,这个公式只是局部 Gaussian 启发式:一个局部最大点和负二阶导数本身并不能保证尾部或其他峰可忽略。
Laplace 方法的严格含义更清楚地体现在含集中参数的积分中:
\[ I_n=\int_D a(x)\exp\{nh(x)\}\,dx. \]
若 \(h\) 足够光滑,在 \(D\) 内有唯一的占主导全局最大点 \(x_0\),\(h''(x_0)<0\),\(a\) 在 \(x_0\) 附近连续且 \(a(x_0)\ne0\),并且远离 \(x_0\) 的贡献可以忽略,则当 \(n\to\infty\) 时
\[ I_n \sim a(x_0)\exp\{nh(x_0)\} \sqrt{\frac{2\pi}{n[-h''(x_0)]}}. \]
在更强的正则条件下,首项近似的相对误差通常为 \(O(n^{-1})\)。集中参数 \(n\) 增大时,\(\exp\{nh(x)\}\) 越来越集中在最大点附近,这才是 Laplace 近似往往随集中程度提高而改善的原因;统计应用中的 \(n\) 常由样本量驱动,但这里首先把它看作一般的集中参数。
一维 Laplace 近似的计算步骤
- 写清积分域和完整的对数被积函数 \(\ell(x)=\log g(x)\);若变换参数,加入 Jacobian。
- 作图或粗略扫描 \(\ell(x)\),检查主要质量、边界和可能的多个峰。
- 在覆盖主要质量的区间内最大化 \(\ell(x)\),得到候选最大点 \(x_0\);改变区间或初值核对结果。
- 计算负曲率 \(h_0=-\ell''(x_0)\),确认其为有限正数;解析导数可用时优先使用,并核对数值差分。
- 在对数尺度计算\(\log I_{\mathrm L}=\ell(x_0)+\tfrac12\log(2\pi)-\tfrac12\log h_0\)。
- 检查峰到边界的距离、局部宽度 \(h_0^{-1/2}\) 和实际形状;可能时与解析积分或稳定的自适应积分比较。
7.5.2 对数尺度上的稳定实现
正的因子乘积可能远小于机器能可靠表示的尺度。若 \(c\) 接近 \(\ell(x)\) 的最大值,则
\[ \log\int \exp\{\ell(x)\}\,dx = c+ \log\int \exp\{\ell(x)-c\}\,dx. \]
平移常数不改变积分的相对形状,却把缩放后的被积函数峰值移到 1 附近。下面分别实现平移后的自适应积分和一维 Laplace 近似。Laplace 函数允许传入解析二阶导数;若未提供,则用与参数尺度及边界距离相关的中心差分步长。
integrate_log_shifted <- function(log_g, lower, upper, log_shift,
                                  rel.tol = 1e-10, abs.tol = 0,
                                  subdivisions = 1000L) {
  if (length(lower) != 1L || length(upper) != 1L ||
      is.na(lower) || is.na(upper) || lower >= upper) {
    stop("积分端点必须是非缺失标量,并满足 lower < upper。")
  }
  if (length(log_shift) != 1L || !is.finite(log_shift)) {
    stop("log_shift 必须是接近对数被积函数最大值的有限标量。")
  }
  scaled_integrand <- function(x) {
    log_value <- vapply(x, log_g, numeric(1))
    value <- exp(log_value - log_shift)
    if (any(!is.finite(value))) {
      stop("平移后的被积函数出现非有限值。")
    }
    value
  }
  ans <- integrate(
    scaled_integrand,
    lower = lower,
    upper = upper,
    rel.tol = rel.tol,
    abs.tol = abs.tol,
    subdivisions = subdivisions
  )
  if (!is.finite(ans$value) || ans$value <= 0) {
    stop("缩放后的积分必须是有限正数。")
  }
  list(
    log_integral = log_shift + log(ans$value),
    scaled_integral = ans$value,
    estimated_relative_error = ans$abs.error / ans$value,
    subdivisions = ans$subdivisions,
    message = ans$message
  )
}

laplace_1d <- function(log_g, lower, upper, second_derivative = NULL,
                       optimize_tol = sqrt(.Machine$double.eps),
                       minimum_boundary_sd = 3) {
  if (!is.finite(lower) || !is.finite(upper) || lower >= upper) {
    stop("Laplace 搜索区间必须有有限端点并满足 lower < upper。")
  }
  if (length(optimize_tol) != 1L || !is.finite(optimize_tol) ||
      optimize_tol <= 0 || optimize_tol >= (upper - lower) / 10) {
    stop("optimize_tol 必须为正,且小于搜索区间长度的十分之一。")
  }
  if (length(minimum_boundary_sd) != 1L ||
      !is.finite(minimum_boundary_sd) || minimum_boundary_sd < 0) {
    stop("minimum_boundary_sd 必须是有限非负数。")
  }
  opt <- optimize(
    log_g,
    interval = c(lower, upper),
    maximum = TRUE,
    tol = optimize_tol
  )
  mode <- opt$maximum
  log_height <- opt$objective
  if (!is.finite(log_height)) {
    stop("候选最大点处的对数被积函数不是有限数。")
  }

  distance_to_boundary <- min(mode - lower, upper - mode)
  numerical_step <- NA_real_
  if (is.null(second_derivative)) {
    natural_step <- .Machine$double.eps^0.25 * (1 + abs(mode))
    numerical_step <- min(natural_step, distance_to_boundary / 4)
    if (!is.finite(numerical_step) || numerical_step <= 0) {
      stop("候选最大点过于接近搜索边界,无法计算中心差分。")
    }
    log_left <- log_g(mode - numerical_step)
    log_right <- log_g(mode + numerical_step)
    second <- (log_left - 2 * log_height + log_right) / numerical_step^2
  } else {
    second <- second_derivative(mode)
  }

  if (length(second) != 1L || !is.finite(second) || second >= 0) {
    stop("候选最大点处的二阶导数必须是有限负数。")
  }
  local_sd <- sqrt(-1 / second)
  boundary_distance_in_sd <- distance_to_boundary / local_sd
  if (boundary_distance_in_sd < minimum_boundary_sd) {
    stop(
      "候选最大点过于接近搜索边界;请扩大搜索区间,或使用边界方法。"
    )
  }

  list(
    mode = mode,
    log_height = log_height,
    second_derivative = second,
    local_sd = local_sd,
    log_integral = log_height + 0.5 * log(2 * pi) - 0.5 * log(-second),
    boundary_distance_in_sd = boundary_distance_in_sd,
    finite_difference_step = numerical_step,
    optimization = opt
  )
}
optimize() 在给定区间上最适合有效单峰的目标,不是全局多峰搜索器。辅助函数还保守地要求候选最大点距离搜索边界至少三个局部宽度;这里检查的是数值搜索区间,积分变量本身的支持边界仍要另外核对。数值二阶差分会同时受到截断误差和舍入误差影响;对数函数包含很大的加法常数时,相减还可能丢失有效数字。因此,解析 Hessian、自动微分或经过核对的导数通常优于一次固定步长差分。
7.6 例:Beta 型积分的解析校准
7.6.1 用解析积分校准 Laplace 误差
固定峰位置参数 \(0<c<1\) 和集中控制量 \(t>0\),考虑 \((0,1)\) 上的正函数
\[ g_t(\theta) =\theta^{tc}(1-\theta)^{t(1-c)}, \qquad 0<\theta<1. \]
记 \(\alpha_t=tc+1\)、\(\beta_t=t(1-c)+1\)。它的积分有解析答案
\[ Z_t =\int_0^1g_t(\theta)\,d\theta =B(\alpha_t,\beta_t). \]
归一化后的 \(f_t(\theta)=g_t(\theta)/Z_t\) 是 Beta 密度。这里使用 Beta 函数只是因为它同时提供有界积分域、可调峰形和解析基准,不需要引入额外的统计推断概念。当 \(t\) 增大时,归一化密度\(f_t\) 越来越集中在内部最大点
\[ \theta_0 =\frac{\alpha_t-1}{\alpha_t+\beta_t-2} =c. \]
对数被积函数及其二阶导数分别为
\[ \ell_t(\theta) =(\alpha_t-1)\log\theta+(\beta_t-1)\log(1-\theta), \]
\[ \ell_t''(\theta) =-\frac{\alpha_t-1}{\theta^2} -\frac{\beta_t-1}{(1-\theta)^2}. \]
下面取 \(c=0.315,t=400\),同时计算 Laplace 近似和解析结果,并把对数误差转换为相对积分误差\(\exp\{\log Z_{t,\mathrm L}-\log Z_t\}-1\)。
beta_target_mode <- 0.315
beta_strength <- 400
beta_shape1 <- 1 + beta_strength * beta_target_mode
beta_shape2 <- 1 + beta_strength * (1 - beta_target_mode)

log_beta_kernel <- function(theta) {
  if (length(theta) != 1L || theta <= 0 || theta >= 1) return(-Inf)
  (beta_shape1 - 1) * log(theta) +
    (beta_shape2 - 1) * log1p(-theta)
}
log_beta_second <- function(theta) {
  -(beta_shape1 - 1) / theta^2 -
    (beta_shape2 - 1) / (1 - theta)^2
}

beta_laplace <- laplace_1d(
  log_beta_kernel,
  lower = 0,
  upper = 1,
  second_derivative = log_beta_second
)
beta_mode_closed <- (beta_shape1 - 1) /
  (beta_shape1 + beta_shape2 - 2)
beta_log_exact <- lbeta(beta_shape1, beta_shape2)
beta_relative_error <- expm1(beta_laplace$log_integral - beta_log_exact)

beta_integral_comparison <- data.frame(
  quantity = c(
    "优化得到的最大点", "解析最大点", "Laplace log(Z)",
    "解析 log(Z)", "Laplace 有符号相对误差"
  ),
  value = c(
    beta_laplace$mode,
    beta_mode_closed,
    beta_laplace$log_integral,
    beta_log_exact,
    beta_relative_error
  )
)
knitr::kable(
  beta_integral_comparison,
  position = if (knitr::is_latex_output()) "H" else "",
  digits = 8,
  caption = "Beta 型积分的 Laplace 解析校准",
  row.names = FALSE
)| quantity | value |
|---|---|
| 优化得到的最大点 | 3.150e-01 |
| 解析最大点 | 3.150e-01 |
| Laplace log(Z) | -2.521e+02 |
| 解析 log(Z) | -2.521e+02 |
| Laplace 有符号相对误差 | 1.741e-03 |
相对误差的符号表示高估或低估,绝对值才表示误差大小。这里 \(t\) 较大、峰值远离边界,Laplace近似已经相当准确。更重要的是,结论来自与解析答案的定量比较,而不是来自“两个数看起来很接近”。
为了检查渐近直觉,下面保持峰位置 \(c=0.315\) 不变,把集中控制量 \(t\) 从 40 增加到 4000。这样最大点始终相同,而归一化密度的相对形状随 \(t\) 增大而逐渐变窄。
beta_laplace_error <- function(strength, target_mode = 0.315) {
  if (length(strength) != 1L || !is.finite(strength) ||
      strength <= 0 || length(target_mode) != 1L ||
      !is.finite(target_mode) || target_mode <= 0 || target_mode >= 1) {
    stop("strength 必须为正数,target_mode 必须位于 (0, 1)。")
  }
  shape1 <- 1 + strength * target_mode
  shape2 <- 1 + strength * (1 - target_mode)
  mode <- (shape1 - 1) / (shape1 + shape2 - 2)
  log_kernel <- (shape1 - 1) * log(mode) +
    (shape2 - 1) * log1p(-mode)
  second <- -(shape1 - 1) / mode^2 -
    (shape2 - 1) / (1 - mode)^2
  log_laplace <- log_kernel + 0.5 * log(2 * pi) - 0.5 * log(-second)
  log_exact <- lbeta(shape1, shape2)
  c(
    target_mode = target_mode,
    mode = mode,
    log_error = log_laplace - log_exact,
    relative_error = expm1(log_laplace - log_exact)
  )
}

beta_strength_grid <- c(40, 100, 400, 1000, 4000)
beta_strength_result <- t(vapply(
  beta_strength_grid,
  beta_laplace_error,
  numeric(4)
))
beta_strength_table <- data.frame(
  strength = beta_strength_grid,
  beta_strength_result,
  row.names = NULL
)
knitr::kable(
  beta_strength_table,
  position = if (knitr::is_latex_output()) "H" else "",
  digits = c(0, 4, 4, 6, 6),
  caption = "固定峰位置时 Beta 型积分的 Laplace 误差",
  row.names = FALSE
)| strength | target_mode | mode | log_error | relative_error |
|---|---|---|---|---|
| 40 | 0.315 | 0.315 | 0.017122 | 0.017270 |
| 100 | 0.315 | 0.315 | 0.006922 | 0.006946 |
| 400 | 0.315 | 0.315 | 0.001740 | 0.001741 |
| 1000 | 0.315 | 0.315 | 0.000697 | 0.000697 |
| 4000 | 0.315 | 0.315 | 0.000174 | 0.000174 |
stopifnot(
  abs(tail(beta_strength_table$relative_error, 1)) <
    abs(beta_strength_table$relative_error[1])
)
误差随 \(t\) 增大而下降,与 Laplace 渐近结果相符;单个积分族仍不能证明所有问题都具有相同误差常数。这里固定最大点位置,只系统改变 \(t\),因而更容易观察集中程度与误差的关系。
7.6.2 归一化后的局部形状
归一化积分之外,同一个二次展开还给出 \(f_t(\theta)=g_t(\theta)/Z_t\) 的局部正态近似
\[ f_t(\theta) \approx \phi\left(\theta;\theta_0,-\frac{1}{\ell_t''(\theta_0)}\right). \]
下面把精确的归一化 Beta 型函数与局部正态密度叠加。正态曲线在 \([0,1]\) 外仍有质量,因此不可能对有界支持的密度处处精确。
beta_theta_grid <- seq(0.22, 0.42, length.out = 401L)
beta_density_plot <- rbind(
  data.frame(
    theta = beta_theta_grid,
    density = dbeta(beta_theta_grid, beta_shape1, beta_shape2),
    method = "Exact Beta density"
  ),
  data.frame(
    theta = beta_theta_grid,
    density = dnorm(
      beta_theta_grid,
      mean = beta_laplace$mode,
      sd = beta_laplace$local_sd
    ),
    method = "Local Gaussian approximation"
  )
)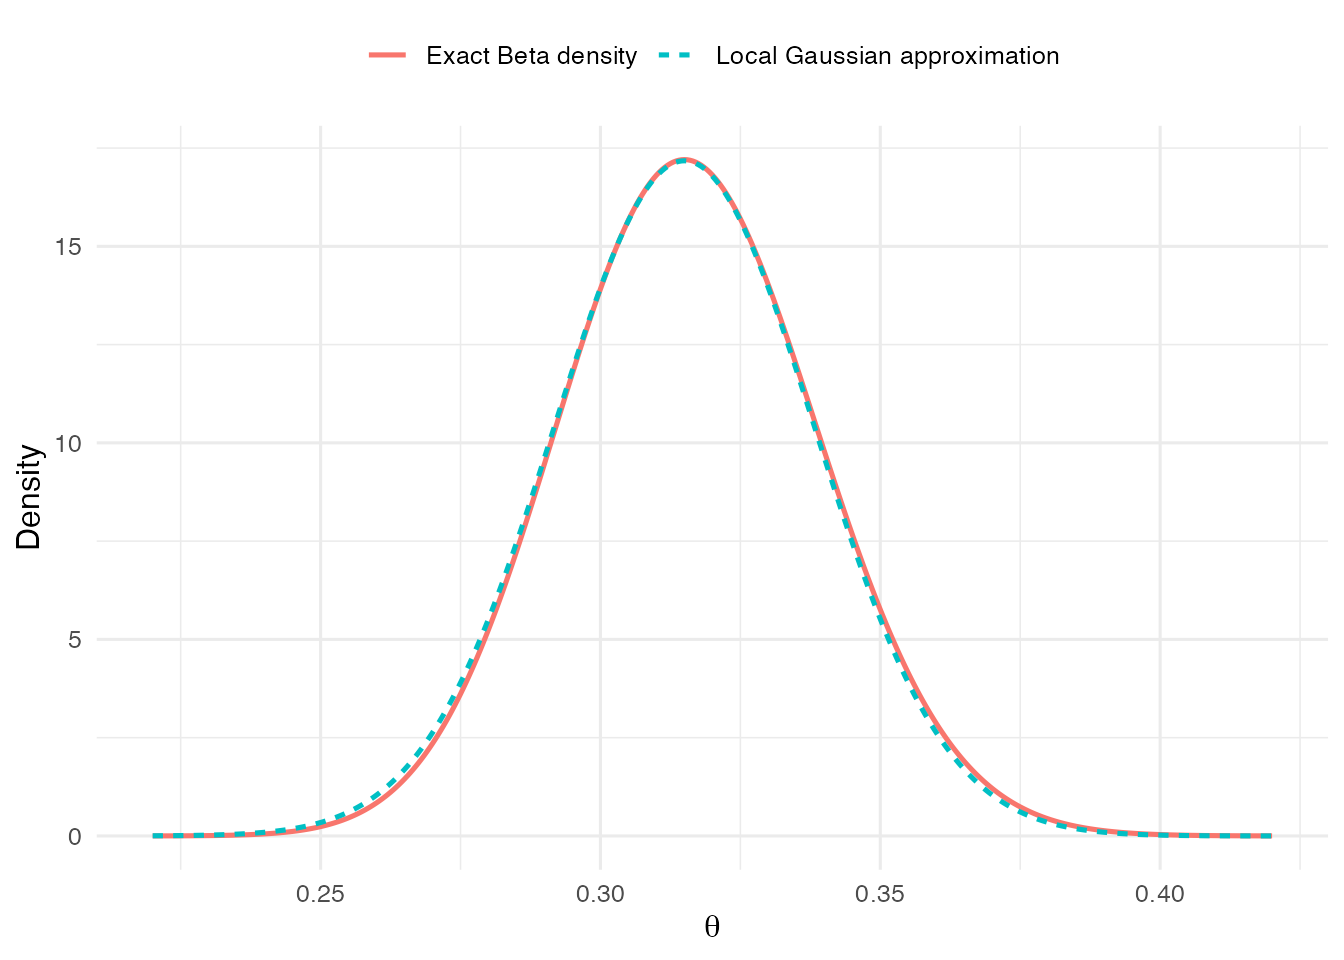
图7.2: 归一化 Beta 型函数与最大点处的局部正态近似。
当前两条曲线很接近,是因为被积函数高度集中且峰值远离 0 和 1。形状偏斜或峰值靠近边界时,正态曲线会把一部分面积放到 \([0,1]\) 之外。此时可考虑变量变换或直接数值求积;变量变换必须带上Jacobian,而且改变坐标并不会自动消除局部二次近似的偏斜误差。例如,logit 变换写成
\[ \eta=\log\frac{\theta}{1-\theta}, \qquad \theta=\operatorname{logit}^{-1}(\eta), \qquad \frac{d\theta}{d\eta}=\theta(1-\theta). \]
它把 \((0,1)\) 映射到整条实线;在新坐标中积分时,最后一项给出的 Jacobian 不能省略。
7.7 Laplace 近似何时会失败
7.7.1 边界、偏斜与尾部
标准公式把最大点附近的二次曲线延伸到 \((-\infty,\infty)\)。若最大点距离边界只有一两个局部宽度,Gaussian 面积的一部分会落到积分域外。若最大值就在边界,驻点条件和标准公式通常都不成立。例如
\[ \int_0^\infty \exp(-nx)\,dx=\frac1n \]
的最大值在 \(x=0\),且对数被积函数没有负二阶曲率;标准 Laplace 公式无法使用。Beta 型被积函数的形状参数不大于 1 时,也可能在 0 或 1 处出现边界峰。参数变换、专门的边界渐近式、数值求积或模拟方法通常比硬套内部峰公式更合适。
强偏斜会使峰两侧衰减速度不同,厚尾会使远离最大点的区域仍贡献显著面积。实际检查可以把横轴标准化为
\[ z=\frac{x-x_0}{w_0}, \qquad w_0=\{-\ell''(x_0)\}^{-1/2}, \]
并比较真实相对对数形状 \(\ell(x)-\ell(x_0)\) 与二次近似 \(-z^2/2\)。只核对最大点和二阶导数,无法发现三阶项造成的偏斜或尾部差异。
7.7.2 多峰:一个局部峰只解释一部分面积
考虑两个分离的正态密度等权混合。其总积分精确等于 1,但每个峰附近只承载大约一半面积。下面分别在左右区间计算局部 Laplace 近似,然后在对数尺度把两个贡献相加。
log_sum_exp <- function(x) {
  x_max <- max(x)
  x_max + log(sum(exp(x - x_max)))
}

log_normal_mixture <- function(x) {
  log_sum_exp(c(
    log(0.5) + dnorm(x, mean = -3, sd = 0.45, log = TRUE),
    log(0.5) + dnorm(x, mean = 3, sd = 0.45, log = TRUE)
  ))
}

mix_left <- laplace_1d(log_normal_mixture, -6, 0)
mix_right <- laplace_1d(log_normal_mixture, 0, 6)
mix_both_log <- log_sum_exp(c(
  mix_left$log_integral,
  mix_right$log_integral
))

mix_comparison <- data.frame(
  approximation = c("精确积分", "只使用左峰", "合并左右峰"),
  log_integral = c(0, mix_left$log_integral, mix_both_log),
  integral = exp(c(0, mix_left$log_integral, mix_both_log))
)
knitr::kable(
  mix_comparison,
  position = if (knitr::is_latex_output()) "H" else "",
  digits = 6,
  caption = "双峰积分中的局部 Laplace 贡献",
  row.names = FALSE
)| approximation | log_integral | integral |
|---|---|---|
| 精确积分 | 0.0000 | 1.0 |
| 只使用左峰 | -0.6931 | 0.5 |
| 合并左右峰 | 0.0000 | 1.0 |
这个刻意简单的例子中,每个局部形状几乎正好是 Gaussian,所以主要问题是遗漏另一个峰。在一般多峰问题中,还要防止不同局部近似覆盖同一片区域而重复计数。可以先把积分域划分为不重叠区域,再近似各区贡献;峰多且形状复杂时,可使用第 10 章和第 17 章介绍的随机积分方法。
7.8 案例:企业订单数的 Poisson–lognormal 混合概率
7.8.1 模型与完整对数被积函数
从某类小微企业中随机抽取一家,观察其连续 \(n\) 个月的线上订单数 \(y_1,\ldots,y_n\)。用潜在变量\(\eta\) 表示企业长期对数活跃度,并假设它在企业群体中服从正态分布。给定 \(\eta\) 后,各月订单数条件独立且具有共同均值:
\[ Y_i\mid\eta\overset{\mathrm{ind}}{\sim} \operatorname{Poisson}\bigl(\exp\eta\bigr), \quad i=1,\ldots,n, \qquad \eta\sim N(m_0,s_0^2). \]
本例把群体参数 \(m_0\) 和 \(s_0\) 视为给定常数。观测订单向量\(\mathbf y=(y_1,\ldots,y_n)^\top\) 的联合边际概率质量为
\[ p(\mathbf y\mid m_0,s_0) = \int_{-\infty}^{\infty} \left[ \prod_{i=1}^n \frac{\exp\{-\exp(\eta)\}\exp(\eta y_i)}{y_i!} \right] \phi(\eta;m_0,s_0^2) \,d\eta. \]
这个积分通常没有简单闭式解。虽然各月在给定 \(\eta\) 后条件独立,共享同一个潜在活跃度会使它们在边际分布下相关。完整的对数被积函数为
\[ \ell(\eta) = \sum_{i=1}^n \left[y_i\eta-\exp(\eta)-\log(y_i!)\right] -\frac{(\eta-m_0)^2}{2s_0^2} -\log(s_0\sqrt{2\pi}), \]
其二阶导数是
\[ \ell''(\eta)=-n\exp(\eta)-\frac{1}{s_0^2}<0. \]
而且当 \(\eta\to\pm\infty\) 时,\(\ell(\eta)\to-\infty\)。因此对数被积函数严格凹,并且恰有一个内部峰。注意,\(\log(y_i!)\) 和正态密度的归一化常数虽然不影响最大点与曲率,却影响目标积分\(p(\mathbf y\mid m_0,s_0)\);计算完整混合概率时不能把它们丢掉。
下面的数据由固定种子按上述两层模型生成,仅用于教学,不对应真实企业样本。代码先作 Laplace 近似,再把峰值平移到 0 后进行高精度自适应积分。若把原始被积函数向量化后直接交给 integrate(),默认绝对容差可能把约 \(10^{-37}\) 的积分当作已经足够接近 0,从而返回相对误差很大的“OK”结果。
set.seed(4)
order_lograte_mean <- log(3)
order_lograte_sd <- 0.7
order_latent_lograte <- rnorm(
  1,
  mean = order_lograte_mean,
  sd = order_lograte_sd
)
orders <- rpois(40, lambda = exp(order_latent_lograte))

log_order_integrand <- function(eta) {
  if (length(eta) != 1L || !is.finite(eta)) return(-Inf)
  if (eta > log(.Machine$double.xmax)) return(-Inf)
  sum(dpois(orders, lambda = exp(eta), log = TRUE)) +
    dnorm(
      eta,
      mean = order_lograte_mean,
      sd = order_lograte_sd,
      log = TRUE
    )
}
log_order_second <- function(eta) {
  -length(orders) * exp(eta) - 1 / order_lograte_sd^2
}

order_laplace <- laplace_1d(
  log_order_integrand,
  lower = -1,
  upper = 3,
  second_derivative = log_order_second
)
order_quadrature <- integrate_log_shifted(
  log_order_integrand,
  lower = -Inf,
  upper = Inf,
  log_shift = order_laplace$log_height,
  rel.tol = 1e-11,
  abs.tol = 0
)

order_log_error <- order_laplace$log_integral -
  order_quadrature$log_integral
order_relative_error <- expm1(order_log_error)

order_result <- data.frame(
  quantity = c(
    "被积函数最大点 eta0", "最大点对应的 exp(eta0)",
    "eta 尺度局部宽度", "Laplace log p(y | m0, s0)",
    "数值积分 log p(y | m0, s0)",
    "Laplace 相对误差", "求积估计相对误差"
  ),
  value = c(
    order_laplace$mode,
    exp(order_laplace$mode),
    order_laplace$local_sd,
    order_laplace$log_integral,
    order_quadrature$log_integral,
    order_relative_error,
    order_quadrature$estimated_relative_error
  )
)
order_result_display <- order_result
order_result_display$value <- formatC(
  order_result_display$value, format = "g", digits = 9
)
knitr::kable(
  order_result_display,
  position = if (knitr::is_latex_output()) "H" else "",
  caption = "Poisson--lognormal 联合边际概率质量的计算结果",
  row.names = FALSE
)| quantity | value |
|---|---|
| 被积函数最大点 eta0 | 1.38266465 |
| 最大点对应的 exp(eta0) | 3.98550746 |
| eta 尺度局部宽度 | 0.0786984225 |
| Laplace log p(y | m0, s0) | -85.8333559 |
| 数值积分 log p(y | m0, s0) | -85.8328625 |
| Laplace 相对误差 | -0.000493304531 |
| 求积估计相对误差 | 6.39092531e-13 |
stopifnot(
  order_quadrature$message == "OK",
  order_quadrature$estimated_relative_error < 1e-9,
  abs(order_relative_error) < 0.01
)
求积算法的估计相对误差只评价数值积分本身;Laplace 相对误差则是 Laplace 结果与高精度求积基准之差。两者相差多个数量级时,主要近似误差来自局部二次截断,而不是参考积分不够精确。
7.8.2 形状诊断与容差敏感性
下面在最大点附近四个局部标准差内比较归一化被积函数与 Laplace 正态曲线。前者的归一化常数来自上面的稳定求积,而不是再次对极小原始函数积分。这里归一化只是为了比较形状。
order_eta_grid <- seq(
  order_laplace$mode - 4 * order_laplace$local_sd,
  order_laplace$mode + 4 * order_laplace$local_sd,
  length.out = 401L
)
order_normalized_integrand <- exp(
  vapply(order_eta_grid, log_order_integrand, numeric(1)) -
    order_quadrature$log_integral
)
order_density_plot <- rbind(
  data.frame(
    eta = order_eta_grid,
    density = order_normalized_integrand,
    method = "Numerically normalized integrand"
  ),
  data.frame(
    eta = order_eta_grid,
    density = dnorm(
      order_eta_grid,
      mean = order_laplace$mode,
      sd = order_laplace$local_sd
    ),
    method = "Laplace Gaussian approximation"
  )
)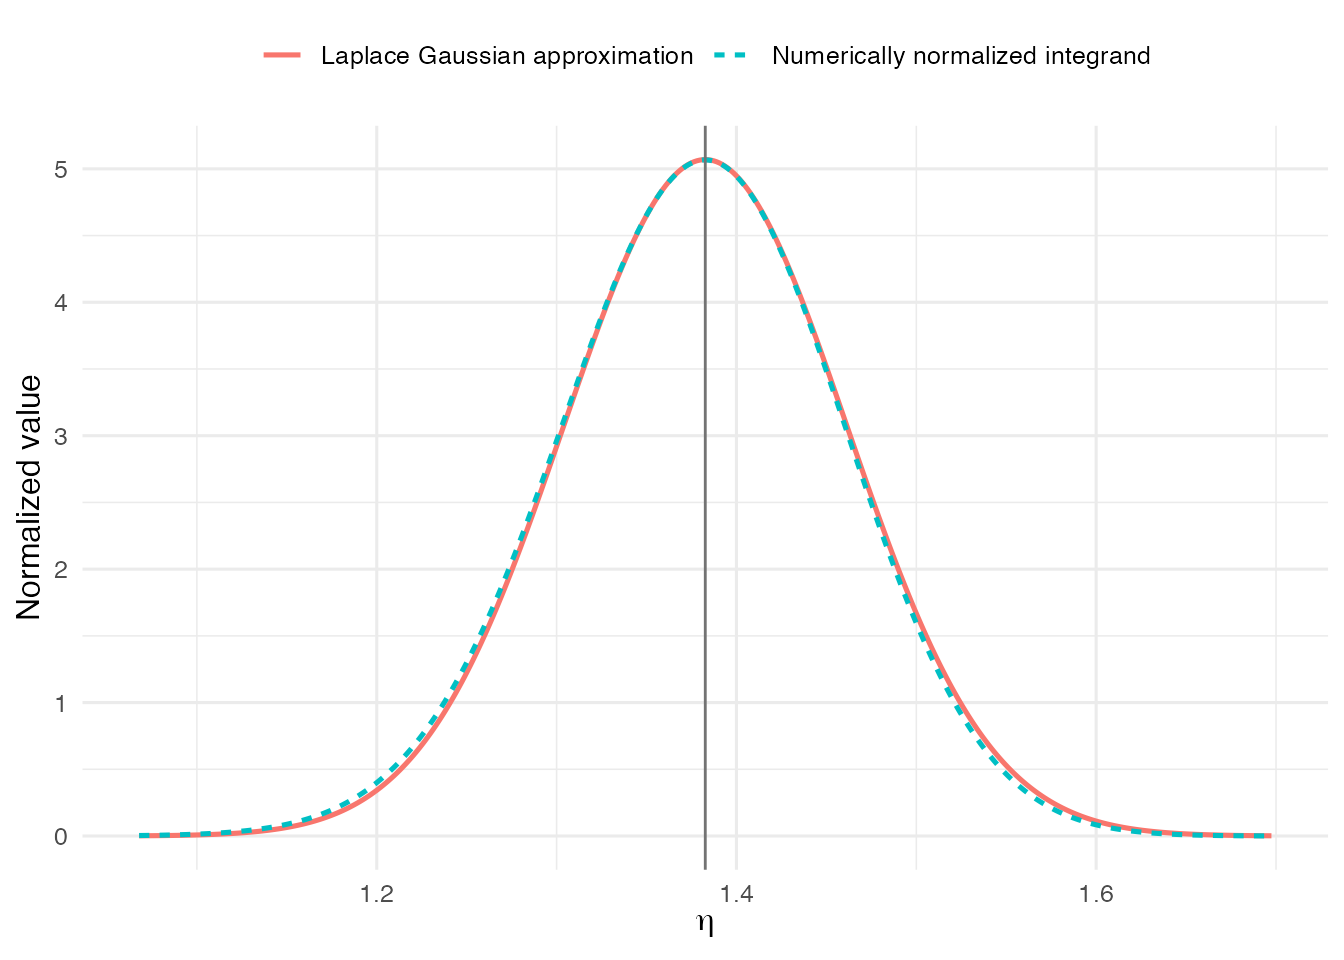
图7.3: 归一化被积函数与 Laplace 正态曲线。
图形能发现偏斜和尾部差异,但不能单独提供积分误差。还应改变数值设置。下面保持数据不变,只改变参考求积的相对容差;结果的小数位和 Laplace 误差应保持稳定。
order_tolerances <- c(1e-6, 1e-9, 1e-12)
order_tolerance_runs <- lapply(order_tolerances, function(tol) {
  integrate_log_shifted(
    log_order_integrand,
    lower = -Inf,
    upper = Inf,
    log_shift = order_laplace$log_height,
    rel.tol = tol,
    abs.tol = 0
  )
})
order_tolerance_table <- data.frame(
  requested_rel_tol = order_tolerances,
  log_integral = vapply(
    order_tolerance_runs,
    function(ans) ans$log_integral,
    numeric(1)
  ),
  estimated_rel_error = vapply(
    order_tolerance_runs,
    function(ans) ans$estimated_relative_error,
    numeric(1)
  ),
  subdivisions = vapply(
    order_tolerance_runs,
    function(ans) ans$subdivisions,
    integer(1)
  )
)
order_tolerance_display <- transform(
  order_tolerance_table,
  requested_rel_tol = formatC(requested_rel_tol, format = "e", digits = 0),
  log_integral = formatC(log_integral, format = "f", digits = 10),
  estimated_rel_error = formatC(
    estimated_rel_error, format = "e", digits = 2
  )
)
knitr::kable(
  order_tolerance_display,
  position = if (knitr::is_latex_output()) "H" else "",
  caption = "Poisson--lognormal 混合概率积分的容差敏感性",
  row.names = FALSE
)| requested_rel_tol | log_integral | estimated_rel_error | subdivisions |
|---|---|---|---|
| 1e-06 | -85.8328624935 | 8.78e-07 | 10 |
| 1e-09 | -85.8328624935 | 6.54e-10 | 12 |
| 1e-12 | -85.8328624935 | 6.39e-13 | 16 |
这个案例把第 6 章和本章连接起来:第一步通过优化定位峰值,第二步用 Hessian 描述局部曲率,第三步才把局部 Gaussian 面积作为整个积分的近似。优化收敛只验证了第一步;后两步仍需独立诊断。
7.9 多维 Laplace 近似与维数困难
若积分变量是 \(d\) 维向量 \(\boldsymbol\theta\),\(\ell(\boldsymbol\theta)\) 在内部点\(\widehat{\boldsymbol\theta}\) 处达到占主导最大值,定义负 Hessian
\[ \mathbf{H} = -\left. \frac{\partial^2\ell(\boldsymbol\theta)} {\partial\boldsymbol\theta\partial\boldsymbol\theta^\top} \right|_{\boldsymbol\theta=\widehat{\boldsymbol\theta}}. \]
若 \(\mathbf{H}\) 对称正定,则多维 Laplace 公式为
\[ \int \exp\{\ell(\boldsymbol\theta)\}\,d\boldsymbol\theta \approx \exp\{\ell(\widehat{\boldsymbol\theta})\} (2\pi)^{d/2}\det(\mathbf{H})^{-1/2}, \]
等价的稳定对数形式为
\[ \log I_{\mathrm L} = \ell(\widehat{\boldsymbol\theta}) +\frac d2\log(2\pi) -\frac12\log\det(\mathbf{H}). \]
将 \(\exp\{\ell(\boldsymbol\theta)\}\) 归一化后,局部正态近似的协方差矩阵是 \(\mathbf{H}^{-1}\)。沿Hessian 特征向量观察最清楚:大特征值表示该方向曲率大、局部宽度小;接近 0 的特征值表示平坦方向,也会使行列式、协方差和数值结果敏感。
不要直接计算 det(H) 后再取对数,因为行列式可能上溢或下溢。正定矩阵的 Cholesky 分解\(\mathbf{H}=\mathbf{R}^\top\mathbf{R}\) 给出
\[ \log\det(\mathbf{H})=2\sum_{j=1}^d\log R_{jj}. \]
laplace_log_integral_nd <- function(log_height, negative_hessian) {
  H <- as.matrix(negative_hessian)
  if (length(log_height) != 1L || !is.finite(log_height)) {
    stop("log_height 必须是有限标量。")
  }
  if (nrow(H) < 1L || nrow(H) != ncol(H) || any(!is.finite(H))) {
    stop("negative_hessian 必须是有限方阵。")
  }
  if (!isTRUE(all.equal(H, t(H), tolerance = 1e-10))) {
    stop("negative_hessian 必须对称。")
  }
  R <- chol(H)
  log_det <- 2 * sum(log(diag(R)))
  d <- nrow(H)
  c(
    log_integral = log_height + d / 2 * log(2 * pi) - 0.5 * log_det,
    log_determinant = log_det,
    min_eigenvalue = min(eigen(H, symmetric = TRUE, only.values = TRUE)$values)
  )
}

# 对二元 Gaussian 核,Laplace 公式应当精确。
gaussian_precision <- matrix(c(4, 1.2, 1.2, 2), nrow = 2)
nd_check <- laplace_log_integral_nd(
  log_height = 0,
  negative_hessian = gaussian_precision
)
nd_exact <- log(2 * pi) - 0.5 * as.numeric(determinant(
  gaussian_precision,
  logarithm = TRUE
)$modulus)

c(laplace = nd_check["log_integral"], exact = nd_exact)
#> laplace.log_integral                exact
#>               0.8974               0.8974
stopifnot(abs(nd_check["log_integral"] - nd_exact) < 1e-12)
若 chol() 失败,说明负 Hessian 不是数值正定矩阵:候选点可能不是局部最大点,也可能存在不可识别、尺度悬殊或接近奇异的方向。简单地给对角线加小常数会改变近似目标,不能代替模型和优化诊断。
多维求积还有更直接的维数困难。若每维取 \(m\) 个网格点,\(d\) 维笛卡尔网格需要 \(m^d\) 个点;\(m=100,d=5\) 时已有 \(10^{10}\) 个函数值。Laplace 只使用峰值和 Hessian,成本增长慢得多,却用局部形状换取了速度。高维被积函数若明显偏斜、多峰、强相关或不同方向的尺度悬殊,后续章节介绍的随机模拟方法通常更可靠。
7.10 方法比较与误差来源
不同方法回答的问题和诊断依据不同:
| 问题结构 | 可优先考虑的方法 | 至少检查什么 |
|---|---|---|
| 一维、有限区间、光滑 | 复合 Simpson 或 Gaussian 求积 | 网格加密、经验收敛阶、独立基准 |
| 一维、折点或无穷区间 | 分段与自适应 integrate() |
折点、尾部、误差估计、容差敏感性 |
| 正积分的数值量级极小或极大 | 对数尺度与峰值平移 | 缩放后积分、相对而非只看绝对误差 |
| 单个占主导内部峰 | Laplace 近似 | 全局峰、边界距离、曲率、偏斜和尾部 |
| 多个分离峰 | 分区后合并局部贡献或模拟 | 是否漏峰、是否重复计数、各峰贡献 |
| 中高维复杂积分 | 后续章节的随机模拟方法 | 模拟误差与相应收敛诊断 |
需要特别区分四种误差:
- 模型与统计误差来自数据有限、抽样设计和模型设定;增加求积节点不能修复模型偏差。
- 求积误差来自有限节点、区间截断和自适应停止准则;可用加密、误差估计和独立方法检查。
- Laplace 截断误差来自用二次函数替代真实对数形状;收紧
integrate()容差不会改善它。 - 浮点误差来自上溢、下溢和抵消;对数尺度、平移和稳定线性代数可以缓解。
报告结果时,保留的有效数字应由这些误差中最大的相关误差决定。一个打印十位小数的结果,不会因为显示得更长而变得更准确。
7.11 进一步阅读
Gentle (2009) 和 Monahan (2011) 从计算统计角度讨论数值积分、误差与近似;Robert and Casella (2004) 将确定性积分与 Monte Carlo 方法放在统计计算框架中比较。阅读软件文档或算法论文时,应区分严格误差界、算法内部误差估计和经验基准误差。
7.12 本章小结
数值积分首先要求写清积分域、被积函数和精度尺度。复合中点与梯形公式在光滑条件下具有二阶误差,Simpson 公式通常具有四阶误差;Gaussian 求积通过选择节点和权重提高光滑函数上的效率。实际一维问题应优先使用成熟的自适应实现,同时读取误差估计、状态和细分次数,并通过网格、容差、分段与变量变换进行核对。极小正积分应在对数尺度平移后计算,不能只依赖默认绝对容差。
Laplace 近似用占主导内部最大点附近的二次对数形状替代整个被积函数。最大点给出位置,负 Hessian给出局部宽度;将被积函数归一化后,它们对应局部 Gaussian 近似的位置与协方差。该方法对集中、单峰且近似对称的形状最可靠,边界峰、多峰、强偏斜、厚尾和近奇异 Hessian 都需要特别处理。固定最大点位置的 Beta 型积分族用解析答案校准了渐近误差,Poisson–lognormal 混合概率案例则展示了优化、曲率、峰值平移、自适应积分和形状诊断在实际计算中的配合方式。
7.13 思考题
- 为什么
integrate()返回message = "OK"仍不能证明目标积分正确或误差估计可靠?请分别给出一个“积分写错”和一个“函数形状未被发现”的可能原因。 - 对光滑函数,梯形公式把网格数加倍后误差大约缩小到四分之一。若实际误差只缩小一半,可能说明哪些光滑性、舍入或实现问题?
- 计算完整的混合概率 \(p(\mathbf y\mid m_0,s_0)\) 时,为什么不能删除 \(\ell(\eta)\) 中与 \(\eta\)无关的加法常数,而只寻找被积函数最大点与计算曲率时可以删除?
- 对 \(\int_0^\infty e^{-nx}\,dx\),标准内部峰 Laplace 公式的哪几个条件失败?仅把区间扩展到整条实线为什么不能解决问题?
- 精确积分在包含 Jacobian 的变量变换下保持不变,为什么有限 \(t\) 下的 Laplace 近似会依赖参数化?用本章给出的 logit 变换把 \((0,1)\) 上的积分变量映射到实线后,还可能留下哪些近似误差?
- 双峰积分中,在一个峰处准确估计 Hessian 为什么仍可能漏掉一半面积?把两个局部 Laplace 数值直接相加又可能在哪些情况下重复计算面积?
- 若多维负 Hessian 的最小特征值接近 0,这对局部协方差、对数行列式、参数可识别性和 Laplace结果的敏感性分别意味着什么?
- 区分求积误差、Laplace 截断误差、Monte Carlo 误差和原始数据抽样误差。增加网格数、样本量或模拟次数分别会影响哪些误差?
7.14 上机实验(Lab)
每份实验报告至少应写出积分目标与积分域、算法和关键设置、可复现代码、误差或诊断依据以及结果解释。若有解析答案,应报告绝对和相对误差;若以高精度数值积分为基准,应先证明基准对容差与区间设置稳定。下列实验是题库,可优先选择 Lab 1、Lab 3 和综合 Lab 5。
- Lab 1:复合求积的收敛比较。 分别对一个光滑函数、一个含尖点的函数和一个端点附近变化很快的函数,实现中点、梯形与 Simpson 公式。令 \(m\) 连续加倍,报告函数评价次数、绝对误差和经验收敛阶;解释哪些函数不符合名义二阶或四阶速度。再与
integrate()的结果和误差估计比较。 - Lab 2:分段、变换与容差。 修改本章补贴规则,使其在两个收入阈值处改变斜率。比较一次性积分、按阈值分段、收入尺度和对数收入尺度四种实现;检查 Jacobian,并在三组容差下报告结果、
abs.error和subdivisions。 - Lab 3:强度参数与 Laplace 误差。 对\(g_t(\theta)=\theta^{tc}(1-\theta)^{t(1-c)}\),固定 \(c=0.315\),令\(t\in\{40,100,400,1000,4000\}\)。对每个 \(t\) 计算解析 \(\log Z_t\)、Laplace \(\log Z_{t,\mathrm L}\)、对数误差和有符号相对积分误差。以 \(t\) 为横轴、\(|\log Z_{t,\mathrm L}-\log Z_t|\) 为纵轴作双对数图,并判断经验速度是否与 \(O(t^{-1})\) 相容。
- Lab 4:边界与多峰失败。 第一部分取\(g_{\alpha,\beta}(\theta)=\theta^{\alpha-1}(1-\theta)^{\beta-1}\),其中 \(\alpha,\beta>0\) 且至少一个形状参数位于 \((0,1]\),说明原尺度上的内部峰公式为何不可用;比较解析 Beta 积分、稳定数值积分和包含 Jacobian 的 logit 尺度 Laplace 近似。第二部分对一个双峰对数被积函数找出所有驻点,比较单峰近似、分区后的双峰近似与高精度
integrate();说明误差来自漏峰还是局部二次形状。 - 综合 Lab 5:Poisson–lognormal 混合概率计算。 固定本章订单数据,令企业群体中潜在对数订单率的标准差 \(s_0\in\{0.2,0.7,2\}\)。对每个设定报告被积函数最大点、曲率、以局部宽度为单位的搜索边界距离、稳定求积的相对误差估计、Laplace 相对误差和归一化被积函数形状图。再用
function(eta) exp(vapply(eta, log_order_integrand, numeric(1)))构造未平移的向量化被积函数,并交给默认integrate();解释它为何可能显示OK却给出错误基准。整个比较必须使用同一组订单数据。 - 选做:多维 Gaussian 与病态曲率。 构造一系列具有相同最大点、但精度矩阵条件数逐渐增大的二维 Gaussian 核。用 Cholesky 形式计算 Laplace 对数积分,与解析答案核对;再扰动 Hessian,研究最小特征值、条件数和对数积分误差之间的关系。