第 15 章 贝叶斯思维与贝叶斯推断
前面各章已经讨论了估计、优化、随机模拟和预测评价。贝叶斯方法并不是另起一套互不相干的计算技术,而是用联合概率模型重新组织这些技术:先说明未知量与数据怎样共同产生,再以已经观察到的数据为条件,更新对未知量、未来观测和行动后果的判断。
这种更新方式适合处理许多统计问题:历史调查可以为新一轮调查提供背景信息,不同地区的数据可以通过共同模型交换信息,稀有事件分析可以把基准发生率与新证据结合。先验也可以只承担正则化作用,使有限样本下的估计保持在合理范围。不过,先验并不是任意添加的主观看法;它是模型的一部分,应有清楚的来源、尺度和敏感性分析,并接受先验预测检查。
第 14 章已经提示某些惩罚与先验之间存在联系。正则化通常给出一个点估计,贝叶斯分析则以整个后验分布为中心,并把参数不确定性传播到预测和决策。本章先从事件概率的更新出发,再通过两个共轭模型建立参数推断、预测和决策之间的联系。这里有意使用能够解析计算的模型;第16 章再研究闭式后验消失以后怎样完成同样的推断任务。
15.1 学习目标
完成本章后,读者应当能够:
- 用条件概率、赔率和似然比解释贝叶斯更新;
- 区分先验、似然、后验与边际似然各自承担的作用;
- 说明似然为什么不是参数的概率分布;
- 推导 Beta–Binomial 和 Normal–Normal 共轭后验;
- 用先验均值和先验信息量解释 Beta 先验;
- 区分参数的后验可信区间与未来观测的后验预测区间;
- 使用先验预测分布检查先验与数据模型的共同含义;
- 通过敏感性分析判断结论对先验选择的依赖程度;
- 说明解析计算、直接后验抽样和近似算法之间的边界。
15.2 贝叶斯更新的基本逻辑
15.2.1 事件概率与赔率更新
对事件 \(H\) 和 \(E\),若 \(P(E)>0\),条件概率定义为
\[ P(H\mid E)=\frac{P(H\cap E)}{P(E)}. \]
利用乘法公式 \(P(H\cap E)=P(E\mid H)P(H)\),可得
\[ P(H\mid E) =\frac{P(E\mid H)P(H)} {P(E\mid H)P(H)+P(E\mid H^c)P(H^c)}. \]
\(P(H)\) 是观察证据之前的概率,\(P(E\mid H)\) 描述证据在状态 \(H\) 下出现的可能性,\(P(H\mid E)\) 是观察证据之后的条件概率。Bayes 公式没有创造新信息,而是按照证据在不同状态下的相对相容程度重新分配原有概率。
赔率形式更直接地展示了这种更新。定义 \(H\) 的赔率为
\[ O(H)=\frac{P(H)}{1-P(H)}, \]
证据 \(E\) 的似然比为
\[ \operatorname{LR}(E)=\frac{P(E\mid H)}{P(E\mid H^c)}, \]
则
\[ O(H\mid E)=O(H)\operatorname{LR}(E). \]
即“后验赔率等于先验赔率乘以似然比”。多条条件独立证据会让相应似然比依次相乘。
例 15.1 稀有缺陷筛查。
设某类产品的缺陷率为 0.2%。一项筛查在缺陷产品上给出阳性的概率为 95%,在合格产品上给出阴性的概率为 98%。这些数值只用于教学。随机抽取一件产品并得到阳性结果后,它确有缺陷的概率是多少?
prevalence <- 0.002
sensitivity <- 0.95
specificity <- 0.98
false_positive_rate <- 1 - specificity

positive_probability <-
  sensitivity * prevalence +
  false_positive_rate * (1 - prevalence)
posterior_one_positive <-
  sensitivity * prevalence / positive_probability

prior_odds <- prevalence / (1 - prevalence)
positive_likelihood_ratio <-
  sensitivity / false_positive_rate
posterior_odds <- prior_odds * positive_likelihood_ratio
posterior_from_odds <- posterior_odds / (1 + posterior_odds)

stopifnot(
  abs(posterior_one_positive - posterior_from_odds) < 1e-14
)

screening_summary <- data.frame(
  quantity = c(
    "筛查前缺陷概率",
    "阳性似然比",
    "一次阳性后的缺陷概率"
  ),
  value = c(
    prevalence,
    positive_likelihood_ratio,
    posterior_one_positive
  )
)

knitr::kable(
  screening_summary,
  row.names = FALSE,
  digits = 4,
  col.names = c("计算量", "数值")
)| 计算量 | 数值 |
|---|---|
| 筛查前缺陷概率 | 0.0020 |
| 阳性似然比 | 47.5000 |
| 一次阳性后的缺陷概率 | 0.0869 |
尽管筛查的灵敏度和特异度都较高,一次阳性后的缺陷概率仍不高。用自然频数可以看得更清楚:假想检查100000 件产品,平均约有 200 件缺陷品,其中约 190 件呈阳性;其余 99800 件合格品中,约有 1996 件呈假阳性。因此,阳性产品主要来自数量庞大的合格品。忽略初始缺陷率,只看到 95% 的灵敏度,就会犯基础概率忽视的错误。
若对同一产品再次使用相同筛查,并且两次结果在给定产品状态后条件独立,则第一次的后验可以作为第二次更新的先验,或等价地把阳性似然比再乘一次。
posterior_odds_two <-
  prior_odds * positive_likelihood_ratio^2
posterior_two_positives <-
  posterior_odds_two / (1 + posterior_odds_two)

screening_sequence <- data.frame(
  evidence = c("一次阳性", "两次条件独立阳性"),
  defect_probability = c(
    posterior_one_positive,
    posterior_two_positives
  )
)

knitr::kable(
  screening_sequence,
  row.names = FALSE,
  digits = 4,
  col.names = c("观察到的证据", "缺陷的后验概率")
)| 观察到的证据 | 缺陷的后验概率 |
|---|---|
| 一次阳性 | 0.0869 |
| 两次条件独立阳性 | 0.8189 |
条件独立是假设,不是两次检测的自动属性。同一设备的系统误差、同一批次的污染或重复读取同一样本,都可能使两次结果相关。若仍机械地把似然比平方,后验会显得过度确定。
15.2.2 联合模型、后验与顺序更新
先验、似然、后验与边际似然。
设未知参数为 \(\theta\),观测数据为 \(\mathbf y\)。贝叶斯模型先规定联合分布
\[ p(\mathbf y,\theta) =p(\mathbf y\mid\theta)p(\theta), \]
其中 \(p(\theta)\) 是先验,\(p(\mathbf y\mid\theta)\) 是数据模型。
这个分解也给出模型的生成顺序:先从 \(p(\theta)\) 描述的未知状态出发,再按\(p(\mathbf y\mid\theta)\) 生成可能的数据。它是一种组织不确定性的模型表达,并不要求现实世界真的反复“抽取参数”。它的价值在于迫使分析者同时说明参数允许落在哪里、给定参数后数据怎样波动,以及观测之间的条件依赖结构。
观察到 \(\mathbf y\) 后,把联合分布改写成关于 \(\theta\) 的条件分布:
\[\begin{equation} p(\theta\mid\mathbf y) =\frac{p(\mathbf y\mid\theta)p(\theta)} {p(\mathbf y)}, \tag{15.1} \end{equation}\]
其中
\[ p(\mathbf y)=\int p(\mathbf y\mid\theta)p(\theta)\,d\theta \]
是边际似然或先验预测密度。离散参数时,积分改为求和。这里统一用 \(p\) 表示概率质量函数或密度,具体含义由随机变量类型决定。
式 (15.1) 中各部分承担不同任务:
| 对象 | 作为谁的函数 | 作用 |
|---|---|---|
| 先验 \(p(\theta)\) | \(\theta\) | 描述观察当前数据前的参数不确定性 |
| 似然 \(L(\theta;\mathbf y)=p(\mathbf y\mid\theta)\) | 固定数据后的 \(\theta\) | 衡量不同参数值与已观测数据的相容程度 |
| 后验 \(p(\theta\mid\mathbf y)\) | \(\theta\) | 综合先验和当前数据后的不确定性 |
| 边际似然 \(p(\mathbf y)\) | 数据 \(\mathbf y\) | 归一化后验,并衡量整个模型对数据的预测密度 |
似然不是 \(\theta\) 的概率分布:固定 \(\mathbf y\) 后,\(L(\theta;\mathbf y)\) 对 \(\theta\) 的积分不必等于1。只有乘以先验并除以边际似然后,才得到归一化的后验分布。如果只计算同一模型内部的后验相对密度,可以写成
\[ p(\theta\mid\mathbf y) \propto p(\mathbf y\mid\theta)p(\theta). \]
但边际似然并非永远可以忽略;进行模型比较或计算先验预测概率时,它本身就是研究对象。第19 章会进一步讨论。
后验必须能够归一化。
一个真正的先验分布应当积分或求和为 1。有时为简化分析,会在无界参数空间上使用形如\(p(\theta)\propto1\) 的不当先验,其积分为无穷,因而本身不是概率分布。某些不当先验与似然结合后能产生适定后验,另一些则不能;后验是否适定必须针对具体模型证明,边际似然也不能按普通方式用于模型比较。
本章以适当先验为主,使先验预测、后验概率和模型生成过程都有明确含义。不当先验不是“完全没有先验信息”的自动表示,也不应仅因公式简洁而使用。
分批数据与顺序更新。
把两批数据分别记为 \(\mathcal D_1\) 和 \(\mathcal D_2\)。若它们在给定 \(\theta\) 后条件独立,则
\[ p(\theta\mid\mathcal D_1,\mathcal D_2) \propto p(\mathcal D_2\mid\theta) p(\theta\mid\mathcal D_1). \]
第一批数据的后验可以作为第二批更新的先验,分批更新与合并数据一次更新得到相同结果。若两批数据存在条件依赖,就要在联合似然中表示这种结构;不能只把两个似然机械相乘。
15.2.3 参数推断中的概率陈述
频率学派和贝叶斯学派使用相同的概率公理,但对统计推断的组织方式不同。频率方法通常把参数视为固定的未知量,通过假想重复抽样研究估计量、检验和置信区间的长期性质。贝叶斯方法为未知参数指定先验分布,观察数据后得到后验分布,并在给定模型与数据的条件下对参数作概率陈述。
把二者简单概括为“客观频率”和“主观信念”并不准确。频率分析同样需要模型、损失函数和设计选择;贝叶斯先验也可以来自历史数据、物理限制、群体之间可共享信息的结构或弱信息正则化。真正需要核对的是概率陈述以什么为条件,所用程序在哪一种重复或预测任务下评价,以及结论对模型假设是否敏感。
例如,95% 频率置信区间的覆盖率是构造程序在重复抽样下的性质;得到某个具体区间后,参数仍被视为固定。95% 后验可信区间则满足给定模型、先验和当前数据后参数位于区间内的后验概率为 0.95。两种区间有时数值接近,但解释依据不同。
15.3 第一个共轭模型:Beta–Binomial 更新
假设我们关心大学生中每天睡眠不少于 8 小时的比例。令 \(\theta\) 表示目标总体中的比例,从该总体随机抽取 \(n=30\) 名学生,其中 \(x=12\) 人满足条件。暂时假设学生之间条件独立且抽样机制不会系统性遗漏某类学生,则
\[ X\mid\theta\sim\operatorname{Binomial}(n,\theta), \]
似然为
\[ L(\theta;x) =\binom{n}{x}\theta^x(1-\theta)^{n-x}. \]
样本比例 \(x/n=0.4\) 是数据摘要,尚未包含任何先验信息。
15.3.1 从有限参数空间看归一化
先假设 \(\theta\) 只能取 0.1、0.3、0.5 和 0.7。离散先验给每个候选值分配概率;后验概率等于“先验概率乘以似然”再归一化。
n_sleep <- 30L
x_sleep <- 12L
theta_hypothesis <- c(0.1, 0.3, 0.5, 0.7)
prior_probability <- c(0.15, 0.45, 0.30, 0.10)

likelihood_value <- dbinom(
  x_sleep,
  size = n_sleep,
  prob = theta_hypothesis
)
unnormalized_posterior <-
  prior_probability * likelihood_value
posterior_probability <-
  unnormalized_posterior / sum(unnormalized_posterior)

discrete_update <- data.frame(
  theta = theta_hypothesis,
  prior = prior_probability,
  likelihood = likelihood_value,
  prior_times_likelihood = unnormalized_posterior,
  posterior = posterior_probability
)

stopifnot(abs(sum(posterior_probability) - 1) < 1e-14)

knitr::kable(
  discrete_update,
  row.names = FALSE,
  digits = 5,
  col.names = c(
    "$\\theta$", "先验概率", "似然", "未归一化后验", "后验概率"
  ),
  escape = FALSE
)| \(\theta\) | 先验概率 | 似然 | 未归一化后验 | 后验概率 |
|---|---|---|---|---|
| 0.1 | 0.15 | 0.00001 | 0.00000 | 0.00003 |
| 0.3 | 0.45 | 0.07485 | 0.03368 | 0.58177 |
| 0.5 | 0.30 | 0.08055 | 0.02417 | 0.41739 |
| 0.7 | 0.10 | 0.00046 | 0.00005 | 0.00080 |
似然一列不需要对 \(\theta\) 求和为 1,后验一列则必须求和为 1。这个表也揭示了离散先验的一个重要性质:如果某个候选值的先验概率恰好为 0,只要数据在该值下的似然有限,后验概率仍然为 0。数据会重新分配已有先验支持中的权重,却不能恢复先验明确排除的离散假设。
连续参数中,单个点的概率通常都为 0,因此应讨论先验密度在哪些区间为 0,而不能把“单点概率为 0”误解为排除了该参数值。
15.3.2 连续比例参数的共轭更新
让 \(\theta\) 在 \((0,1)\) 上连续取值,并采用 Beta 先验
\[ \theta\sim\operatorname{Beta}(a,b), \qquad a>0,\ b>0, \]
其密度为
\[ p(\theta) =\frac{1}{B(a,b)} \theta^{a-1}(1-\theta)^{b-1}, \qquad 0<\theta<1. \]
其中 \(B(a,b)\) 是 Beta 函数。
将先验与二项似然相乘,并保留与 \(\theta\) 有关的项:
\[ \begin{aligned} p(\theta\mid x) &\propto \theta^x(1-\theta)^{n-x} \theta^{a-1}(1-\theta)^{b-1}\\ &= \theta^{a+x-1}(1-\theta)^{b+n-x-1}. \end{aligned} \]
因此
\[\begin{equation} \theta\mid x \sim\operatorname{Beta}(a+x,b+n-x). \tag{15.2} \end{equation}\]
后验与先验属于同一分布族,这种关系称为共轭。共轭不是贝叶斯推断的必要条件,它只是让归一化和后验摘要能够解析计算。
Beta 分布可以用先验均值 \(m\) 和先验信息量 \(s\) 重新参数化:
\[ m=\frac{a}{a+b}, \qquad s=a+b, \qquad a=ms,\quad b=(1-m)s. \]
后验均值随之写成
\[\begin{equation} \operatorname{E}(\theta\mid x) =\frac{a+x}{a+b+n} =\frac{s}{s+n}m+ \frac{n}{s+n}\frac{x}{n}. \tag{15.3} \end{equation}\]
它是先验均值和样本比例按信息量加权的平均。\(s\) 越大,先验均值的权重越高。把 \(a\)、\(b\) 称为“先验成功和失败次数”有助于理解更新,但这只是共轭模型中的类比;它们是分布形状参数,不必对应真实观察过的整数样本。
下面取 \(a=3,b=7\),先验均值为 0.3,先验信息量为 10。
a_prior <- 3
b_prior <- 7
a_posterior <- a_prior + x_sleep
b_posterior <- b_prior + n_sleep - x_sleep

beta_summary <- data.frame(
  quantity = c(
    "先验均值",
    "样本比例",
    "后验均值",
    "后验标准差",
    "$P(\\theta>0.5\\mid x)$",
    "95\\%可信区间下限",
    "95\\%可信区间上限"
  ),
  value = c(
    a_prior / (a_prior + b_prior),
    x_sleep / n_sleep,
    a_posterior / (a_posterior + b_posterior),
    sqrt(
      a_posterior * b_posterior /
        ((a_posterior + b_posterior)^2 *
           (a_posterior + b_posterior + 1))
    ),
    pbeta(0.5, a_posterior, b_posterior, lower.tail = FALSE),
    qbeta(0.025, a_posterior, b_posterior),
    qbeta(0.975, a_posterior, b_posterior)
  )
)

knitr::kable(
  beta_summary,
  row.names = FALSE,
  digits = 4,
  col.names = c("后验摘要", "数值"),
  escape = FALSE
)| 后验摘要 | 数值 |
|---|---|
| 先验均值 | 0.3000 |
| 样本比例 | 0.4000 |
| 后验均值 | 0.3750 |
| 后验标准差 | 0.0756 |
| \(P(\theta>0.5\mid x)\) | 0.0541 |
| 95%可信区间下限 | 0.2336 |
| 95%可信区间上限 | 0.5282 |
后验均值位于先验均值 0.3 和样本比例 0.4 之间。后验概率\(P(\theta>0.5\mid x)\) 回答的是给定先验、模型和数据后总体比例超过 0.5 的不确定性,而不是重复抽样中的拒绝概率。
15.3.3 后验区间与分批更新
上表使用等尾可信区间:后验分布在区间两侧各留下 2.5% 概率。也可以选择最高后验密度区间,使区间内任一点的密度不低于区间外任一点;对单峰分布,它通常是给定后验概率下的较短区间。后验偏斜时,两种区间一般不同。
无论采用哪一种,都应报告构造方式。95% 可信区间的概率陈述条件于先验、似然和已经观察到的数据;它不表示模型有 95% 概率正确,也不表示未来 95% 的观测会落在这个参数区间内。
分批更新与一次更新一致。
把 30 名学生分成两批,第一批 10 人中有 3 人满足条件,第二批 20 人中有 9 人满足条件。先更新第一批,再把所得后验作为第二批先验,应与一次使用全部 30 人得到相同的 Beta 后验。
batch_success <- c(3L, 9L)
batch_size <- c(10L, 20L)

a_sequential <- a_prior
b_sequential <- b_prior
for (j in seq_along(batch_size)) {
  a_sequential <- a_sequential + batch_success[j]
  b_sequential <- b_sequential +
    batch_size[j] - batch_success[j]
}

stopifnot(
  a_sequential == a_posterior,
  b_sequential == b_posterior
)

c(
  batch_update_a = a_sequential,
  one_step_a = a_posterior,
  batch_update_b = b_sequential,
  one_step_b = b_posterior
)
#> batch_update_a     one_step_a batch_update_b     one_step_b
#>             15             15             25             25
这种一致性依赖两批观测在给定 \(\theta\) 后服从同一二项模型。若调查方式、目标总体或时间机制已经改变,直接累加成功与失败次数可能不合理。
15.4 从先验预测到稳健决策
15.4.1 用先验预测检查模型设定
单独查看 \(p(\theta)\) 有时很难判断先验是否合理。把参数从联合模型中积分掉,可以得到尚未观察数据时可观测量的分布
\[ p(\mathbf y)=\int p(\mathbf y\mid\theta)p(\theta)\,d\theta. \]
这正是式 (15.1) 的分母,也称先验预测分布。它把抽象的参数尺度转换到可观测数据尺度:在观察当前数据之前,这个模型认为哪些数据常见,哪些数据极端?
在 Beta–Binomial 模型中,\(X\) 的先验预测分布为 Beta–Binomial:
\[ P(X=x) =\binom{n}{x} \frac{B(a+x,b+n-x)}{B(a,b)}, \qquad x=0,1,\ldots,n. \]
下面比较三个先验。它们的均值都为 0.3,但信息量分别为 4、10 和 100。这样可以把“先验位置”和“先验集中程度”的作用分开。
beta_binomial_probability <- function(x, size, a, b) {
  exp(
    lchoose(size, x) +
      lbeta(a + x, b + size - x) -
      lbeta(a, b)
  )
}

prior_specification <- data.frame(
  prior = c("较弱", "中等", "集中"),
  a = c(1.2, 3, 30),
  b = c(2.8, 7, 70)
)

x_grid <- 0:n_sleep
prior_predictive_probability <- sapply(
  seq_len(nrow(prior_specification)),
  function(j) {
    beta_binomial_probability(
      x_grid,
      n_sleep,
      prior_specification$a[j],
      prior_specification$b[j]
    )
  }
)
colnames(prior_predictive_probability) <-
  prior_specification$prior

stopifnot(
  max(abs(colSums(prior_predictive_probability) - 1)) < 1e-12
)

matplot(
  x_grid,
  prior_predictive_probability,
  type = "l",
  lty = 1,
  lwd = 2,
  col = c("grey35", "steelblue", "firebrick"),
  xlab = "30人中睡眠不少于8小时的人数",
  ylab = "先验预测概率"
)
abline(v = x_sleep, lty = 3)
legend(
  "topright",
  legend = prior_specification$prior,
  col = c("grey35", "steelblue", "firebrick"),
  lty = 1,
  lwd = 2,
  bty = "n"
)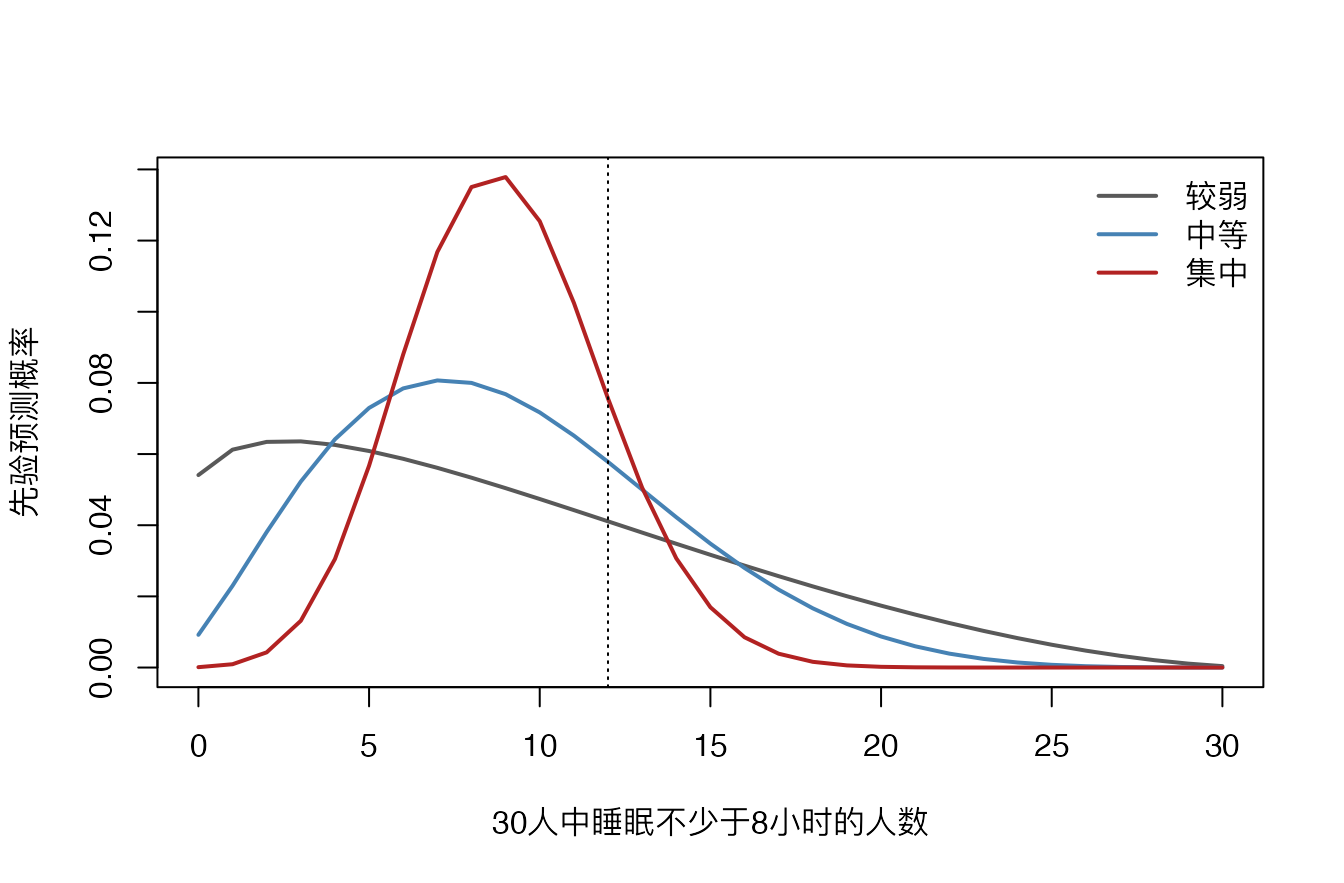
图15.1: 三个Beta先验对应的睡眠人数先验预测分布
均值相同不代表先验含义相同。较弱先验允许 \(\theta\) 在较大范围内变化,因此人数分布更分散;集中先验把 \(\theta\) 限制在 0.3 附近,人数变化主要来自给定 \(\theta\) 后的二项抽样。图中的竖线是实际观察到的\(x=12\)。先验预测检查不是用当前数据反复调到“看起来最合适”,而是帮助发现单位、数量级和支持范围上明显不合理的设定,并促使研究者重新核对先验依据。
15.4.2 用后验预测回答未来问题并支持决策
观察当前数据后,未来数据 \(\widetilde{\mathbf y}\) 的后验预测分布为
\[\begin{equation} p(\widetilde{\mathbf y}\mid\mathbf y) =\int p(\widetilde{\mathbf y}\mid\theta) p(\theta\mid\mathbf y)\,d\theta. \tag{15.4} \end{equation}\]
它同时包含参数不确定性和给定参数后的新观测随机性。在睡眠比例例子中,下一名随机抽取学生满足条件的后验预测概率为
\[ P(\widetilde y=1\mid x) =\operatorname{E}(\theta\mid x) =\frac{a+x}{a+b+n}. \]
若未来再调查 \(n_{\mathrm{new}}\) 人,满足条件的人数 \(\widetilde x\) 服从参数为\((n_{\mathrm{new}},a+x,b+n-x)\) 的 Beta–Binomial 后验预测分布。
future_size <- 20L
future_count <- 0:future_size
posterior_predictive_probability <-
  beta_binomial_probability(
    future_count,
    future_size,
    a_posterior,
    b_posterior
  )
posterior_predictive_cdf <-
  cumsum(posterior_predictive_probability)

predictive_interval_index <- c(
  which(posterior_predictive_cdf >= 0.025)[1],
  which(posterior_predictive_cdf >= 0.975)[1]
)

beta_predictive_summary <- data.frame(
  quantity = c(
    "下一名学生满足条件的概率",
    "未来20人中的预测均值",
    "未来20人预测区间下限",
    "未来20人预测区间上限",
    "未来20人中至少10人满足条件的概率"
  ),
  value = c(
    a_posterior / (a_posterior + b_posterior),
    future_size * a_posterior /
      (a_posterior + b_posterior),
    future_count[predictive_interval_index[1]],
    future_count[predictive_interval_index[2]],
    sum(posterior_predictive_probability[future_count >= 10])
  )
)

knitr::kable(
  beta_predictive_summary,
  row.names = FALSE,
  digits = 4,
  col.names = c("预测摘要", "数值")
)| 预测摘要 | 数值 |
|---|---|
| 下一名学生满足条件的概率 | 0.375 |
| 未来20人中的预测均值 | 7.500 |
| 未来20人预测区间下限 | 3.000 |
| 未来20人预测区间上限 | 13.000 |
| 未来20人中至少10人满足条件的概率 | 0.222 |
表中的预测区间由离散分布的 2.5% 和 97.5% 分位数构造,其实际覆盖概率可能略高于 95%。总体比例\(\theta\) 的可信区间与未来 20 人中人数的预测区间处于不同尺度,也包含不同不确定性。不能把参数可信区间乘以 20 就当作人数预测区间;后者还包含未来二项抽样的波动。
第 19 章会系统讨论后验预测检查和预测模型比较。本章先建立最基本的区分:后验分布回答未知参数的问题,后验预测分布回答尚未观察数据的问题。
预测进入实际分析后,还需要用损失函数把推断连接到行动。后验概率本身不自动给出决定。设可选行动为 \(d\),真实但未知状态为 \(\theta\),采取行动造成的损失为\(L(d,\theta)\)。贝叶斯行动(Bayes action)最小化后验期望损失:
\[ d^\ast(\mathbf y) =\arg\min_d \operatorname{E}\{L(d,\theta)\mid\mathbf y\}. \]
因此,相同后验分布在不同损失函数下可以对应不同决定。平方误差损失下,参数的贝叶斯点估计是后验均值;绝对误差损失下是后验中位数;若行动是是否干预,则阈值由干预成本、漏判成本和可能后果共同决定,不必等于 0.5。
涉及未来结果的决策应使用后验预测分布,而不只是参数后验。例如,安排未来服务容量时,既要考虑平均到达率的不确定性,也要考虑给定到达率后的日常随机波动。报告“采取什么行动”时,应把后验分布与损失或效用假设分别写清楚,便于读者判断结论究竟来自数据、先验还是决策偏好。
15.4.3 用敏感性分析检验结论的稳健性
先验选择应尽量在查看当前结果之前完成,并记录来源和参数化方式。常见依据包括历史数据、专家知识、物理或制度约束,以及用于排除不合理极端值的弱信息设定。历史数据若已经进入当前似然,就不能再不加说明地重复用于构造先验,否则同一信息会被计算两次。
下面比较四个 Beta 先验。前三个具有相同先验均值 0.3、不同信息量;第四个是集中在 0.7 附近、与当前样本明显冲突的先验。
prior_sensitivity <- data.frame(
  prior = c(
    "Beta(1.2, 2.8)",
    "Beta(3, 7)",
    "Beta(30, 70)",
    "Beta(70, 30)"
  ),
  a = c(1.2, 3, 30, 70),
  b = c(2.8, 7, 70, 30)
)

prior_sensitivity$prior_mean <- with(
  prior_sensitivity, a / (a + b)
)
prior_sensitivity$prior_information <- with(
  prior_sensitivity, a + b
)
prior_sensitivity$posterior_mean <- with(
  prior_sensitivity,
  (a + x_sleep) / (a + b + n_sleep)
)
prior_sensitivity$posterior_q025 <- with(
  prior_sensitivity,
  qbeta(0.025, a + x_sleep, b + n_sleep - x_sleep)
)
prior_sensitivity$posterior_q975 <- with(
  prior_sensitivity,
  qbeta(0.975, a + x_sleep, b + n_sleep - x_sleep)
)
prior_sensitivity$probability_gt_half <- with(
  prior_sensitivity,
  pbeta(
    0.5,
    a + x_sleep,
    b + n_sleep - x_sleep,
    lower.tail = FALSE
  )
)

prior_table <- prior_sensitivity[, c(
  "prior", "prior_mean", "prior_information"
)]
posterior_table <- data.frame(
  prior = prior_sensitivity$prior,
  posterior_mean = prior_sensitivity$posterior_mean,
  credible_interval = sprintf(
    "[%.3f, %.3f]",
    prior_sensitivity$posterior_q025,
    prior_sensitivity$posterior_q975
  ),
  probability_gt_half = prior_sensitivity$probability_gt_half
)

knitr::kable(
  prior_table,
  row.names = FALSE,
  digits = 3,
  col.names = c(
    "先验", "先验均值", "先验信息量"
  )
)| 先验 | 先验均值 | 先验信息量 |
|---|---|---|
| Beta(1.2, 2.8) | 0.3 | 4 |
| Beta(3, 7) | 0.3 | 10 |
| Beta(30, 70) | 0.3 | 100 |
| Beta(70, 30) | 0.7 | 100 |
knitr::kable(
  posterior_table,
  row.names = FALSE,
  digits = 3,
  col.names = c(
    "先验", "后验均值", "95\\%可信区间",
    "$P(\\theta>0.5\\mid x)$"
  ),
  escape = FALSE
)| 先验 | 后验均值 | 95%可信区间 | \(P(\theta>0.5\mid x)\) |
|---|---|---|---|
| Beta(1.2, 2.8) | 0.388 | [0.234, 0.555] | 0.093 |
| Beta(3, 7) | 0.375 | [0.234, 0.528] | 0.054 |
| Beta(30, 70) | 0.323 | [0.246, 0.406] | 0.000 |
| Beta(70, 30) | 0.631 | [0.546, 0.711] | 0.999 |
较弱先验下,后验主要跟随样本;信息量为 100 的先验即使与样本冲突,仍会显著影响后验。这并不意味着强先验必然错误,而是说明结论依赖一项强假设。报告时应说明这种假设的实质依据,并展示在其他合理先验下结论是否改变。若不同先验导致实际决策相同,后验数值虽有差异,决策可能仍然稳健。
15.5 第二个共轭模型:Normal–Normal 更新
15.5.1 后验精度与均值收缩
比例模型的更新可以理解为先验信息量与样本量相加。正态均值模型表现出相同结构。设
\[ Y_i\mid\mu\overset{\mathrm{iid}}{\sim}N(\mu,\sigma^2), \qquad i=1,\ldots,n, \]
其中 \(Y_i\) 表示第 \(i\) 个随机响应,其观测值 \(y_i\) 组成\(\mathbf y=(y_1,\ldots,y_n)^\top\);\(\sigma^2\) 暂时视为已知。对均值参数采用先验
\[ \mu\sim N(\mu_0,\tau_0^2). \]
记样本均值为 \(\bar y=n^{-1}\sum_{i=1}^n y_i\)。忽略与 \(\mu\) 无关的项,似然与先验的对数相加得到
\[ \log p(\mu\mid\mathbf y) =-\frac{1}{2} \left\{ \frac{n}{\sigma^2}(\mu-\bar y)^2 +\frac{1}{\tau_0^2}(\mu-\mu_0)^2 \right\}+C. \]
配方后可得共轭后验
\[\begin{equation} \mu\mid\mathbf y\sim N(\mu_n,\tau_n^2), \qquad \tau_n^2=\left( \frac{1}{\tau_0^2}+\frac{n}{\sigma^2} \right)^{-1}, \tag{15.5} \end{equation}\]
\[\begin{equation} \mu_n=\tau_n^2\left( \frac{\mu_0}{\tau_0^2} +\frac{n\bar y}{\sigma^2} \right). \tag{15.6} \end{equation}\]
精度是方差的倒数。后验精度等于先验精度与数据精度之和;后验均值是先验均值与样本均值按精度加权的平均。如果把一条观测的方差 \(\sigma^2\) 作为信息单位,则先验的等效样本量为\(n_0=\sigma^2/\tau_0^2\),于是
\[ \mu_n=\frac{n_0}{n_0+n}\mu_0+ \frac{n}{n_0+n}\bar y. \]
这个等效样本量只在当前正态模型和已知 \(\sigma^2\) 的设定下成立,不是先验的通用属性。
15.5.2 参数区间与观测区间
下面把 \(y_i\) 看作某项业务流程的处理时间。历史资料给出先验均值 300 秒、先验标准差 20 秒;测量与个体波动的标准差 \(\sigma=35\) 秒暂按已知处理。
set.seed(1501)
n_time <- 25L
processing_time <- rnorm(n_time, mean = 315, sd = 35)

mu_0 <- 300
tau_0 <- 20
sigma_known <- 35

tau_n2 <- 1 /
  (1 / tau_0^2 + n_time / sigma_known^2)
mu_n <- tau_n2 * (
  mu_0 / tau_0^2 +
    n_time * mean(processing_time) / sigma_known^2
)

mean_interval <- qnorm(
  c(0.025, 0.975),
  mean = mu_n,
  sd = sqrt(tau_n2)
)
predictive_interval <- qnorm(
  c(0.025, 0.975),
  mean = mu_n,
  sd = sqrt(sigma_known^2 + tau_n2)
)

normal_summary <- data.frame(
  quantity = c(
    "先验均值",
    "样本均值",
    "后验均值",
    "后验标准差",
    "均值95\\%可信区间下限",
    "均值95\\%可信区间上限",
    "新观测95\\%预测区间下限",
    "新观测95\\%预测区间上限",
    "$P(\\mu>310\\mid\\mathbf y)$"
  ),
  value = c(
    mu_0,
    mean(processing_time),
    mu_n,
    sqrt(tau_n2),
    mean_interval,
    predictive_interval,
    pnorm(310, mu_n, sqrt(tau_n2), lower.tail = FALSE)
  )
)

knitr::kable(
  normal_summary,
  row.names = FALSE,
  digits = 3,
  col.names = c("摘要", "秒或概率"),
  escape = FALSE
)| 摘要 | 秒或概率 |
|---|---|
| 先验均值 | 300.000 |
| 样本均值 | 312.851 |
| 后验均值 | 311.448 |
| 后验标准差 | 6.607 |
| 均值95%可信区间下限 | 298.499 |
| 均值95%可信区间上限 | 324.398 |
| 新观测95%预测区间下限 | 241.638 |
| 新观测95%预测区间上限 | 381.259 |
| \(P(\mu>310\mid\mathbf y)\) | 0.587 |
均值的后验可信区间描述未知 \(\mu\),新观测的预测区间则还要加入个体波动 \(\sigma^2\),所以明显更宽:
\[ \widetilde y\mid\mathbf y \sim N(\mu_n,\sigma^2+\tau_n^2). \]
把 \(\sigma\) 当作已知是为了突出共轭更新。实际分析中误差方差通常也未知,需要为它建模并传播其不确定性;第 18 章将在回归模型中处理这一问题。
15.6 从解析后验走向一般分析
15.6.1 解析结果与直接后验模拟
如果后验属于 R 已实现的标准分布,可以用分布函数精确计算均值、分位数和概率,也可以直接生成独立后验样本。直接抽样不是 MCMC:rbeta()、rnorm() 等函数产生的是目标分布的独立伪随机样本,不需要马尔可夫链的收敛诊断。
下面用直接模拟核对 Beta 后验的解析摘要。若用 \(S\) 个独立后验样本估计\(\operatorname{E}\{h(\theta)\mid x\}\),样本平均的 Monte Carlo 标准误(MCSE)可估为
\[ \widehat{\operatorname{MCSE}} =\frac{s_h}{\sqrt S}, \]
其中 \(s_h\) 是 \(h(\theta^{(1)}),\ldots,h(\theta^{(S)})\) 的样本标准差。模拟估计与解析值的差应当与这个标准误处在相称的数量级,而不应被要求在最后几位完全相同。
set.seed(1502)
simulation_size <- 50000L
theta_draw <- rbeta(
  simulation_size,
  shape1 = a_posterior,
  shape2 = b_posterior
)

indicator_gt_half <- theta_draw > 0.5
simulation_check <- data.frame(
  quantity = c(
    "后验均值",
    "$P(\\theta>0.5\\mid x)$"
  ),
  exact = c(
    a_posterior / (a_posterior + b_posterior),
    pbeta(
      0.5,
      a_posterior,
      b_posterior,
      lower.tail = FALSE
    )
  ),
  simulation = c(
    mean(theta_draw),
    mean(indicator_gt_half)
  ),
  MCSE = c(
    sd(theta_draw) / sqrt(simulation_size),
    sqrt(
      mean(indicator_gt_half) *
        (1 - mean(indicator_gt_half)) /
        simulation_size
    )
  )
)

stopifnot(
  all(
    abs(simulation_check$simulation - simulation_check$exact) <
      4 * simulation_check$MCSE
  )
)

knitr::kable(
  simulation_check,
  row.names = FALSE,
  digits = 5,
  col.names = c("后验量", "解析值", "模拟值", "MCSE"),
  escape = FALSE
)| 后验量 | 解析值 | 模拟值 | MCSE |
|---|---|---|---|
| 后验均值 | 0.37500 | 0.37529 | 0.00034 |
| \(P(\theta>0.5\mid x)\) | 0.05406 | 0.05376 | 0.00101 |
有解析结果时,解析计算通常更快且没有模拟误差;直接模拟的优势在于同一组样本可以灵活计算非线性函数、联合概率和决策损失。当后验既不是标准分布,也不能直接抽样时,才需要第16 章和第 17 章的近似算法。
15.6.2 建模、检查、计算与后续章节
一个完整分析不应从“选择哪种抽样算法”开始。算法只负责在已经写定的联合模型下完成计算;在此之前,观测单位、抽样机制和目标量必须先说清楚。联合模型写定以后,先在可观测量尺度上检查先验,再根据后验维数和形状选择计算方法;得到后验以后,还要检查模型能否再现与任务有关的数据特征,并考察结论对合理替代设定是否敏感。程序“成功运行”只说明某个目标分布得到了数值处理,不能证明数据模型合适或先验具有实质依据;反过来,模型设定合理也不保证近似误差已经足够小。
先验设定贯穿前两轮审查。历史研究和专家知识可以提供外部信息,弱信息先验可以排除不合理极端值,层次或收缩先验则表达参数之间的结构;无论来源为何,都要回到参数单位和可观测量尺度解释。“方差很大”不自动意味着先验很弱,非线性变换还可能把看似平坦的参数先验变成极端的预测分布。数据量增加时,似然在正则模型中通常会占据更大权重;然而,当数据不能清楚区分不同参数组合(弱识别)、模型设定有误或先验排除了关键参数区域时,这种直觉可能失效,所以仍需针对实际目标量进行敏感性分析。
这套次序也是本章与后续计算章节的分工基础。本章的 Beta–Binomial 和 Normal–Normal 模型都有闭式后验。它们用于建立更新逻辑,而不是暗示实际贝叶斯分析都能靠识别分布名称完成。复杂模型既要处理后验归一化常数、期望、概率、分位数和预测分布,也要判断确定性近似误差、Monte Carlo 误差与迭代收敛是否已经达到报告要求。
第 16 章从低维网格、MAP、Laplace 近似和重要性抽样开始;第 17 章处理难以直接抽样的后验;第 18 章把这些思想用于回归模型;第19 章进一步讨论预测检查与模型比较。计算方法不同,先验、似然、后验和预测分布之间的逻辑关系保持不变。
15.7 本章小结
Bayes 公式把先验概率和证据的似然比结合起来。稀有缺陷例子说明,阳性证据的含义取决于基础发生率;多次证据的顺序更新则依赖条件独立等模型假设。进入参数推断后,先验与数据模型共同定义联合分布,后验是观察数据后的条件分布,边际似然既负责归一化,也是先验预测密度。似然衡量参数与固定数据的相容程度,本身不是参数的概率分布。
Beta–Binomial 模型展示了共轭更新、先验信息量、顺序更新和比例参数的可信区间。Normal–Normal模型展示了精度相加和均值收缩。参数后验描述未知参数,后验预测还包含未来观测自身的随机性,因此预测区间通常比参数可信区间更宽。
先验是模型的一部分。先验预测把参数设定转换到数据尺度,敏感性分析检查结论对合理替代先验的依赖。有闭式后验时应优先利用解析结果;直接后验模拟会额外产生可量化的 Monte Carlo 误差,但可以灵活计算复杂摘要。后续章节将在同一逻辑框架下处理没有闭式后验的模型。
15.8 思考题
- 用赔率形式推导“后验赔率等于先验赔率乘以似然比”。在稀有缺陷例子中,基础发生率降低十倍会怎样改变一次阳性后的概率?
- 两次筛查为什么不能仅凭“使用了两次相同设备”就假设条件独立?若结果正相关,把似然比平方会使后验产生什么方向的偏差?
- 解释似然 \(p(\mathbf y\mid\theta)\) 与后验 \(p(\theta\mid\mathbf y)\) 的区别。为什么似然不需要对\(\theta\) 积分为 1?
- 在离散参数例子中,将 \(\theta=0.7\) 的先验概率设为 0。无论观察多少成功,为什么该点的后验概率仍为 0?这个结论应怎样正确推广到连续参数?
- 从 Beta 密度和二项似然推导式 (15.2),并推导后验均值的加权形式(15.3)。
- 等尾可信区间、最高后验密度区间和频率置信区间分别怎样定义?为什么数值相近不表示解释相同?
- 为什么 \(\theta\) 的 95% 可信区间不能直接当作未来二项人数的 95% 预测区间?指出后者额外包含的随机性。
- 推导式 (15.5) 与 (15.6)。先验方差趋于无穷时,后验均值和方差分别趋向什么?
- 为什么先验预测检查比只查看参数先验的均值和方差更容易发现单位错误?
- 不当先验为什么不能简单称为“没有先验”?使用前至少要检查哪些问题?
- 两位决策者拥有相同的后验分布,却因漏判成本不同而采取不同措施。这是否与贝叶斯推断矛盾?请用后验期望损失解释。
15.9 上机实验(Lab)
Lab 1:基础概率与似然比。 固定灵敏度和特异度,让基础发生率从 \(10^{-5}\) 变化到 0.2,画出一次阳性和两次条件独立阳性后的概率曲线,并解释曲线的非线性。
Lab 2:离散先验更新。 扩展
theta_hypothesis的网格,比较均匀先验、集中先验和排除部分区间的先验。分别报告归一化常数、后验均值和后验概率,并说明网格改变是否也改变了统计模型。Lab 3:Beta 先验预测。 固定先验均值为 0.3,让先验信息量从 2 增加到 200。比较参数先验、30 人样本的先验预测分布和观察 \(x=12\) 后的后验分布。
Lab 4:可信区间与预测区间。 对 Beta–Binomial 和 Normal–Normal 两个例子分别计算参数可信区间和未来观测预测区间。改变未来样本量,解释区间宽度如何变化。
Lab 5:先验—数据冲突。 在睡眠比例例子中构造两个信息量相同但均值分别为 0.2 和 0.8 的强先验,比较先验预测、后验分布和敏感性结论。说明哪些结果来自数据,哪些结果来自先验。
拓展 Lab:解析值与模拟误差。 对不同模拟次数重复
chapter15-direct-posterior-simulation,检验解析值与模拟值之差是否与 MCSE 的数量级一致,并说明固定随机种子不能消除模拟误差。