第 19 章 后验预测与贝叶斯模型比较
第 18 章主要从参数后验解释回归关系,但许多经济统计问题最终关心的是尚未观察到的结果:明天某商圈的订单量会不会超过运力上限?模型能否再现雨天需求波动?两个候选模型的预测能力究竟相差多少?这些问题不能从一张系数表直接回答。
本章把分析对象从参数推进到数据。主线依次是:由参数后验构造预测分布,用复制数据检查模型,明确模型比较的目标,再用样本外预测和损失函数支持选择或决策。这个顺序很重要。计算正常不等于模型能解释关键数据特征;候选模型中排名第一,也不等于它已经适合实际使用。
19.1 学习目标
学完本章后,读者应当能够:
- 区分条件均值后验与未来观测的后验预测分布;
- 用复制数据检查模型能否再现与研究问题相关的统计特征;
- 解释贝叶斯因子对先验的依赖,并区分模型证据与预测评价;
- 从逐点对数似然计算 WAIC,并解释 PSIS–LOO 的目标和 Pareto \(k\) 诊断;
- 根据数据结构设计样本外评价,避免时间泄漏或分组泄漏;
- 区分严格的贝叶斯模型平均、预测权重混合和基于损失的决策。
19.2 从参数后验到预测分布
19.2.1 两类不确定性
设 \(\widetilde y\) 表示未来标量随机观测,\(\boldsymbol\theta\) 表示模型参数向量,\(\mathbf y\) 表示完整观测数据。贝叶斯后验预测分布为
\[ p(\widetilde y\mid\mathbf y) = \int p(\widetilde y\mid\boldsymbol\theta) p(\boldsymbol\theta\mid\mathbf y)\,d\boldsymbol\theta. \]
这里假定未来观测与已有观测在给定参数后条件独立,并暂时省略已知的未来协变量。\(p(\boldsymbol\theta\mid\mathbf y)\) 描述参数不确定性,\(p(\widetilde y\mid\boldsymbol\theta)\) 描述给定参数后的未来随机性。这两个不确定性在预测中都会出现。若忽略参数不确定性,预测区间通常会偏窄;若只报告参数可信区间,又不能回答未来观测值的实际波动范围。
全方差公式把两部分不确定性写得更清楚:
\[ \operatorname{Var}(\widetilde y\mid\mathbf y) =\operatorname{E}\{\operatorname{Var}(\widetilde y\mid\boldsymbol\theta) \mid\mathbf y\} +\operatorname{Var}\{\operatorname{E}(\widetilde y\mid\boldsymbol\theta) \mid\mathbf y\}. \]
第一项是给定参数后的观测波动,第二项是参数后验不确定性。增加原始数据通常会缩小第二项,但第一项未必随之消失。
如果有后验样本\(\boldsymbol\theta^{(1)},\ldots,\boldsymbol\theta^{(S)}\),后验预测可以按以下步骤模拟:
- 从后验样本中取 \(\boldsymbol\theta^{(s)}\);
- 从 \(p(\widetilde y\mid\boldsymbol\theta^{(s)})\) 中生成 \(\widetilde y^{(s)}\);
- 用 \(\widetilde y^{(1)},\ldots,\widetilde y^{(S)}\) 汇总预测均值、预测区间和事件概率。
这个算法与第 16 章用带权样本近似后验泛函的思路一致,只是这里把每个参数样本继续推进到未来数据。
以上公式通常把未来协变量向量 \(\widetilde{\mathbf x}\) 当作已知,例如给定明天气温与是否周末的情景。如果\(\widetilde{\mathbf x}\) 本身未知,还要对其分布积分。对原样本协变量生成\(\mathbf y^{\mathrm{rep}}\) 主要用于模型检查,不能自动视为真正的样本外预测。
19.2.2 贯穿案例:夜间外卖订单预测
下面使用一个模拟案例。某平台想预测一个城市商圈未来夜间外卖订单量,以便安排骑手运力和补贴预算。研究者收集了若干天的夜间订单量、气温、是否下雨、是否周末以及是否发放平台补贴。数据是模拟数据,不对应真实平台记录。
这个案例有两个有趣之处。第一,需求与气温可能不是简单线性关系:天气太冷或太热都会降低夜间订单。第二,平台不仅关心平均预测,还关心“订单量超过 700 单”的概率,因为这会触发额外骑手调度。
set.seed(1901)
n_days <- 220
day_id <- seq_len(n_days)

temp <- runif(n_days, min = 4, max = 34)
temp_c <- temp - 22
rain <- rbinom(n_days, size = 1, prob = plogis(-0.5 + 0.03 * temp))
weekend <- as.integer(day_id %% 7 %in% c(0, 6))
subsidy <- rbinom(n_days, size = 1, prob = plogis(-1.1 + 0.7 * weekend))

mu_true <- 520 + 7 * temp_c - 0.75 * temp_c^2 +
  65 * rain + 55 * weekend + 45 * subsidy + 28 * rain * weekend
sigma_true <- 45 + 22 * rain
orders <- round(rnorm(n_days, mean = mu_true, sd = sigma_true))

delivery_dat <- data.frame(
  day_id = day_id,
  orders = orders,
  temp_c = temp_c,
  rain = rain,
  weekend = weekend,
  subsidy = subsidy
)

knitr::kable(head(delivery_dat), row.names = FALSE, digits = 2)| day_id | orders | temp_c | rain | weekend | subsidy |
|---|---|---|---|---|---|
| 1 | 514 | 9.35 | 1 | 0 | 0 |
| 2 | 220 | -16.45 | 1 | 0 | 0 |
| 3 | 488 | -6.90 | 0 | 0 | 0 |
| 4 | 495 | -4.71 | 1 | 0 | 0 |
| 5 | 591 | 11.42 | 1 | 0 | 0 |
| 6 | 626 | 0.58 | 0 | 1 | 1 |
这里 orders 是夜间订单量,temp_c 是相对于 22 摄氏度的温度偏离,rain、weekend 和 subsidy分别表示是否下雨、是否周末和是否发放补贴。使用中心化温度 temp_c 是为了让截距更容易解释:当气温接近 22 摄氏度且其他变量为 0 时,截距近似表示基准订单量。
订单量较大,本章用高斯回归近似其条件分布。虽然模拟时把订单取为整数,这并不意味着小计数问题也适合高斯模型;计数较小、偏斜明显或过度离散时,应考虑 Poisson 或负二项回归。
19.2.3 用共轭模型获得后验样本
令 \(\mathbf Y\) 为 \(n\) 维随机响应向量,其观测实现为\(\mathbf y=(y_1,\ldots,y_n)^\top\);\(\mathbf X\) 为含截距列的\(n\times p\) 设计矩阵,\(\boldsymbol\beta\) 为 \(p\) 维回归系数向量,\(\mathbf b_0\) 和\(\mathbf V_0\) 分别为其先验均值向量和正定先验尺度矩阵。为避免把估计得到的残差标准差当成已知量,采用正态–逆伽马共轭模型
\[ \mathbf Y\mid\boldsymbol\beta,\sigma^2 \sim N_n(\mathbf X\boldsymbol\beta,\sigma^2\mathbf I_n), \]
\[ \boldsymbol\beta\mid\sigma^2 \sim N_p(\mathbf b_0,\sigma^2\mathbf V_0), \qquad \sigma^2\sim\operatorname{IG}(a_0,d_0). \]
\(\mathbf I_n\) 是 \(n\) 阶单位矩阵,\(a_0,d_0>0\) 是逆伽马先验的超参数。在本章约定下,\(1/\sigma^2\sim\operatorname{Gamma}(a_0,d_0)\),第二个参数是 rate。后验参数为
\[ \begin{aligned} \mathbf V_n^{-1}&=\mathbf V_0^{-1}+\mathbf X^\top\mathbf X,\\ \mathbf b_n&=\mathbf V_n(\mathbf V_0^{-1}\mathbf b_0+\mathbf X^\top\mathbf y),\\ a_n&=a_0+\frac n2,\\ d_n&=d_0+\frac12\left( \mathbf y^\top\mathbf y+\mathbf b_0^\top\mathbf V_0^{-1}\mathbf b_0 -\mathbf b_n^\top\mathbf V_n^{-1}\mathbf b_n \right). \end{aligned} \]
先抽取 \(\sigma^2\mid\mathbf y\sim\operatorname{IG}(a_n,d_n)\),再抽取\(\boldsymbol\beta\mid\sigma^2,\mathbf y\sim N_p(\mathbf b_n,\sigma^2\mathbf V_n)\),即可得到联合后验样本。由于这两个条件分布都能直接生成随机数,下面得到的是相互独立的 Monte Carlo 样本,不是 MCMC 链,因此不需要检查 \(\widehat R\) 或链间混合;有限抽样数 \(S\) 仍会带来可用 MCSE 衡量的模拟误差。
log_mean_exp <- function(x) {
  m <- max(x)
  m + log(mean(exp(x - m)))
}

make_bayes_lm_spec <- function(formula, data) {
  X <- model.matrix(formula, data = data)
  y <- model.response(model.frame(formula, data = data))
  p <- ncol(X)

  b0 <- rep(0, p)
  b0[1] <- 500
  names(b0) <- colnames(X)

  sigma_ref <- 60
  coefficient_sd <- setNames(rep(80, p), colnames(X))
  coefficient_sd["(Intercept)"] <- 100
  if ("temp_c" %in% colnames(X)) coefficient_sd["temp_c"] <- 6
  if ("I(temp_c^2)" %in% colnames(X)) {
    coefficient_sd["I(temp_c^2)"] <- 0.2
  }
  V0 <- diag((coefficient_sd / sigma_ref)^2)

  a0 <- 4
  d0 <- (a0 - 1) * sigma_ref^2

  list(
    formula = formula,
    terms = delete.response(terms(formula)),
    response = as.character(formula[[2]]),
    X = X,
    y = y,
    prior = list(b0 = b0, V0 = V0, a0 = a0, d0 = d0)
  )
}

fit_bayes_lm <- function(spec, S = 4000) {
  X <- spec$X
  y <- spec$y
  p <- ncol(X)
  b0 <- spec$prior$b0
  V0 <- spec$prior$V0
  a0 <- spec$prior$a0
  d0 <- spec$prior$d0
  V0_inv <- solve(V0)

  posterior_precision <- V0_inv + crossprod(X)
  Vn <- chol2inv(chol(posterior_precision))
  bn <- solve(
    posterior_precision,
    V0_inv %*% b0 + crossprod(X, y)
  )
  an <- a0 + length(y) / 2
  dn <- as.numeric(
    d0 + 0.5 * (
      crossprod(y) + crossprod(b0, V0_inv %*% b0) -
        crossprod(bn, posterior_precision %*% bn)
    )
  )

  sigma2_draw <- 1 / rgamma(S, shape = an, rate = dn)
  z <- matrix(rnorm(S * p), nrow = S)
  beta_draw <- sweep(z %*% chol(Vn), 1, sqrt(sigma2_draw), "*")
  beta_draw <- sweep(beta_draw, 2, as.vector(bn), "+")
  colnames(beta_draw) <- colnames(X)

  c(
    spec,
    list(
      beta_draw = beta_draw,
      sigma_draw = sqrt(sigma2_draw)
    )
  )
}

posterior_predict <- function(fit, newdata, include_noise = TRUE) {
  X_new <- model.matrix(fit$terms, data = newdata)
  mu <- fit$beta_draw %*% t(X_new)

  if (!include_noise) {
    return(mu)
  }

  matrix(
    rnorm(
      length(mu), mean = as.vector(mu),
      sd = rep(fit$sigma_draw, times = ncol(mu))
    ),
    nrow = nrow(mu)
  )
}

pointwise_loglik <- function(fit, data) {
  X_eval <- model.matrix(fit$terms, data = data)
  y_eval <- data[[fit$response]]
  mu <- fit$beta_draw %*% t(X_eval)

  matrix(
    dnorm(rep(y_eval, each = nrow(mu)),
          mean = as.vector(mu),
          sd = rep(fit$sigma_draw, times = ncol(mu)),
          log = TRUE),
    nrow = nrow(mu)
  )
}

prior_predict <- function(fit, newdata, S = 4000) {
  X_new <- model.matrix(fit$terms, data = newdata)
  prior <- fit$prior
  sigma2 <- 1 / rgamma(S, shape = prior$a0, rate = prior$d0)
  z <- matrix(rnorm(S * length(prior$b0)), nrow = S)
  beta <- sweep(z %*% chol(prior$V0), 1, sqrt(sigma2), "*")
  beta <- sweep(beta, 2, prior$b0, "+")
  mu <- beta %*% t(X_new)

  matrix(
    rnorm(
      length(mu), mean = as.vector(mu),
      sd = rep(sqrt(sigma2), times = ncol(mu))
    ),
    nrow = S
  )
}
函数中的 b0 把基准订单量放在 500 附近,并让其余系数先验以 0 为中心。coefficient_sd 给出\(\sigma=60\) 时各系数的条件先验标准差;由于先验写成\(\boldsymbol\beta\mid\sigma^2\sim N_p(\mathbf b_0,\sigma^2\mathbf V_0)\),误差尺度改变时,系数先验的离散程度也随之改变。取 \(a_0=4\)、\(d_0=3\times60^2\),使\(\operatorname{E}(\sigma^2)=d_0/(a_0-1)=60^2\)。这些数值表达的是一个完整联合先验,不能把每一项孤立解释。
19.2.4 模型设定与先验预测检查
先设定一个包含二次温度项的模型:
\[ Y_i = \beta_0 +\beta_1\operatorname{temp}_{c,i} +\beta_2\operatorname{temp}_{c,i}^2 +\beta_3\operatorname{rain}_i +\beta_4\operatorname{weekend}_i +\beta_5\operatorname{subsidy}_i +\varepsilon_i. \]
其中 \(Y_i\) 是第 \(i\) 天夜间随机订单量,观测实现记为 \(y_i\);\(\operatorname{temp}_{c,i}\) 是中心化气温,并且\(\varepsilon_i\overset{\mathrm{iid}}{\sim}N(0,\sigma^2)\),\(i=1,\ldots,n\)。二次项允许订单量随气温先升后降。
quad_spec <- make_bayes_lm_spec(
  orders ~ temp_c + I(temp_c^2) + rain + weekend + subsidy,
  data = delivery_dat
)
quad_spec 此时只包含公式、设计矩阵与先验,还没有用响应数据更新参数。下面先对观测协变量设计生成先验复制数据,检查联合先验是否把大量概率质量放在不可能的订单范围。先验预测必须先于模型拟合,否则就容易根据已经看见的后验结果反向调整先验。
set.seed(1900)
y_prior_rep <- prior_predict(quad_spec, delivery_dat, S = 3000)
prior_predictive_check <- data.frame(
  q005 = quantile(y_prior_rep, 0.005),
  median = median(y_prior_rep),
  q995 = quantile(y_prior_rep, 0.995),
  P_below_0 = mean(y_prior_rep < 0),
  P_above_1200 = mean(y_prior_rep > 1200)
)

knitr::kable(
  prior_predictive_check, row.names = FALSE, digits = 3,
  caption = "给定协变量设计的先验预测检查"
)| q005 | median | q995 | P_below_0 | P_above_1200 |
|---|---|---|---|---|
| 48.67 | 500.2 | 972.8 | 0.003 | 0.001 |
先验预测不是要求模型提前猜准数据,而是排除明显荒谬的量级。若负订单或数千单的概率很高,应重新检查响应分布和系数尺度;不应等看到后验结果后才调整先验以追求某个结论。
19.2.5 条件均值、未来观测与事件概率
确认先验预测的量级可以接受以后,才用观测响应更新参数,并把后验推到未来情景。下面的参数表首先检查方向和量级是否符合模型设定;它不是预测分析的终点。
coef_summary <- data.frame(
  term = colnames(fit_quad$X),
  mean = colMeans(fit_quad$beta_draw),
  q025 = apply(fit_quad$beta_draw, 2, quantile, 0.025),
  q975 = apply(fit_quad$beta_draw, 2, quantile, 0.975)
)

knitr::kable(coef_summary, row.names = FALSE, digits = 3)| term | mean | q025 | q975 |
|---|---|---|---|
| (Intercept) | 516.177 | 499.756 | 532.598 |
| temp_c | 7.042 | 5.897 | 8.185 |
| I(temp_c^2) | -0.741 | -0.851 | -0.628 |
| rain | 75.122 | 58.844 | 90.820 |
| weekend | 61.158 | 42.770 | 79.256 |
| subsidy | 48.192 | 30.418 | 65.683 |
现在考虑一个未来情景:明天夜间气温比 22 摄氏度高 4 度,下雨,是周末,并且平台发放补贴。我们希望预测订单量,并计算超过 700 单的概率。
future_day <- data.frame(
  temp_c = 4,
  rain = 1,
  weekend = 1,
  subsidy = 1
)

mu_future <- posterior_predict(fit_quad, future_day, include_noise = FALSE)[, 1]
y_future <- posterior_predict(fit_quad, future_day, include_noise = TRUE)[, 1]
prob_above_capacity <- mean(pnorm(
  700, mean = mu_future, sd = fit_quad$sigma_draw,
  lower.tail = FALSE
))

future_summary <- data.frame(
  quantity = c("条件均值的后验均值",
               "条件均值的5%分位数",
               "条件均值的95%分位数",
               "未来订单量的预测均值",
               "未来订单量的5%分位数",
               "未来订单量的95%分位数",
               "未来订单量超过700的概率"),
  value = c(mean(mu_future),
            quantile(mu_future, 0.05),
            quantile(mu_future, 0.95),
            mean(y_future),
            quantile(y_future, 0.05),
            quantile(y_future, 0.95),
            prob_above_capacity)
)

knitr::kable(future_summary, row.names = FALSE, digits = 3)| quantity | value |
|---|---|
| 条件均值的后验均值 | 716.960 |
| 条件均值的5%分位数 | 700.353 |
| 条件均值的95%分位数 | 734.330 |
| 未来订单量的预测均值 | 715.886 |
| 未来订单量的5%分位数 | 617.295 |
| 未来订单量的95%分位数 | 816.428 |
| 未来订单量超过700的概率 | 0.609 |
这里有两个分布需要区分。mu_future 表示\(\mu(\widetilde{\mathbf x},\boldsymbol\theta) =\operatorname{E}(\widetilde y\mid\widetilde{\mathbf x},\boldsymbol\theta)\) 随参数后验变化形成的分布,区间反映未知回归参数造成的条件均值不确定性;对它取后验平均以后,\(\operatorname{E}(\widetilde y\mid\widetilde{\mathbf x},\mathbf y)\) 本身只是一个数。y_future 则来自未来实际订单量的后验预测分布,还包含给定参数后的当天随机波动,因此区间通常更宽。在运营决策中,如果要安排骑手,应更关注后者。
超过 700 单的概率用条件正态尾概率再对后验平均,而不是只统计一次模拟中超过阈值的比例。这是Rao–Blackwell 化:两种方法针对同一个预测概率,前者没有额外的 0–1 模拟噪声。
19.3 后验预测检查
后验预测检查(posterior predictive check,PPC)的思想是:如果模型合理,那么从模型生成的复制数据应当在关键特征上类似于观测数据。设 \(T(\mathbf y)\) 是一个复制统计量,例如均值、标准差、高峰比例或组间差异。对每个后验样本生成复制数据\(\mathbf y^{\mathrm{rep}}\),比较
\[ T(\mathbf y^{\mathrm{rep}}) \]
和
\[ T(\mathbf y). \]
常用的后验预测 p 值为
\[ p_B = P\{T(\mathbf y^{\mathrm{rep}})\ge T(\mathbf y)\mid\mathbf y\}. \]
这里 \(p_B\) 是模型检查指标,不是频率学派假设检验中的 p 值。若它非常接近 0 或 1,说明观测数据的某个特征位于模型复制分布的极端位置,模型可能遗漏了重要结构。
下面检查二次模型能否再现四个数据特征:平均订单量、订单量标准差、高峰天数比例,以及雨天与非雨天订单波动差异。
set.seed(1903)
y_rep <- posterior_predict(fit_quad, delivery_dat, include_noise = TRUE)
y_obs <- delivery_dat$orders
rain_idx <- delivery_dat$rain == 1
dry_idx <- delivery_dat$rain == 0

T_obs <- c(
  mean_orders = mean(y_obs),
  sd_orders = sd(y_obs),
  high_share = mean(y_obs > 700),
  rainy_minus_dry_sd = sd(y_obs[rain_idx]) - sd(y_obs[dry_idx])
)

T_rep <- data.frame(
  mean_orders = rowMeans(y_rep),
  sd_orders = apply(y_rep, 1, sd),
  high_share = rowMeans(y_rep > 700),
  rainy_minus_dry_sd = apply(y_rep[, rain_idx], 1, sd) -
    apply(y_rep[, dry_idx], 1, sd)
)

statistic_label <- c(
  mean_orders = "平均订单量",
  sd_orders = "订单量标准差",
  high_share = "高峰天数比例",
  rainy_minus_dry_sd = "雨天与非雨天标准差之差"
)

ppc_summary <- data.frame(
  statistic = unname(statistic_label[names(T_obs)]),
  observed = as.numeric(T_obs),
  replicated_mean = colMeans(T_rep),
  posterior_predictive_p = sapply(names(T_obs), function(nm) {
    mean(T_rep[[nm]] >= T_obs[nm])
  })
)

knitr::kable(ppc_summary, row.names = FALSE, digits = 3)| statistic | observed | replicated_mean | posterior_predictive_p |
|---|---|---|---|
| 平均订单量 | 496.373 | 496.377 | 0.502 |
| 订单量标准差 | 155.462 | 154.612 | 0.439 |
| 高峰天数比例 | 0.077 | 0.066 | 0.284 |
| 雨天与非雨天标准差之差 | 23.375 | 1.263 | 0.003 |
old_par <- par(no.readonly = TRUE)
par(mfrow = c(2, 2), mar = c(3.5, 3.5, 2, 1), family = "sans")

for (nm in names(T_obs)) {
  hist(T_rep[[nm]], breaks = 35, col = "gray85", border = "white",
       main = statistic_label[nm], xlab = "复制统计量")
  abline(v = T_obs[nm], col = "#D55E00", lwd = 2)
}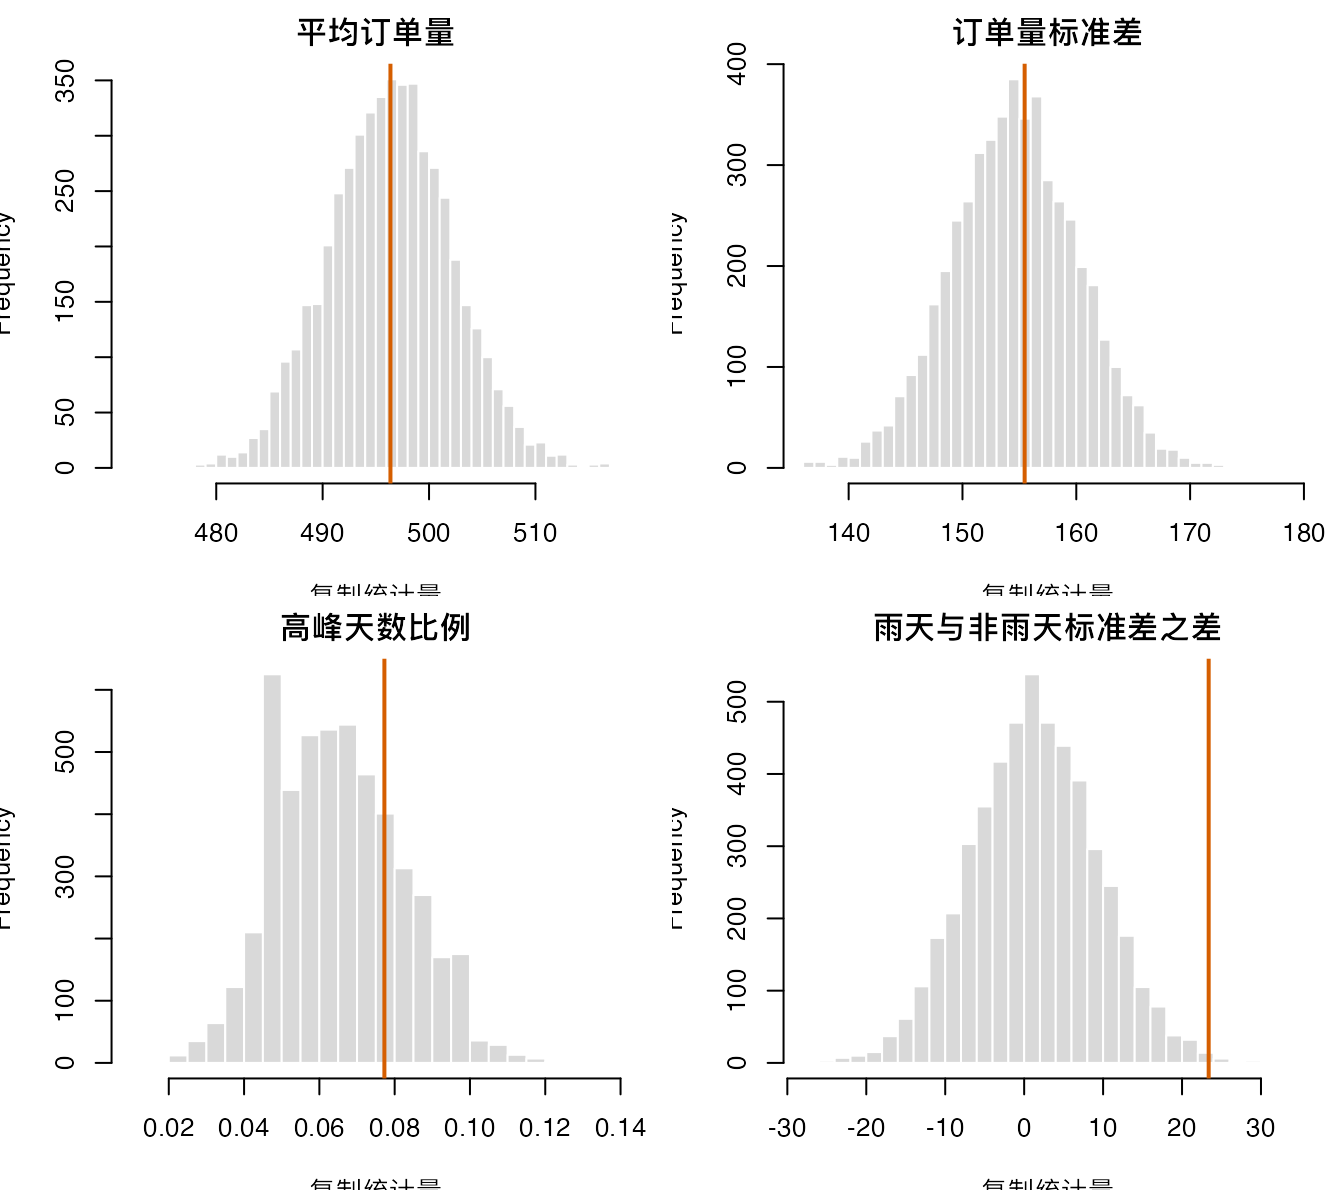
图19.1: 观测统计量在后验复制分布中的位置。
如果均值和高峰比例能够被复制,但雨天与非雨天的波动差异难以复制,就提示当前模型可能仍有缺陷。在本案例中,原因可能是遗漏了 rain:weekend 均值交互,也可能是误差方差随天气变化,而当前模型使用了同方差正态误差。后验预测检查能定位模型在哪些方面不够好,却不能单凭一个异常统计量确定原因;需要提出新模型,再检查该缺陷是否得到修正。
后验预测 p 值重复使用了数据:数据既形成后验,又与该后验生成的复制数据比较。因此它一般不服从\(\operatorname{Unif}(0,1)\),也不应套用传统显著性检验的固定阈值。统计量应在分析前根据实际风险选择;只在许多图中挑最极端的一幅,同样会造成选择性解释。
19.4 贝叶斯模型比较
模型比较首先要明确目标。不同准则回答的问题并不相同:
| 方法 | 主要问题 | 适合场景 | 注意事项 |
|---|---|---|---|
| 贝叶斯因子 | 数据相对支持哪个模型 | 少数候选模型、先验经过认真设定 | 对先验敏感,边际似然可能难算 |
| WAIC | 哪个模型的逐点样本外预测表现更好 | 有后验样本和逐点似然 | 是渐近近似,后验异常时需谨慎 |
| PSIS–LOO | 留出一个预测单位时表现如何 | 预测导向比较,可复用后验样本 | 必须检查 Pareto \(k\),留出单位取决于数据结构 |
| 训练测试划分 | 样本外预测误差 | 预测是核心目标且样本量较充足 | 结果受划分影响,可重复划分 |
19.4.1 模型证据:边际似然与先验敏感性
经典贝叶斯模型比较基于边际似然。给定模型 \(M\),
\[ p(\mathbf y\mid M) = \int p(\mathbf y\mid\boldsymbol\theta,M) p(\boldsymbol\theta\mid M)\,d\boldsymbol\theta. \]
两个模型 \(M_1\) 和 \(M_0\) 的贝叶斯因子(Bayes factor)为
\[ \operatorname{BF}_{10} = \frac{p(\mathbf y\mid M_1)}{p(\mathbf y\mid M_0)}. \]
如果模型先验概率相同,\(\operatorname{BF}_{10}>1\) 表示数据相对更支持 \(M_1\)。但边际似然会把先验分布也积分进去,因此贝叶斯因子对先验宽窄可能敏感。对于本科阶段的应用课程,更重要的是理解它的含义,而不必把它作为唯一模型比较工具。
第 13 章介绍的 BIC 与边际似然有一个大样本联系。在参数维数固定、模型正则、先验在最大似然估计附近平滑且为正等条件下,Laplace 近似给出
\[ -2\log p(\mathbf y\mid M)=\operatorname{BIC}_M+\mathcal O(1), \]
因而 \(2\log \operatorname{BF}_{10}\approx\operatorname{BIC}_0-\operatorname{BIC}_1\)。BIC 忽略了不随样本量增长的先验项,所以它只是特定条件下的渐近近似,不是任意模型和任意先验下的精确贝叶斯因子。
贝叶斯因子更新的是模型先验赔率:
\[ \frac{P(M_1\mid\mathbf y)}{P(M_0\mid\mathbf y)} =\operatorname{BF}_{10}\frac{P(M_1)}{P(M_0)}. \]
下面用一个可精确计算的二项模型观察先验敏感性。零假设模型 \(M_0\) 固定成功概率 \(p=0.5\);备择模型\(M_1\) 令 \(p\sim\operatorname{Beta}(a,a)\)。观测 40 次试验中的 28 次成功。
n_bf <- 40
y_bf <- 28
a_grid <- c(0.5, 1, 10, 100, 1000)

log_marginal_null <- dbinom(y_bf, n_bf, prob = 0.5, log = TRUE)
log_marginal_alt <- lchoose(n_bf, y_bf) +
  lbeta(y_bf + a_grid, n_bf - y_bf + a_grid) -
  lbeta(a_grid, a_grid)

log_bf10 <- log_marginal_alt - log_marginal_null
bayes_factor_check <- data.frame(
  beta_a = a_grid,
  BF10 = exp(log_bf10),
  posterior_P_M1_equal_prior_odds = plogis(log_bf10)
)

knitr::kable(
  bayes_factor_check, row.names = FALSE, digits = 4,
  col.names = c(
    "$a$", "$\\operatorname{BF}_{10}$",
    "$P(M_1\\mid\\mathbf y)$(等先验赔率)"
  ),
  caption = "不同备择先验下的贝叶斯因子",
  escape = FALSE
)| \(a\) | \(\operatorname{BF}_{10}\) | \(P(M_1\mid\mathbf y)\)(等先验赔率) |
|---|---|---|
| 5e-01 | 3.367 | 0.7710 |
| 1e+00 | 4.800 | 0.8276 |
| 1e+01 | 5.150 | 0.8374 |
| 1e+02 | 1.560 | 0.6094 |
| 1e+03 | 1.054 | 0.5132 |
数据没有改变,贝叶斯因子却随 \(M_1\) 对 \(p\) 的先验预测而改变。这里\(\operatorname{Beta}(0.5,0.5)\) 呈 U 形,把较多质量放在 0 和 1 附近;\(\operatorname{Beta}(1,1)\) 是均匀分布;\(a\) 增大时先验越来越集中在 0.5。前两类先验把概率质量分散到许多与数据不符的区域,会受到边际似然惩罚;极度集中在 0.5 附近的备择又与零模型越来越相似。先验敏感性是贝叶斯因子的定义所致,不是数值算法的缺陷。
19.4.2 预测表现:WAIC
预测导向的贝叶斯模型比较常使用 WAIC。它利用逐点对数预测密度衡量拟合,同时用后验样本中的变异估计有效复杂度。给定后验样本\(\boldsymbol\theta^{(1)},\ldots,\boldsymbol\theta^{(S)}\),定义
\[ \operatorname{lppd} = \sum_{i=1}^n \log\left[ \frac{1}{S}\sum_{s=1}^S p(y_i\mid\boldsymbol\theta^{(s)}) \right]. \]
这里 \(p(y_i\mid\boldsymbol\theta^{(s)})\) 是第 \(s\) 个后验样本下第 \(i\) 个观测的似然值。第 \(i\) 个观测对有效复杂度的贡献及其总和分别定义为
\[ p_{\mathrm{WAIC},i} =\operatorname{Var}_{s}\{\log p(y_i\mid\boldsymbol\theta^{(s)})\}, \qquad p_{\mathrm{WAIC}}=\sum_{i=1}^n p_{\mathrm{WAIC},i}. \]
于是
\[ \operatorname{WAIC} = -2(\operatorname{lppd}-p_{\mathrm{WAIC}}). \]
WAIC 越小,通常表示预测表现越好。实际比较时常看 \(\Delta\operatorname{WAIC}\),即某模型 WAIC 与最小 WAIC 的差。更重要的是报告逐点预测差异的标准误;差异与其标准误处于同一量级时,不应宣布某个模型“胜出”。这里的“逐点”还必须与预测任务一致:时间序列可能按时间块定义,层次数据可能按个体或群组定义,不能机械地把每一行都当成独立预测单位。
下面比较三个候选模型:
\[ M_1:\ Y_i=\beta_0+\beta_1\operatorname{temp}_{c,i} +\beta_2\operatorname{rain}_i +\beta_3\operatorname{weekend}_i +\beta_4\operatorname{subsidy}_i+\varepsilon_i, \]
\[ M_2:\ M_1+\beta_5\operatorname{temp}_{c,i}^2, \]
\[ M_3:\ M_2+\beta_6(\operatorname{rain}_i\times\operatorname{weekend}_i). \]
waic_from_loglik <- function(loglik) {
  lppd_i <- apply(loglik, 2, log_mean_exp)
  p_waic_i <- apply(loglik, 2, var)
  elpd_i <- lppd_i - p_waic_i

  list(
    summary = data.frame(
      elpd_waic = sum(elpd_i),
      p_waic = sum(p_waic_i),
      waic = -2 * sum(elpd_i),
      n_pwaic_gt_0.4 = sum(p_waic_i > 0.4)
    ),
    pointwise_elpd = elpd_i
  )
}set.seed(1904)
model_formulas <- list(
"线性模型" = orders ~ temp_c + rain + weekend + subsidy,
"二次模型" = orders ~ temp_c + I(temp_c^2) + rain + weekend + subsidy,
"交互模型" = orders ~ temp_c + I(temp_c^2) + rain * weekend + subsidy
)
model_specs <- lapply(
model_formulas,
make_bayes_lm_spec,
data = delivery_dat
)
model_fits <- lapply(model_specs, fit_bayes_lm, S = 4000)
waic_results <- lapply(model_fits, function(fit) {
waic_from_loglik(pointwise_loglik(fit, delivery_dat))
})
waic_tab <- do.call(
rbind,
lapply(names(waic_results), function(nm) {
data.frame(model = nm, waic_results[[nm]]$summary)
})
)
best_model <- waic_tab$model[which.max(waic_tab$elpd_waic)]
best_pointwise <- waic_results[[best_model]]$pointwise_elpd
elpd_difference <- lapply(waic_tab$model, function(nm) {
diff_i <- waic_results[[nm]]$pointwise_elpd - best_pointwise
c(elpd_diff = sum(diff_i),
se_elpd_diff = sqrt(length(diff_i) * var(diff_i)))
})
elpd_difference <- do.call(rbind, elpd_difference)
waic_tab <- cbind(waic_tab, elpd_difference)
waic_tab$delta_waic <- -2 * waic_tab$elpd_diff
raw_weight <- exp(-0.5 * waic_tab$delta_waic)
waic_tab$waic_pseudo_weight <- raw_weight / sum(raw_weight)
knitr::kable(waic_tab, row.names = FALSE, digits = 3)| model | elpd_waic | p_waic | waic | n_pwaic_gt_0.4 | elpd_diff | se_elpd_diff | delta_waic | waic_pseudo_weight |
|---|---|---|---|---|---|---|---|---|
| 线性模型 | -1280 | 6.049 | 2560 | 0 | -68.929 | 8.928 | 137.86 | 0.000 |
| 二次模型 | -1214 | 6.389 | 2427 | 0 | -2.385 | 2.428 | 4.77 | 0.084 |
| 交互模型 | -1211 | 7.226 | 2423 | 0 | 0.000 | 0.000 | 0.00 | 0.916 |
n_pwaic_gt_0.4 统计逐点有效复杂度异常偏大的观测数,可作为 WAIC 近似可能不稳定的警示。waic_pseudo_weight 只是由 WAIC 差异指数化得到的启发式权重,不是模型后验概率,也不是通过优化样本外预测得到的 stacking 权重。若模型的 elpd_diff 与 se_elpd_diff 同量级,应把它们视为预测表现难以区分,而不是过度解读排序。
本例中,交互模型相对二次模型的 ELPD 优势与其标准误处于同一量级,因而证据并不明确;指数化后的伪权重看起来却可能相当集中。这正说明权重不能脱离差异标准误解释。并且,WAIC 排名较高也没有消除后验预测检查发现的异方差缺陷:候选模型中的“最好”不等于模型已经足够好。
19.4.3 PSIS–LOO:带诊断的留一近似
留一交叉验证直接以
\[ \operatorname{elpd}_{\mathrm{loo}} = \sum_{i=1}^n \log\int p(y_i\mid\boldsymbol\theta) p(\boldsymbol\theta\mid\mathbf y_{-i})\,d\boldsymbol\theta \]
其中 \(\mathbf y_{-i}\) 表示删除第 \(i\) 个观测 \(y_i\) 后的数据。该式评价每个观测在没有参与自身拟合时的预测密度。逐点重新拟合 \(n\) 次通常昂贵。若已有全数据后验样本\(\boldsymbol\theta^{(s)}\sim p(\boldsymbol\theta\mid\mathbf y)\),可利用重要性比率
\[ r_i^{(s)}\propto \frac{p(\boldsymbol\theta^{(s)}\mid\mathbf y_{-i})} {p(\boldsymbol\theta^{(s)}\mid\mathbf y)} \propto \frac{1}{p(y_i\mid\boldsymbol\theta^{(s)})} \]
近似留一后验。问题在于,某个观测对后验影响很强时,原始重要性权重会极不稳定。Pareto smoothing对最大的一部分权重作尾部平滑,并用形状参数 \(k\) 诊断近似可靠性,这就是 PSIS–LOO。相较于只给出一个总分的准则,PSIS–LOO 的价值还在于它指出哪些观测需要进一步检查。
WAIC 与 LOO 在适当正则条件下具有相近的渐近目标,但有限样本中可能不同。实践中通常优先使用带Pareto \(k\) 诊断的 PSIS–LOO;若某些 \(k\) 过大,应考虑精确重拟合、K 折交叉验证或修改模型,而不是继续解释不可靠的近似。下一章将展示如何保存逐点对数似然并调用成熟软件完成这些计算。
19.5 面向部署的样本外评价
WAIC 使用全样本后验和逐点似然,近似逐点样本外预测。更直接的做法是留出测试集,比较模型对未参与拟合数据的预测表现。第 13 章已经系统讨论分折、泄漏和依赖数据的验证设计;这里突出贝叶斯分析特有的输出,即对参数后验积分后的预测密度、预测区间和事件概率。由于任务是预测未来日期,下面按时间顺序用前 75% 天拟合、后 25% 天测试。随机拆分会把较晚日期的信息放进训练集,不符合真正部署时的信息集。
set.seed(1905)
split_day <- floor(0.75 * nrow(delivery_dat))
train_dat <- delivery_dat[seq_len(split_day), ]
test_dat <- delivery_dat[(split_day + 1L):nrow(delivery_dat), ]

holdout_tab <- data.frame()
for (nm in names(model_formulas)) {
  train_spec <- make_bayes_lm_spec(model_formulas[[nm]], train_dat)
  fit_train <- fit_bayes_lm(train_spec, S = 3500)

  mu_test <- posterior_predict(fit_train, test_dat, include_noise = FALSE)
  y_test_rep <- posterior_predict(fit_train, test_dat, include_noise = TRUE)
  pred_mean <- colMeans(mu_test)

  loglik_test <- pointwise_loglik(fit_train, test_dat)
  test_lpd <- sum(apply(loglik_test, 2, log_mean_exp))

  prob_high <- colMeans(pnorm(
    700, mean = mu_test,
    sd = fit_train$sigma_draw,
    lower.tail = FALSE
  ))
  brier_high <- mean(
    (as.integer(test_dat$orders > 700) - prob_high)^2
  )

  pred_lower <- apply(y_test_rep, 2, quantile, 0.05)
  pred_upper <- apply(y_test_rep, 2, quantile, 0.95)
  cover90 <- mean(test_dat$orders >= pred_lower &
                    test_dat$orders <= pred_upper)

  holdout_tab <- rbind(
    holdout_tab,
    data.frame(
      model = nm,
      test_rmse = sqrt(mean((test_dat$orders - pred_mean)^2)),
      mean_test_lpd = test_lpd / nrow(test_dat),
      coverage_90 = cover90,
      high_event_brier = brier_high
    )
  )
}

knitr::kable(holdout_tab, row.names = FALSE, digits = 3)| model | test_rmse | mean_test_lpd | coverage_90 | high_event_brier |
|---|---|---|---|---|
| 线性模型 | 75.30 | -5.747 | 0.909 | 0.072 |
| 二次模型 | 66.50 | -5.624 | 0.855 | 0.070 |
| 交互模型 | 65.48 | -5.608 | 0.855 | 0.064 |
RMSE 衡量点预测误差,平均测试对数预测密度衡量整个预测分布对观测值的支持程度,覆盖率检查预测区间是否大致校准,Brier 分数衡量“超过 700 单”这一事件概率的质量。RMSE 与 Brier 分数越小越好,对数预测密度越大越好;覆盖率则看它与名义水平 90% 的偏差,并结合区间宽度解释。只有 55 个测试日时,覆盖率不可能精确等于 0.9;单次留出的模型排序也有抽样波动。时间数据更稳妥的评价通常采用多个滚动预测起点。
19.6 预测混合、决策与完整工作流
19.6.1 模型平均与预测混合
模型比较不一定意味着只能选一个模型。贝叶斯思想中一个自然做法是模型平均:
\[ p(\widetilde y\mid\mathbf y) = \sum_{k=1}^K p(\widetilde y\mid\mathbf y,M_k)P(M_k\mid\mathbf y). \]
其中 \(M_k\) 是第 \(k\) 个候选模型,\(P(M_k\mid\mathbf y)\) 是由模型先验概率和边际似然得到的模型后验概率。这才是严格意义的贝叶斯模型平均(BMA)。WAIC 伪权重没有这一解释;下面只是用它们演示预测分布如何混合,结果应称为 WAIC 加权预测。实际预测中还可用留一预测表现优化 stacking 权重。
set.seed(1906)
waic_pseudo_weight <- setNames(
  waic_tab$waic_pseudo_weight, waic_tab$model
)

future_pred_by_model <- lapply(model_fits, function(fit) {
  posterior_predict(fit, future_day, include_noise = TRUE)[, 1]
})

S_mix <- 5000
model_draw <- sample(names(model_fits), size = S_mix, replace = TRUE,
                     prob = waic_pseudo_weight[names(model_fits)])
waic_mix_pred <- numeric(S_mix)

for (nm in names(model_fits)) {
  id <- which(model_draw == nm)
  if (length(id) > 0) {
    waic_mix_pred[id] <- sample(
      future_pred_by_model[[nm]], size = length(id), replace = TRUE
    )
  }
}

waic_mix_summary <- data.frame(
  quantity = c("WAIC 加权预测均值",
               "WAIC 加权预测5%分位数",
               "WAIC 加权预测95%分位数",
               "订单量超过700的预测概率"),
  value = c(mean(waic_mix_pred),
            quantile(waic_mix_pred, 0.05),
            quantile(waic_mix_pred, 0.95),
            mean(waic_mix_pred > 700))
)

knitr::kable(waic_mix_summary, row.names = FALSE, digits = 3)| quantity | value |
|---|---|
| WAIC 加权预测均值 | 731.914 |
| WAIC 加权预测5%分位数 | 629.076 |
| WAIC 加权预测95%分位数 | 830.616 |
| 订单量超过700的预测概率 | 0.692 |
预测混合不能修复所有模型共同遗漏的结构。本例三个候选模型都假设同方差正态误差,所以即使混合后仍可能低估雨天需求波动。模型集合本身也是建模假设;“在三个模型中平均”没有考虑集合之外的模型。
19.6.2 从预测概率到行动
预测最终要进入行动。假设提前增加运力的成本为 \(C\),不增加运力却出现超过 700 单需求时的损失为\(L\),其他损失暂记为 0。增加运力的期望损失是 \(C\),不增加的期望损失是\(L\,P(\widetilde y>700\mid\mathbf y)\),所以当
\[ P(\widetilde y>700\mid\mathbf y)>\frac{C}{L} \]
时应增加运力。概率阈值来自损失比,而不是固定的 0.5。现实决策还要考虑运力不足程度、连续行动和约束条件,但这个简单公式说明模型比较指标本身不是决策规则。
把预测转化为行动之前,各项检查有明确的依赖关系。预测对象、时间范围、可用协变量和损失应在拟合前写清,先验也要先在数据尺度上接受预测检查。模型拟合以后,应先确认后验计算可靠,再区分条件均值与未来观测,并用任务相关的复制统计量检查候选模型是否共同遗漏重要结构。
只有候选模型基本可用时,模型证据或预测评价才值得解释。此时要同时报告差异及其不确定性,并检查PSIS–LOO 的 Pareto \(k\);时间、空间和层次数据还要按依赖结构定义留出单位。最后,选择或混合产生的预测分布必须与损失函数结合,才能形成行动建议。后一环节不能补救前一环节的失败。
19.7 本章小结
后验预测分布把参数不确定性与未来观测随机性结合起来;两者可由全方差公式清楚分解。后验预测检查通过复制数据检查模型能否再现重要特征,但其后验预测 p 值不是传统显著性检验的 p 值。模型比较应在模型检查之后进行,因为候选集合中排名第一的模型仍可能共同遗漏关键结构。
贝叶斯因子基于边际似然,回答模型证据问题,并且必然依赖参数先验和模型先验赔率。WAIC 与PSIS–LOO 面向逐点样本外预测,需要逐点对数似然、差异标准误以及相应的稳定性诊断;Pareto \(k\)使 PSIS–LOO 能够指出重要性近似可能失效的观测。真正的未来预测还应使用符合部署顺序的留出设计。严格 BMA 使用模型后验概率;WAIC 伪权重混合与 stacking 属于不同的预测策略。最终模型输出是否有用,要由具体损失和决策约束判断。
19.8 思考题
- 用全方差公式解释:为什么原始样本量很大时,未来观测的预测区间仍可能很宽?
- 对原样本协变量生成 \(\mathbf y^{\mathrm{rep}}\) 与预测真正的新日期有什么区别?
- 为什么后验预测 p 值不应直接套用 0.05 的显著性检验规则?
- 所有候选模型都遗漏异方差时,WAIC 选出的最佳模型是否就适合风险预测?
- 贝叶斯因子为什么会随备择模型的先验宽度变化?这是不是“不够客观”的数值误差?
- 若两个模型的 ELPD 差为 3、差异标准误为 4,应如何解释?只报告排序会遗漏什么?
- 为什么面向未来日期的任务不宜随意随机拆分训练集和测试集?
- BMA 权重、WAIC 伪权重和 stacking 权重分别来自什么目标?
- 推导增加运力的阈值 \(C/L\)。如果漏配运力的损失随订单超额连续增加,这个规则需要怎样修改?
- PSIS–LOO 中某个观测的 Pareto \(k\) 很大,说明了什么?为什么这既可能是计算近似问题,也可能暴露统计模型的问题?
19.9 上机实验(Lab)
Lab 1:阈值概率。 把高峰阈值改为 650 和 750,分别用预测模拟比例与条件尾概率平均估计超限概率;重复实验并比较 Monte Carlo 波动。
Lab 2:复制统计量。 增加最大订单量、雨天 90% 分位数和连续两个高峰日次数三个统计量。解释它们分别检查模型的哪一部分,而不只报告后验预测 p 值。
Lab 3:修正异方差。 令雨天和非雨天具有不同误差标准差,重新拟合模型并比较后验预测检查、测试对数预测密度和区间覆盖率。
Lab 4:贝叶斯因子敏感性。 在 Beta–二项例子中改变成功次数和 \(a\),画出\(\log \operatorname{BF}_{10}\) 随先验尺度变化的曲线,并解释备择模型何时接近零模型。
Lab 5:WAIC 不确定性。 加入
subsidy:weekend交互项,报告 ELPD 差、差异标准误和异常\(p_{\mathrm{WAIC},i}\) 数量。不得只根据最小 WAIC 作结论。Lab 6:滚动预测。 设计至少五个滚动预测起点,比较三个模型的 RMSE、平均测试对数密度、高峰 Brier分数和覆盖率,并说明模型排序是否稳定。
Lab 7:预测混合。 比较单一最佳模型、WAIC 伪权重混合和等权混合的测试集表现,说明为什么该实验仍不等于严格的 BMA 或 stacking。
拓展 Lab:精确 LOO 与 PSIS。 在一个较小样本上逐点重新拟合模型,计算精确 LOO;再用同一组逐点对数似然计算 PSIS–LOO。比较两者差异与 Pareto \(k\),并调查误差最大的观测。