第 12 章 线性模型与广义线性模型的计算
回归课上的模型常以公式出现,软件给出的则是一张系数表。两者之间还有一条不能省略的计算链:模型公式先被展开为设计矩阵,估计准则再被写成矩阵方程或迭代更新;矩阵分解给出系数,也给出残差、标准误、杠杆值和预测的不确定性。若只会调用 lm() 或 glm(),这条链往往藏在函数内部;一旦遇到共线性、完全分离、过度离散或不收敛,便很难判断问题出在哪里。
本章把第 4 章的 QR 分解与第 6 章的 Newton 方法放回统计模型中。重点不在重新讲授回归理论,而在回答四个计算问题:数据怎样变成矩阵,系数怎样求出,标准误从哪里来,以及什么证据表明计算结果值得继续解释。
学完本章后,读者应当能够:
- 用
model.frame()和model.matrix()检查公式实际生成的响应向量、设计矩阵、因子编码和分析样本; - 从最小二乘准则推出正规方程,并用带主元的 QR 分解计算系数、残差、标准误和杠杆值;
- 说明加权最小二乘如何把线性模型与广义线性模型的 IRLS 算法连接起来;
- 从 GLM 的 score 和 Fisher 信息推出工作响应与工作权重,并手写、验证一个 Logistic IRLS;
- 区分数值收敛与模型适合度,诊断秩亏、病态设计、完全分离、过度离散和残差依赖;
- 明确区分对数尺度拟合值、原尺度条件均值和新观测预测。
12.1 从模型公式到计算对象
12.1.1 formula 如何生成设计矩阵
设第 \(i\) 个观测包含响应 \(y_i\) 和解释变量。模型计算真正接收的对象不是公式文字,而是
\[ \mathbf y=(y_1,\ldots,y_n)^\top, \qquad \mathbf X= \begin{pmatrix} \mathbf x_1^\top\\ \vdots\\ \mathbf x_n^\top \end{pmatrix}. \]
这里 \(\mathbf y\in\mathbb R^n\),\(\mathbf X\in\mathbb R^{n\times p}\),而\(\mathbf x_i\in\mathbb R^p\) 是设计矩阵的第 \(i\) 行转置后得到的列向量;若模型含截距,\(\mathbf x_i\) 的相应分量恒为 1。
在 R 中,model.frame() 先按照公式寻找变量、执行公式中的变换并确定实际参加分析的观测;model.response() 从中取出响应;model.matrix() 再把截距、连续变量、因子和交互项展开成数值矩阵。下面的小数据用于观察这个过程,不用于实质分析。
toy <- data.frame(
  consumption = c(5.1, 6.4, 5.8, 7.2, 6.7, 8.1, 7.5, 8.8),
  income = c(6.0, 8.2, 7.1, 9.5, 8.7, 11.0, 10.2, 12.4),
  household_size = c(2, 3, 2, 4, 3, 4, 3, 5),
  region = factor(
    c("urban", "town", "rural", "urban",
      "town", "rural", "urban", "town"),
    levels = c("urban", "town", "rural")
  )
)
contrasts(toy$region) <- contr.treatment(levels(toy$region), base = 1)

toy_formula <- consumption ~ income + household_size + region
toy_frame <- model.frame(toy_formula, data = toy)
toy_y <- model.response(toy_frame)
toy_X <- model.matrix(toy_formula, data = toy_frame)

knitr::kable(
  cbind(consumption = toy_y, toy_X),
  row.names = FALSE,
  digits = 1
)| consumption | (Intercept) | income | household_size | regiontown | regionrural |
|---|---|---|---|---|---|
| 5.1 | 1 | 6.0 | 2 | 0 | 0 |
| 6.4 | 1 | 8.2 | 3 | 1 | 0 |
| 5.8 | 1 | 7.1 | 2 | 0 | 1 |
| 7.2 | 1 | 9.5 | 4 | 0 | 0 |
| 6.7 | 1 | 8.7 | 3 | 1 | 0 |
| 8.1 | 1 | 11.0 | 4 | 0 | 1 |
| 7.5 | 1 | 10.2 | 3 | 0 | 0 |
| 8.8 | 1 | 12.4 | 5 | 1 | 0 |
第一列 (Intercept) 是截距。代码显式采用 treatment contrasts;region 有三个水平,但只生成两列虚拟变量,预先放在第一个水平的 urban 是基准组。于是 regiontown 的系数表示在其他变量相同的条件下,town 相对于 urban的差异。改变因子水平的顺序会改变系数的参数化方式,但不会改变同一个模型空间中的拟合值。
公式中的操作也会改变矩阵。y ~ x - 1 删除截距,y ~ x1 * x2 展开为主效应和交互项,y ~ poly(x, 2) 生成多项式基。研究者应检查生成后的列名,而不能只凭公式表面的写法猜测软件拟合了什么模型。预测新数据时还必须沿用训练数据的因子水平和对比编码;通常让 predict() 根据原拟合对象处理,比重新手工建立一套虚拟变量可靠。
12.1.2 维数、秩与可估性
若 \(\mathbf X\) 有 \(p\) 列,首先要问的不是能否调用求解函数,而是它的数值秩 \(r\) 是否等于 \(p\)。满列秩意味着各列不存在精确线性关系;若 \(r<p\),至少有一个系数不能由数据唯一确定。例如,同时放入income 和它的十倍会产生完全相同的信息。
toy_alias <- transform(toy, income_times_10 = 10 * income)
X_alias <- model.matrix(
  ~ income + income_times_10 + household_size + region,
  data = toy_alias
)
fit_alias <- lm(
  consumption ~ income + income_times_10 + household_size + region,
  data = toy_alias
)

alias_summary <- data.frame(
  matrix_columns = ncol(X_alias),
  numerical_rank = qr(X_alias)$rank,
  nonestimable_coefficient = paste(
    names(coef(fit_alias))[is.na(coef(fit_alias))],
    collapse = ", "
  )
)
knitr::kable(
  alias_summary,
  row.names = FALSE,
  col.names = c("设计矩阵列数", "数值秩", "不可估系数")
)| 设计矩阵列数 | 数值秩 | 不可估系数 |
|---|---|---|
| 6 | 5 | income_times_10 |
R 用 NA 标出被判定为不可估的系数。这不是缺失数据,而是参数化不唯一。秩亏时,不同系数向量可能产生相同的 \(\mathbf X\boldsymbol\beta\);软件必须选择一种表示,研究者则应查明线性依赖来自重复变量、全套虚拟变量与截距并存,还是某些类别在分析样本中根本没有观测。
满秩也不等于计算稳定。若某些列只是“几乎”线性相关,矩阵仍可逆,但系数会对数据中的小扰动非常敏感。中心化和标准化可以缓解量纲差异,却不能消除变量之间真正的近线性关系。秩、条件数和变量定义需要一起检查。
12.2 线性模型的计算
12.2.1 从最小二乘准则到正规方程
令 \(\mathbf Y=(Y_1,\ldots,Y_n)^\top\) 为随机响应向量,\(\boldsymbol\beta\in\mathbb R^p\) 为参数向量,并令\(\boldsymbol\varepsilon=(\varepsilon_1,\ldots,\varepsilon_n)^\top\) 为误差向量。线性均值模型写作
\[ \mathbf Y=\mathbf X\boldsymbol\beta+\boldsymbol\varepsilon. \]
观测到 \(\mathbf y\) 后,普通最小二乘估计使残差平方和
\[ S(\boldsymbol\beta) =(\mathbf y-\mathbf X\boldsymbol\beta)^\top (\mathbf y-\mathbf X\boldsymbol\beta) \]
最小。对 \(\boldsymbol\beta\) 求梯度,得到
\[ \nabla S(\boldsymbol\beta) =-2\mathbf X^\top(\mathbf y-\mathbf X\boldsymbol\beta). \]
令梯度为零便得到正规方程
\[ \mathbf X^\top\mathbf X\widehat{\boldsymbol\beta} =\mathbf X^\top\mathbf y. \]
因此,最小二乘残差 \(\widehat{\mathbf e}=\mathbf y-\mathbf X\widehat{\boldsymbol\beta}\) 满足
\[ \mathbf X^\top\widehat{\mathbf e}=\mathbf 0. \]
这个正交条件既是几何结论,也是很有用的计算核对:若一个求解结果连正规方程残差都不小,就不能认为最小二乘问题已经解好。需要特别区分,最小二乘点估计本身不要求误差服从正态分布;若\(\boldsymbol\varepsilon\mid\mathbf X\sim N_n(\mathbf 0,\sigma^2\mathbf I_n)\),最小二乘才同时是相应 Gaussian 模型的极大似然估计,并支持常见的精确小样本推断。
12.2.2 QR 分解与数值稳定性
在满列秩情形,常见的教科书公式是
\[ \widehat{\boldsymbol\beta} =(\mathbf X^\top\mathbf X)^{-1}\mathbf X^\top\mathbf y. \]
它适合推导,不适合照字面实现。显式形成逆矩阵会做不必要的计算;即使改用solve(crossprod(X), crossprod(X, y)) 解正规方程,形成 \(\mathbf X^\top\mathbf X\) 仍会放大病态性,因为在二范数下通常有
\[ \kappa_2(\mathbf X^\top\mathbf X)=\kappa_2(\mathbf X)^2. \]
若薄 QR 分解为
\[ \mathbf X=\mathbf Q\mathbf R, \qquad \mathbf Q^\top\mathbf Q=\mathbf I_p, \]
其中 \(\mathbf Q\in\mathbb R^{n\times p}\) 的列标准正交,\(\mathbf R\in\mathbb R^{p\times p}\) 为上三角矩阵。此时最小二乘问题等价于解上三角方程
\[ \mathbf R\widehat{\boldsymbol\beta}=\mathbf Q^\top\mathbf y. \]
实际程序常使用列主元,即对重排后的矩阵 \(\mathbf X\mathbf P=\mathbf Q\mathbf R\) 做分解。主元顺序帮助程序识别很小或相互依赖的方向,求解后再把系数恢复到原变量次序。lm()、lm.fit() 和qr.coef() 都利用了这类计算,而不是先构造 \((\mathbf X^\top\mathbf X)^{-1}\)。
12.2.3 系数、标准误和杠杆值怎样从 QR 得到
在线性模型的设计矩阵满列秩且满足同方差条件\(\operatorname{Var}(\boldsymbol\varepsilon\mid\mathbf X)=\sigma^2\mathbf I_n\)时,令 \(r=\operatorname{rank}(\mathbf X)\),则
\[ \hat\sigma^2=\frac{\widehat{\mathbf e}^\top\widehat{\mathbf e}}{n-r}, \qquad \widehat{\operatorname{Var}}(\widehat{\boldsymbol\beta}\mid\mathbf X) =\hat\sigma^2(\mathbf X^\top\mathbf X)^{-1}. \]
无列重排时,\(\mathbf X^\top\mathbf X=\mathbf R^\top\mathbf R\);使用列主元时则有\(\mathbf P^\top\mathbf X^\top\mathbf X\mathbf P=\mathbf R^\top\mathbf R\)。程序先在主元顺序下利用\(\mathbf R\) 计算协方差,再恢复原列顺序,无须显式对 \(\mathbf X^\top\mathbf X\) 求逆。若误差存在异方差或聚类相关,系数仍可由最小二乘算出,但协方差公式必须相应改变;“系数算出来了”和“标准误算对了”是两个问题。
拟合值是 \(\mathbf y\) 在 \(\mathbf X\) 列空间上的投影。满列秩时,投影矩阵及其对角元为
\[ \mathbf H=\mathbf Q\mathbf Q^\top, \qquad h_{ii}=\sum_{j=1}^{r}q_{ij}^2, \qquad \operatorname{tr}(\mathbf H)=r. \]
因此,只需对 \(\mathbf Q\) 的每一行平方求和就能得到全部杠杆值,不必显式构造可能很大的\(n\times n\) 矩阵 \(\mathbf H\)。
下面把一个线性模型的主要结果从 QR 分解中逐项算出,再与 lm() 核对。
set.seed(1201)
n_lm <- 150
lm_dat <- data.frame(
  x1 = rnorm(n_lm),
  x2 = runif(n_lm, -1, 1)
)
lm_dat$y <- 1.5 + 0.8 * lm_dat$x1 - 1.2 * lm_dat$x2 +
  rnorm(n_lm, sd = 0.6)

lm_formula <- y ~ x1 + x2
lm_frame <- model.frame(lm_formula, data = lm_dat)
y_lm <- model.response(lm_frame)
X_lm <- model.matrix(lm_formula, data = lm_frame)

qr_lm <- qr(X_lm)
rank_lm <- qr_lm$rank
if (rank_lm < ncol(X_lm)) {
  stop("本段协方差计算要求设计矩阵满列秩。")
}
beta_lm_qr <- qr.coef(qr_lm, y_lm)
fitted_lm_qr <- drop(X_lm %*% beta_lm_qr)
resid_lm_qr <- y_lm - fitted_lm_qr
rss_lm <- sum(resid_lm_qr^2)
df_resid_lm <- nrow(X_lm) - rank_lm
sigma2_lm <- rss_lm / df_resid_lm

# R 因子对应主元重排后的列,先在该顺序计算协方差,再还原列顺序。
active <- seq_len(rank_lm)
R_lm <- qr.R(qr_lm)[active, active, drop = FALSE]
vcov_pivoted <- sigma2_lm * chol2inv(R_lm)
vcov_lm_qr <- matrix(
  0,
  nrow = ncol(X_lm),
  ncol = ncol(X_lm),
  dimnames = list(colnames(X_lm), colnames(X_lm))
)
pivot_active <- qr_lm$pivot[active]
vcov_lm_qr[pivot_active, pivot_active] <- vcov_pivoted
se_lm_qr <- sqrt(diag(vcov_lm_qr))

Q_lm <- qr.Q(qr_lm, complete = FALSE)[, active, drop = FALSE]
leverage_lm_qr <- rowSums(Q_lm^2)

fit_lm_software <- lm(lm_formula, data = lm_dat)
lm_coefficient_check <- data.frame(
  term = names(beta_lm_qr),
  qr_estimate = unname(beta_lm_qr),
  lm_estimate = unname(coef(fit_lm_software)),
  qr_standard_error = unname(se_lm_qr),
  lm_standard_error = unname(coef(summary(fit_lm_software))[, 2])
)
knitr::kable(
  lm_coefficient_check,
  row.names = FALSE,
  digits = 6,
  col.names = c("参数", "QR 估计", "lm() 估计", "QR 标准误", "lm() 标准误")
)| 参数 | QR 估计 | lm() 估计 | QR 标准误 | lm() 标准误 |
|---|---|---|---|---|
| (Intercept) | 1.4345 | 1.4345 | 0.05136 | 0.05136 |
| x1 | 0.7483 | 0.7483 | 0.05540 | 0.05540 |
| x2 | -1.2606 | -1.2606 | 0.08477 | 0.08477 |
stopifnot(
  max(abs(beta_lm_qr - coef(fit_lm_software))) < 1e-10,
  max(abs(se_lm_qr - coef(summary(fit_lm_software))[, 2])) < 1e-10,
  max(abs(vcov_lm_qr - vcov(fit_lm_software))) < 1e-10,
  max(abs(leverage_lm_qr - hatvalues(fit_lm_software))) < 1e-10
)
系数和标准误的两种计算在舍入误差范围内一致。QR 分解还同时给出若干核对量。
lm_qr_checks <- data.frame(
  quantity = c(
    "数值秩",
    "残差自由度",
    "残差标准差",
    "max |X' e|",
    "杠杆值之和"
  ),
  value = c(
    rank_lm,
    df_resid_lm,
    sqrt(sigma2_lm),
    max(abs(crossprod(X_lm, resid_lm_qr))),
    sum(leverage_lm_qr)
  )
)
knitr::kable(
  lm_qr_checks,
  row.names = FALSE,
  digits = 8,
  col.names = c("诊断量", "数值")
)| 诊断量 | 数值 |
|---|---|
| 数值秩 | 3.0000 |
| 残差自由度 | 147.0000 |
| 残差标准差 | 0.6267 |
| max |X’ e| | 0.0000 |
| 杠杆值之和 | 3.0000 |
max |X' residual| 应接近 0,说明残差满足正规方程;杠杆值之和应接近模型秩 \(r\)。这两个恒等式把统计定义、矩阵分解和程序输出连接起来,也为手写实现提供了独立核对。
12.2.4 近共线性与系数敏感性
下面令两个解释变量几乎相同。为了把“算法误差”和“数据无法区分两个效应”分开,代码同时比较正规方程与 QR,并给响应加上一个幅度极小、方向恰好对准弱识别方向的扰动。
set.seed(1202)
n_collinear <- 250
x_a <- rnorm(n_collinear)
x_b <- x_a + rnorm(n_collinear, sd = 1e-5)
y_collinear <- 1 + 2 * x_a + rnorm(n_collinear, sd = 0.2)
X_collinear <- cbind(`(Intercept)` = 1, x_a = x_a, x_b = x_b)

beta_qr <- qr.coef(qr(X_collinear), y_collinear)
beta_normal <- tryCatch(
  drop(solve(
    crossprod(X_collinear),
    crossprod(X_collinear, y_collinear)
  )),
  error = function(e) rep(NA_real_, ncol(X_collinear))
)
names(beta_normal) <- colnames(X_collinear)

weak_direction <- x_b - x_a
delta_y <- 1e-6 * weak_direction / sd(weak_direction)
y_perturbed <- y_collinear + delta_y
beta_perturbed <- qr.coef(qr(X_collinear), y_perturbed)

collinearity_checks <- data.frame(
  quantity = c(
    "kappa(X)",
    "kappa(X'X)",
    "正规方程与 QR 的最大系数差",
    "响应的最大扰动",
    "扰动后的最大系数变化",
    "扰动后的最大拟合值变化"
  ),
  value = c(
    kappa(X_collinear, exact = TRUE),
    kappa(crossprod(X_collinear), exact = TRUE),
    max(abs(beta_normal - beta_qr)),
    max(abs(delta_y)),
    max(abs(beta_perturbed - beta_qr)),
    max(abs(drop(X_collinear %*% (beta_perturbed - beta_qr))))
  )
)
knitr::kable(
  collinearity_checks,
  row.names = FALSE,
  digits = 7,
  col.names = c("诊断量", "数值")
)| 诊断量 | 数值 |
|---|---|
| kappa(X) | 2.011e+05 |
| kappa(X’X) | 4.042e+10 |
| 正规方程与 QR 的最大系数差 | 1.878e-03 |
| 响应的最大扰动 | 2.900e-06 |
| 扰动后的最大系数变化 | 9.839e-02 |
| 扰动后的最大拟合值变化 | 2.900e-06 |
coefficient_sensitivity <- data.frame(
  term = names(beta_qr),
  original = unname(beta_qr),
  perturbed_response = unname(beta_perturbed),
  change = unname(beta_perturbed - beta_qr)
)
knitr::kable(
  coefficient_sensitivity,
  row.names = FALSE,
  digits = 5,
  col.names = c(
    "参数", "原系数估计", "扰动响应后的系数估计", "系数变化"
  )
)| 参数 | 原系数估计 | 扰动响应后的系数估计 | 系数变化 |
|---|---|---|---|
| (Intercept) | 1.003 | 1.003 | 0.00000 |
| x_a | -1031.335 | -1031.434 | -0.09839 |
| x_b | 1033.342 | 1033.441 | 0.09839 |
\(\kappa(\mathbf X^\top\mathbf X)\) 大约是 \(\kappa(\mathbf X)\) 的平方。正规方程和 QR 在这一次计算中可能仍给出相近答案,这并不能证明形成正规方程是安全的;条件数描述的是最坏方向上的误差放大潜力。更重要的是,几乎不改变拟合值的小扰动可以明显改变两个单独系数,而且变化方向相反。数据能够较稳定地确定二者的某个组合,却不能稳定地区分各自贡献。这是统计识别问题,换一个线性代数例程不能替代重新定义变量或研究问题。
12.2.5 条件均值区间与新观测预测区间
给定新解释变量向量 \(\mathbf x_0\),条件均值拟合值为\(\hat m_0=\mathbf x_0^\top\widehat{\boldsymbol\beta}\)。在同一个满列秩、同方差线性模型下,均值估计方差与新观测预测误差方差分别为
\[ \widehat{\operatorname{Var}}(\hat m_0) =\hat\sigma^2\mathbf x_0^\top (\mathbf X^\top\mathbf X)^{-1}\mathbf x_0, \]
\[ \widehat{\operatorname{Var}}(Y_0-\hat m_0) =\hat\sigma^2\left\{1+ \mathbf x_0^\top(\mathbf X^\top\mathbf X)^{-1}\mathbf x_0\right\}. \]
第二式多出的 \(1\) 是新观测自身的随机波动。因此,条件均值置信区间和新观测预测区间不能互换。在置信水平 \(1-\alpha\) 下,相应的区间分别为
\[ \hat m_0\mathbin{\pm} t_{n-r,\,1-\alpha/2}\hat\sigma \left\{\mathbf x_0^\top (\mathbf X^\top\mathbf X)^{-1}\mathbf x_0\right\}^{1/2}, \]
以及
\[ \hat m_0\mathbin{\pm} t_{n-r,\,1-\alpha/2}\hat\sigma \left\{1+\mathbf x_0^\top (\mathbf X^\top\mathbf X)^{-1}\mathbf x_0\right\}^{1/2}. \]
前者针对同一 \(\mathbf x_0\) 下的条件均值,后者针对一个新的随机响应 \(Y_0\)。在独立同方差正态误差下,它们是经典的精确 \(t\) 区间;离开正态条件后,通常只能结合大样本理论或其他协方差估计作近似解释。
12.3 加权最小二乘:通向 IRLS 的桥梁
12.3.1 固定权重的最小二乘变换
给定正权重 \(w_1,\ldots,w_n\),加权最小二乘最小化
\[ S_{\mathbf W}(\boldsymbol\beta) =\sum_{i=1}^n w_i(y_i-\mathbf x_i^\top\boldsymbol\beta)^2 =(\mathbf y-\mathbf X\boldsymbol\beta)^\top \mathbf W(\mathbf y-\mathbf X\boldsymbol\beta), \]
其中 \(\mathbf W=\operatorname{diag}(w_1,\ldots,w_n)\)。令
\[ \widetilde{\mathbf X}=\mathbf W^{1/2}\mathbf X, \qquad \widetilde{\mathbf y}=\mathbf W^{1/2}\mathbf y, \]
便得到一个普通最小二乘问题。因此仍可对 \(\widetilde{\mathbf X}\) 做 QR 分解,而不必构造\(\mathbf X^\top\mathbf W\mathbf X\)。
w_lm <- seq(0.5, 2, length.out = nrow(X_lm))
sqrt_w_lm <- sqrt(w_lm)
X_lm_weighted <- sweep(X_lm, 1, sqrt_w_lm, `*`)
y_lm_weighted <- sqrt_w_lm * y_lm

beta_wls_qr <- qr.coef(qr(X_lm_weighted), y_lm_weighted)
beta_wls_r <- lm.wfit(X_lm, y_lm, w = w_lm)$coefficients

wls_check <- data.frame(
  term = names(beta_wls_qr),
  transformed_qr = unname(beta_wls_qr),
  lm_wfit = unname(beta_wls_r),
  difference = unname(beta_wls_qr - beta_wls_r)
)
knitr::kable(
  wls_check,
  row.names = FALSE,
  digits = 10,
  col.names = c("参数", "变换后 QR", "lm.wfit()", "差值")
)| 参数 | 变换后 QR | lm.wfit() | 差值 |
|---|---|---|---|
| (Intercept) | 1.4138 | 1.4138 | 0 |
| x1 | 0.7416 | 0.7416 | 0 |
| x2 | -1.2811 | -1.2811 | 0 |
12.3.2 权重的统计含义
若线性模型满足
\[ \operatorname{E}(\boldsymbol\varepsilon\mid\mathbf X)=\mathbf 0, \qquad \operatorname{Var}(\boldsymbol\varepsilon\mid\mathbf X) =\sigma^2\mathbf W^{-1}, \]
其中 \(\mathbf W\) 是正对角矩阵,则各误差条件不相关,\(w_i\) 是相对精度,变换后的误差\(\sqrt{w_i}\varepsilon_i\) 具有共同方差 \(\sigma^2\)。当 \(\mathbf X\) 满列秩时,加权最小二乘系数的条件协方差为
\[ \operatorname{Var}(\widehat{\boldsymbol\beta}_{\mathrm{WLS}}\mid\mathbf X) =\sigma^2(\mathbf X^\top\mathbf W\mathbf X)^{-1}. \]
上面的代数仍没有替研究者说明权重来自哪里。精度权重、重复观测的频数权重和复杂抽样中的调查权重代表不同的数据生成或抽样机制,不能只因它们都写在 weights 参数中就作相同解释。下一节的 IRLS权重来自似然在当前参数处的局部曲率,还会随迭代改变;它既不是样本频数,也不是调查权重。
12.4 广义线性模型的似然计算
12.4.1 随机部分、线性预测子与连接函数
广义线性模型(generalized linear model,GLM)由三部分组成。随机部分规定 \(Y_i\) 的条件分布及方差函数;系统部分规定线性预测子\(\eta_i=\mathbf x_i^\top\boldsymbol\beta\);连接函数把条件均值\(\mu_i=\operatorname{E}(Y_i\mid\mathbf x_i)\) 与线性预测子连接起来:
\[ g(\mu_i)=\eta_i. \]
相应的线性预测子向量与均值向量分别记为\(\boldsymbol\eta=(\eta_1,\ldots,\eta_n)^\top\) 和\(\boldsymbol\mu=(\mu_1,\ldots,\mu_n)^\top\)。
常见模型可以统一写为
\[ \operatorname{Var}(Y_i\mid\mathbf x_i)=\phi V(\mu_i), \]
其中 \(V(\mu)\) 是方差函数,\(\phi\) 是离散度参数。
| 模型与连接 | \(\mu(\eta)\) | \(V(\mu)\) | \(d\mu/d\eta\) | IRLS 工作权重(略去公共因子) |
|---|---|---|---|---|
| Gaussian,恒等连接 | \(\eta\) | \(1\) | \(1\) | \(1\) |
| Bernoulli,logit 连接 | \(\{1+\exp(-\eta)\}^{-1}\) | \(\mu(1-\mu)\) | \(\mu(1-\mu)\) | \(\mu(1-\mu)\) |
| Poisson,对数连接 | \(\exp(\eta)\) | \(\mu\) | \(\mu\) | \(\mu\) |
Gaussian 模型的工作权重固定为 1,所以一步就得到普通最小二乘。Bernoulli 和 Poisson 的权重依赖未知均值,只能在当前参数处计算,再反复更新。
12.4.2 得分函数、Fisher 信息与局部二次近似
对 \(i=1,\ldots,n\),记 \(\mathbf D=\operatorname{diag}(d\mu_i/d\eta_i)\),\(\mathbf V=\operatorname{diag}\{V(\mu_i)\}\)。以下假定当前的\(\mathbf W^{1/2}\mathbf X\) 满列秩,因而 Fisher 信息非奇异。在常规 GLM 条件下,参数的得分函数(score)可以写为
\[ \mathbf U(\boldsymbol\beta) =\frac{1}{\phi}\mathbf X^\top \mathbf D\mathbf V^{-1}(\mathbf y-\boldsymbol\mu), \]
期望 Fisher 信息为
\[ \mathcal I(\boldsymbol\beta) =\frac{1}{\phi}\mathbf X^\top\mathbf W\mathbf X, \qquad \mathbf W=\operatorname{diag}\left\{ \frac{(d\mu_i/d\eta_i)^2}{V(\mu_i)} \right\}. \]
第 6 章介绍的 Fisher scoring 更新为
\[ \boldsymbol\beta^{(t+1)} =\boldsymbol\beta^{(t)}+ \left[\mathcal I\{\boldsymbol\beta^{(t)}\}\right]^{-1} \mathbf U\{\boldsymbol\beta^{(t)}\}. \]
公共因子 \(1/\phi\) 在系数更新中抵消。把更新式整理后,定义工作响应
\[ z_i^{(t)} =\eta_i^{(t)}+ \frac{y_i-\mu_i^{(t)}}{d\mu_i^{(t)}/d\eta_i}, \]
便得到
\[ \boldsymbol\beta^{(t+1)} =\arg\min_{\boldsymbol\beta} \sum_{i=1}^n w_i^{(t)} \left(z_i^{(t)}-\mathbf x_i^\top\boldsymbol\beta\right)^2. \]
该加权最小二乘问题的正规方程正是
\[ \mathbf X^\top\mathbf W^{(t)}\mathbf X \boldsymbol\beta^{(t+1)} =\mathbf X^\top\mathbf W^{(t)}\mathbf z^{(t)}. \]
这就是迭代加权最小二乘(iteratively reweighted least squares,IRLS)。一次完整迭代可按下列顺序阅读:
- 给定初值 \(\boldsymbol\beta^{(0)}\),并检查它能否产生有限的线性预测子和均值;
- 由 \(\boldsymbol\beta^{(t)}\) 计算 \(\boldsymbol\eta^{(t)}\)、\(\boldsymbol\mu^{(t)}\) 以及方差函数;
- 构造工作响应 \(\mathbf z^{(t)}\) 和对角工作权重 \(\mathbf W^{(t)}\);
- 对 \(\{\mathbf W^{(t)}\}^{1/2}\mathbf X\) 做 QR 分解,解出\(\boldsymbol\beta^{(t+1)}\);
- 检查参数变化、目标函数和得分函数;若未达到容差,就返回第 2 步。
每一步都做一次加权最小二乘,但 \(z_i^{(t)}\) 和 \(w_i^{(t)}\) 会随当前参数变化。工作响应只是局部二次近似产生的计算量,不能当作一组新的真实观测。
12.4.3 Logistic 与 Poisson 的具体形式
对 Bernoulli Logistic 回归,令\(p_i=\operatorname{logit}^{-1}(\eta_i)\),并记\(\mathbf p=(p_1,\ldots,p_n)^\top\)。忽略与参数无关的常数,对数似然为
\[ \ell(\boldsymbol\beta) =\sum_{i=1}^n\left[y_i\eta_i-\log\{1+\exp(\eta_i)\}\right]. \]
饱和模型为每个观测提供足够的参数,能够逐点重现观测均值。Deviance(偏差统计量)是当前模型与饱和模型的两倍对数似然差:
\[ D(\boldsymbol\beta) =2\{\ell_{\mathrm{sat}}-\ell(\boldsymbol\beta)\}. \]
对逐个记录为 0 或 1 的 Bernoulli 数据,采用 \(0\log 0=0\) 的约定后,饱和模型对数似然为 0,因而
\[ D(\boldsymbol\beta) =2\sum_{i=1}^n \left[\log\{1+\exp(\eta_i)\}-y_i\eta_i\right]. \]
这正是后面程序记录的数值。它随迭代稳定可作为计算证据,但 deviance 小到什么程度才算拟合良好,还要结合自由度、模型比较和残差结构判断。
其得分函数和 Hessian 矩阵为
\[ \mathbf U(\boldsymbol\beta)=\mathbf X^\top(\mathbf y-\mathbf p), \qquad \nabla^2\ell(\boldsymbol\beta)=-\mathbf X^\top\mathbf W\mathbf X, \]
其中 \(w_i=p_i(1-p_i)\)。在这里,负 Hessian 矩阵恰好等于 Fisher 信息,因此 Fisher scoring 与Newton 更新相同,并可写成
\[ z_i=\eta_i+\frac{y_i-p_i}{p_i(1-p_i)}, \qquad w_i=p_i(1-p_i). \]
程序中应使用 plogis(eta),而不是直接计算exp(eta) / (1 + exp(eta));后者在很大的正数处可能先发生溢出。类似地,计算\(\log\{1+\exp(\eta)\}\) 时可以使用\(\max(\eta,0)+\log\{1+\exp(-|\eta|)\}\)。
对 Poisson 对数连接模型,\(\mu_i=\exp(\eta_i)\),忽略 \(\log(y_i!)\) 后有
\[ \ell(\boldsymbol\beta)=\sum_{i=1}^n(y_i\eta_i-\exp\eta_i), \]
\[ \mathbf U(\boldsymbol\beta)=\mathbf X^\top(\mathbf y-\boldsymbol\mu), \qquad \nabla^2\ell(\boldsymbol\beta)=-\mathbf X^\top \operatorname{diag}(\boldsymbol\mu)\mathbf X. \]
相应的工作量为
\[ z_i=\eta_i+\frac{y_i-\mu_i}{\mu_i}, \qquad w_i=\mu_i. \]
因此,后面共享单车案例中的 Poisson 回归并不是一个与线性代数无关的“黑箱”:每次迭代仍然在对\(\sqrt{\mu_i}\mathbf x_i\) 和 \(\sqrt{\mu_i}z_i\) 做 QR 求解。
12.5 手写并核对 IRLS
12.5.1 Logistic IRLS 的核心实现
下面的函数保留算法真正需要检查的量:是否收敛、迭代次数、deviance、参数相对变化、尺度化 score、最大系数和最小工作权重。它只用于展示无惩罚、无抽样权重的 Bernoulli Logistic 回归,不替代软件中更完整的边界处理。
log1pexp <- function(x) {
  pmax(x, 0) + log1p(exp(-abs(x)))
}

logit_irls <- function(X, y, tol = 1e-8, maxit = 50L,
                       probability_floor = 1e-10) {
  X <- as.matrix(X)
  y <- as.numeric(y)

  if (nrow(X) != length(y)) {
    stop("X 的行数必须等于 y 的长度。")
  }
  if (any(!is.finite(X)) || any(!is.finite(y))) {
    stop("X 和 y 不能含有缺失值或非有限值。")
  }
  if (!all(y %in% c(0, 1))) {
    stop("这个函数只接受取值为 0 或 1 的响应。")
  }
  if (length(maxit) != 1L || !is.finite(maxit) || maxit < 1) {
    stop("maxit 必须是正数。")
  }
  maxit <- as.integer(maxit)
  if (length(tol) != 1L || !is.finite(tol) || tol <= 0) {
    stop("tol 必须是正数。")
  }
  if (length(probability_floor) != 1L ||
      !is.finite(probability_floor) ||
      probability_floor <= 0 || probability_floor >= 0.5) {
    stop("probability_floor 必须位于 0 与 0.5 之间。")
  }
  if (qr(X)$rank < ncol(X)) {
    stop("设计矩阵秩亏;应先处理不可估参数。")
  }

  beta <- setNames(numeric(ncol(X)), colnames(X))
  trace <- matrix(
    NA_real_, nrow = maxit, ncol = 6,
    dimnames = list(
      NULL,
      c(
        "iteration", "deviance", "relative_change",
        "max_scaled_score", "max_abs_coefficient",
        "min_working_weight"
      )
    )
  )
  converged <- FALSE
  boundary <- FALSE
  score_scale <- 1 + colSums(abs(X))

  for (iter in seq_len(maxit)) {
    eta <- drop(X %*% beta)
    p_raw <- plogis(eta)
    boundary <- boundary ||
      any(p_raw <= probability_floor | p_raw >= 1 - probability_floor)

    # 截断只用于避免在有限精度下除以 0,不是分离问题的修复方法。
    p <- pmin(pmax(p_raw, probability_floor), 1 - probability_floor)
    w <- p * (1 - p)
    z <- eta + (y - p) / w

    sqrt_w <- sqrt(w)
    X_weighted <- sweep(X, 1, sqrt_w, `*`)
    qr_weighted <- qr(X_weighted)
    if (qr_weighted$rank < ncol(X)) {
      stop("加权设计矩阵在迭代中失秩。")
    }

    beta_new <- qr.coef(qr_weighted, sqrt_w * z)
    if (any(!is.finite(beta_new))) {
      stop("IRLS 产生了非有限系数。")
    }

    eta_new <- drop(X %*% beta_new)
    p_new <- plogis(eta_new)
    p_new_safe <- pmin(
      pmax(p_new, probability_floor),
      1 - probability_floor
    )
    boundary <- boundary ||
      any(p_new <= probability_floor | p_new >= 1 - probability_floor)
    score_new <- drop(crossprod(X, y - p_new))
    relative_change <- max(abs(beta_new - beta) / (1 + abs(beta)))
    max_scaled_score <- max(abs(score_new) / score_scale)

    trace[iter, ] <- c(
      iter,
      2 * sum(log1pexp(eta_new) - y * eta_new),
      relative_change,
      max_scaled_score,
      max(abs(beta_new)),
      min(p_new_safe * (1 - p_new_safe))
    )

    # 必须先保存新系数,再判断是否退出。
    beta <- beta_new
    if (relative_change < tol && max_scaled_score < tol) {
      converged <- TRUE
      break
    }
  }

  eta <- drop(X %*% beta)
  fitted <- plogis(eta)
  final_p <- pmin(
    pmax(fitted, probability_floor),
    1 - probability_floor
  )

  list(
    coefficients = beta,
    fitted.values = fitted,
    working.weights = final_p * (1 - final_p),
    converged = converged,
    boundary = boundary,
    iterations = iter,
    trace = as.data.frame(trace[seq_len(iter), , drop = FALSE])
  )
}
函数中的尺度化 score 定义为
\[ \max_{1\leq j\leq p} \frac{|U_j|}{1+\sum_{i=1}^n|x_{ij}|}. \]
分母用于减弱样本量和设计矩阵列尺度对绝对 score 的影响。它不是一个通用拟合优度指标;报告时必须同时给出尺度化定义,只宜用于判断同一估计方程是否已接近零点。
12.5.2 与 glm() 的数值核对
模拟数据中的 log_income_z 是标准化后的对数收入,不是可能取负值的原始收入。设计矩阵仍由模型公式生成,手写函数与 glm() 接收完全相同的 \(\mathbf X\) 和 \(\mathbf y\)。
set.seed(1203)
n_credit <- 400
credit <- data.frame(
  log_income_z = as.numeric(scale(rnorm(n_credit, mean = 2, sd = 0.55))),
  debt_ratio_z = rnorm(n_credit)
)
eta_credit <- -1.2 - 0.9 * credit$log_income_z +
  0.8 * credit$debt_ratio_z
credit$default <- rbinom(n_credit, size = 1, prob = plogis(eta_credit))

credit_formula <- default ~ log_income_z + debt_ratio_z
credit_frame <- model.frame(credit_formula, data = credit)
X_credit <- model.matrix(credit_formula, data = credit_frame)
y_credit <- model.response(credit_frame)

fit_credit_manual <- logit_irls(X_credit, y_credit)
fit_credit_glm <- glm(
  credit_formula,
  data = credit,
  family = binomial(link = "logit")
)

irls_coefficient_check <- data.frame(
  term = names(coef(fit_credit_glm)),
  manual_irls = unname(fit_credit_manual$coefficients),
  glm = unname(coef(fit_credit_glm)),
  difference = unname(
    fit_credit_manual$coefficients - coef(fit_credit_glm)
  )
)
knitr::kable(
  irls_coefficient_check,
  row.names = FALSE,
  digits = 10,
  col.names = c("参数", "手写 IRLS", "glm()", "差值")
)| 参数 | 手写 IRLS | glm() | 差值 |
|---|---|---|---|
| (Intercept) | -1.2873 | -1.2873 | 0 |
| log_income_z | -0.8681 | -0.8681 | 0 |
| debt_ratio_z | 0.9831 | 0.9831 | 0 |
12.5.3 迭代轨迹的阅读
knitr::kable(
  fit_credit_manual$trace,
  row.names = FALSE,
  digits = c(0, 6, 9, 9, 6, 9),
  col.names = c(
    "迭代", "deviance", "参数相对变化", "最大尺度化 score",
    "最大系数绝对值", "最小工作权重"
  )
)| 迭代 | deviance | 参数相对变化 | 最大尺度化 score | 最大系数绝对值 | 最小工作权重 |
|---|---|---|---|---|---|
| 1 | 392.9 | 9.059e-01 | 4.246e-02 | 0.9059 | 0.041189 |
| 2 | 380.1 | 1.749e-01 | 8.047e-03 | 1.1998 | 0.011935 |
| 3 | 379.5 | 4.258e-02 | 4.618e-04 | 1.2820 | 0.008355 |
| 4 | 379.5 | 2.622e-03 | 1.735e-06 | 1.2873 | 0.008167 |
| 5 | 379.5 | 9.858e-06 | 0.000e+00 | 1.2873 | 0.008166 |
| 6 | 379.5 | 0.000e+00 | 0.000e+00 | 1.2873 | 0.008166 |
迭代轨迹至少回答三个不同的问题。偏差统计量(deviance)是否已经稳定,参数更新是否已经很小,score 是否接近零。三者都支持“当前方程已被数值求解”的判断;它们不支持“连接函数正确”或“模型具有良好预测能力”这样的统计结论。
12.5.4 IRLS 的异常与失败模式
IRLS 失败并不只有一种原因。
秩亏或严重病态。 原始 \(\mathbf X\) 满秩并不能保证每轮的\(\mathbf W^{1/2}\mathbf X\) 都稳定。当某些工作权重很小时,有效信息会集中在少量观测上。此时应检查加权设计矩阵的秩和条件数,而不只是增加最大迭代次数。
完全分离。 在 Logistic 回归中,若某个超平面能把 \(y=0\) 与 \(y=1\) 完全分开,无惩罚似然可能没有有限最大值。迭代过程中系数绝对值不断增大,拟合概率逼近 0 或 1,工作权重趋近 0。程序中的概率截断只能避免除以零,不能创造一个不存在的有限极大似然估计。应重新检查数据编码、样本结构和模型设定,或采用有明确统计依据的惩罚、偏差修正方法。第 14 章将讨论正则化。
步长过大或数值溢出。 Poisson 模型中的 exp(eta) 可能溢出;不同量纲也会使一次 Newton 步跨得太远。成熟实现会结合稳定的函数计算、步长缩减和 deviance 检查。标准化可以改善尺度,却不能修复秩亏或完全分离。
停止条件过于单一。 仅看相邻两次系数之差可能在平坦方向上误判。实际报告应同时记录目标函数或deviance、尺度化 score、迭代次数和边界现象,并说明容差。不同软件的默认容差不同,最后一位数字不必完全相同,但关键统计量应在合理精度内一致。
12.6 从信息矩阵到标准误和诊断量
12.6.1 GLM 标准误仍来自加权设计矩阵
在收敛点附近,若 \(\widehat{\mathbf W}^{1/2}\mathbf X\) 满列秩,GLM 系数的协方差通常用 Fisher信息的逆近似:
\[ \widehat{\operatorname{Var}}(\widehat{\boldsymbol\beta}) \approx \hat\phi(\mathbf X^\top\widehat{\mathbf W}\mathbf X)^{-1}. \]
计算时仍可对 \(\widehat{\mathbf W}^{1/2}\mathbf X\) 做 QR 分解,再利用其三角因子,而不必显式求逆。Bernoulli 和标准 Poisson 似然固定 \(\phi=1\);准 Poisson 根据残差估计 \(\phi\)。因此,同一组工作权重既决定最后一步系数更新,也决定局部曲率、标准误和加权杠杆值。
加权投影矩阵为
\[ \mathbf H_{\mathbf W} =\mathbf W^{1/2}\mathbf X (\mathbf X^\top\mathbf W\mathbf X)^{-1} \mathbf X^\top\mathbf W^{1/2}. \]
它的对角元衡量某个观测在当前局部加权问题中的杠杆。GLM 的权重依赖拟合均值,所以高杠杆不只来自解释变量位置,还与模型在该处提供多少局部信息有关。
12.6.2 计算诊断与模型诊断
下面两组问题应分开回答。
| 诊断层次 | 主要计算量 | 回答的问题 |
|---|---|---|
| 计算诊断 | \(\operatorname{rank}(\mathbf X)\)、\(\kappa(\mathbf X)\) 或 \(\kappa(\mathbf W^{1/2}\mathbf X)\) | 参数方向能否稳定求解 |
| 计算诊断 | 收敛标志、迭代次数、deviance 变化、score 范数 | 估计方程是否已被数值求解 |
| 计算诊断 | 最小工作权重、边界拟合值、非有限数 | 是否出现分离、溢出或信息退化 |
| 模型诊断 | 残差形态、均值—方差关系、非线性 | 均值和方差结构是否合理 |
| 模型诊断 | 杠杆值、Cook 距离、逐点拟合变化 | 结论是否由少数观测主导 |
| 模型诊断 | 残差随时间、群组或空间的相关 | 独立性假设是否可信 |
| 预测诊断 | 独立测试集或交叉验证损失 | 模型对未见数据的表现如何 |
模型成功返回系数,只能说明程序完成了某个计算路径;即使 score 很小,也不能证明分布假设正确。预测诊断将在第 13 章系统讨论。
12.6.3 残差与过度离散
GLM 没有唯一的“残差”。响应残差 \(y_i-\hat\mu_i\) 保留原单位;Pearson 残差为
\[ r_i^{\mathrm{P}}=\frac{y_i-\hat\mu_i}{\sqrt{V(\hat\mu_i)}}, \]
它直接用于检查均值—方差关系。常见的 Pearson 离散度估计为
\[ \hat\phi_{\mathrm{P}} =\frac{1}{n-r}\sum_{i=1}^n(r_i^{\mathrm{P}})^2. \]
Poisson 模型规定 \(V(\mu)=\mu\) 和 \(\phi=1\)。若 \(\hat\phi_{\mathrm{P}}\) 远大于 1,数据相对于该均值结构表现出过度离散。准 Poisson 保留\(\operatorname{E}(Y_i\mid\mathbf x_i)=\mu_i\) 和对数连接,但改用
\[ \operatorname{Var}(Y_i\mid\mathbf x_i)=\phi\mu_i. \]
当均值公式、连接函数和先验权重相同时,Poisson 与准 Poisson 的估计方程只差一个公共尺度因子,因而系数和拟合均值相同;准 Poisson 主要用 \(\hat\phi\) 调整协方差,标准误约乘以 \(\sqrt{\hat\phi}\)。
准 Poisson 是均值—方差设定,不是完整概率似然。因此不应对它使用普通 AIC 或似然比检验,也不能由它直接得到一个完整的新计数预测分布。更重要的是,放大方差尺度不会自动修复遗漏非线性、零膨胀、时间相关或群组相关。过度离散是继续诊断的信号,不是病因的名称。
12.7 案例:共享单车日租赁量
12.7.1 数据、研究问题与固定编码
UCI Bike Sharing 数据记录了 Capital Bikeshare 系统在 2011–2012 年的小时和日租赁量,并附有天气、季节和日历变量 (Fanaee-T 2013; Fanaee-T and Gama 2014)。本节使用其中 731 个连续日期的日度数据。目标是展示从设计矩阵到估计、标准误、诊断和预测目标的完整计算过程,而不是建立最终的运营预测系统。
响应 cnt 是每天的总租赁次数。我们比较三种计算:对 log(cnt) 的线性模型、Poisson 对数连接模型,以及与 Poisson 使用相同条件均值的准 Poisson 模型。两类模型的估计对象并不相同:
\[ \text{对数响应线性模型:}\quad \operatorname{E}\{\log(Y_i)\mid\mathbf x_i\}=\mathbf x_i^\top\boldsymbol\beta, \]
\[ \text{Poisson 或准 Poisson:}\quad \log \operatorname{E}(Y_i\mid\mathbf x_i)=\mathbf x_i^\top\boldsymbol\beta. \]
期望与对数的次序不能交换。前一种模型要经过重转换才讨论原尺度均值,后一种模型通过连接函数直接规定原尺度条件均值。代码先验证原始编码,再用固定数值映射生成因子。season 采用 UCI 现行元数据中与日期换季点一致的编码(1=冬、2=春、3=夏、4=秋);压缩包内的旧版 Readme.txt 对此有冲突标注,所以代码明确记录本章采用的数据字典。固定映射还可以避免在数据子集中缺少某个类别时静默错贴标签。
bike_path <- "data/bike_sharing_day.csv"
if (!file.exists(bike_path)) {
  stop("找不到共享单车日度数据文件。")
}

bike <- read.csv(bike_path, stringsAsFactors = FALSE)
required_bike_variables <- c(
  "dteday", "season", "yr", "workingday", "weathersit",
  "temp", "hum", "windspeed", "cnt"
)
if (!all(required_bike_variables %in% names(bike))) {
  stop("共享单车数据缺少本节所需变量。")
}
if (anyNA(bike[required_bike_variables]) || any(bike$cnt <= 0)) {
  stop("本节要求所用变量完整,且 cnt 必须为正。")
}
stopifnot(
  all(bike$season %in% 1:4),
  all(bike$yr %in% 0:1),
  all(bike$workingday %in% 0:1),
  all(bike$weathersit %in% 1:3)
)

bike$dteday <- as.Date(bike$dteday)
if (anyNA(bike$dteday)) {
  stop("dteday 中存在无法解析的日期。")
}
bike <- bike[order(bike$dteday), , drop = FALSE]
row.names(bike) <- NULL
if (any(diff(bike$dteday) != 1)) {
  stop("本节的残差时序诊断要求日期连续。")
}
bike$season <- factor(
  bike$season,
  levels = 1:4,
  labels = c("winter", "spring", "summer", "fall")
)
bike$workingday <- factor(
  bike$workingday,
  levels = c(0, 1),
  labels = c("nonworking", "working")
)
bike$year <- factor(
  bike$yr,
  levels = c(0, 1),
  labels = c("2011", "2012")
)
bike$weathersit <- factor(
  bike$weathersit,
  levels = 1:3,
  labels = c("clear", "mist_cloudy", "light_precipitation")
)

# 显式固定 treatment contrasts,第一水平作为基准组。
contrasts(bike$season) <- contr.treatment(levels(bike$season), base = 1)
contrasts(bike$workingday) <- contr.treatment(
  levels(bike$workingday), base = 1
)
contrasts(bike$year) <- contr.treatment(levels(bike$year), base = 1)
contrasts(bike$weathersit) <- contr.treatment(
  levels(bike$weathersit), base = 1
)
bike$log_cnt <- log(bike$cnt)

bike_info <- data.frame(
  item = c("天数", "起始日期", "结束日期", "平均日租赁量", "日租赁量中位数"),
  value = c(
    nrow(bike),
    format(min(bike$dteday)),
    format(max(bike$dteday)),
    sprintf("%.1f", mean(bike$cnt)),
    sprintf("%.1f", median(bike$cnt))
  )
)
knitr::kable(
  bike_info,
  row.names = FALSE,
  col.names = c("数据摘要", "数值")
)| 数据摘要 | 数值 |
|---|---|
| 天数 | 731 |
| 起始日期 | 2011-01-01 |
| 结束日期 | 2012-12-31 |
| 平均日租赁量 | 4504.3 |
| 日租赁量中位数 | 4548.0 |
temp、hum 和 windspeed 都是数据发布者提供的归一化变量,不是摄氏度、百分比和原始风速。因此后面的连续变量效应按“归一化尺度增加 0.1”解释。基准组由上述因子水平明确规定:2011 年、非工作日、冬季和晴朗天气。
12.7.2 先检查实际进入模型的矩阵
两个响应使用相同的解释变量:
\[ \texttt{temp} + \texttt{hum} + \texttt{windspeed} + \texttt{workingday} + \texttt{season} + \texttt{weathersit} + \texttt{year}. \]
bike_lm_formula <- log_cnt ~ temp + hum + windspeed + workingday +
  season + weathersit + year
bike_glm_formula <- cnt ~ temp + hum + windspeed + workingday +
  season + weathersit + year

bike_frame <- model.frame(bike_glm_formula, data = bike)
X_bike <- model.matrix(bike_glm_formula, data = bike_frame)
y_bike <- model.response(bike_frame)
qr_bike <- qr(X_bike)

bike_design_summary <- data.frame(
  observations = nrow(X_bike),
  columns = ncol(X_bike),
  numerical_rank = qr_bike$rank,
  condition_number = kappa(X_bike, exact = TRUE)
)
knitr::kable(
  bike_design_summary,
  row.names = FALSE,
  digits = 3,
  col.names = c("观测数", "列数", "数值秩", "条件数")
)| 观测数 | 列数 | 数值秩 | 条件数 |
|---|---|---|---|
| 731 | 11 | 11 | 26.52 |
| 设计矩阵列 |
|---|
| (Intercept) |
| temp |
| hum |
| windspeed |
| workingdayworking |
| seasonspring |
| seasonsummer |
| seasonfall |
| weathersitmist_cloudy |
| weathersitlight_precipitation |
| year2012 |
列名给出了软件实际估计的参数。矩阵在当前容差下满列秩,原始设计的条件数也不高;这只能排除明显的秩亏和尺度病态,不能代替对均值结构、方差和时间依赖的检查。
12.7.3 拟合模型并核对收敛点的 WLS 固定点
fit_bike_lm <- lm(bike_lm_formula, data = bike)
fit_bike_pois <- glm(
  bike_glm_formula,
  data = bike,
  family = poisson(link = "log")
)
fit_bike_qpois <- glm(
  bike_glm_formula,
  data = bike,
  family = quasipoisson(link = "log")
)

# 从 glm() 返回的收敛点同步重算工作响应和权重,再额外更新一步。
eta_bike_solution <- fit_bike_pois$linear.predictors
mu_bike_solution <- fitted(fit_bike_pois)
w_bike_solution <- mu_bike_solution
z_bike_solution <- eta_bike_solution +
  (y_bike - mu_bike_solution) / mu_bike_solution
sqrt_w_bike <- sqrt(w_bike_solution)
X_bike_weighted <- sweep(X_bike, 1, sqrt_w_bike, `*`)
beta_bike_final_wls <- qr.coef(
  qr(X_bike_weighted),
  sqrt_w_bike * z_bike_solution
)

poisson_score <- drop(crossprod(
  X_bike,
  y_bike - fitted(fit_bike_pois)
))

bike_computation_checks <- data.frame(
  quantity = c(
    "Poisson 是否收敛",
    "Poisson IRLS 迭代次数",
    "收敛点加权设计矩阵的秩",
    "收敛点加权设计矩阵的条件数",
    "一步 WLS 更新与 glm() 的最大系数差",
    "按响应总量缩放的最大 Poisson score"
  ),
  value = c(
    as.character(fit_bike_pois$converged),
    as.character(fit_bike_pois$iter),
    as.character(qr(X_bike_weighted)$rank),
    sprintf("%.6g", kappa(X_bike_weighted, exact = TRUE)),
    sprintf("%.6g", max(abs(
      beta_bike_final_wls - coef(fit_bike_pois)
    ))),
    sprintf("%.6g", max(abs(poisson_score)) / (1 + sum(y_bike)))
  )
)
knitr::kable(
  bike_computation_checks,
  row.names = FALSE,
  col.names = c("计算核对", "数值")
)| 计算核对 | 数值 |
|---|---|
| Poisson 是否收敛 | TRUE |
| Poisson IRLS 迭代次数 | 4 |
| 收敛点加权设计矩阵的秩 | 11 |
| 收敛点加权设计矩阵的条件数 | 28.8489 |
| 一步 WLS 更新与 glm() 的最大系数差 | 2.60846e-09 |
| 按响应总量缩放的最大 Poisson score | 3.00215e-11 |
若返回的系数是 IRLS 的固定点,从该点重新构造工作响应和工作权重,再做一次 WLS 更新,系数应当几乎不动。这里的一步更新与 glm() 返回值非常接近;表中的 Poisson score 按\(\max_{1\leq j\leq p}|U_j|/(1+\sum_{i=1}^n y_i)\) 缩放后也接近零。这两项核对说明IRLS 已经把给定的 Poisson 估计方程解到设定精度;它们不是软件内部迭代历史的重放。此时还不能断言Poisson 方差或独立性假设适合数据。
12.7.4 过度离散改变标准误,不改变拟合均值
下面统一用 Pearson \(\chi^2/(n-r)\) 检查计数模型的离散度。对数线性模型的残差方差处在log(cnt) 尺度,另行报告,不能和无量纲的 Poisson 离散度直接比较。
pearson_dispersion <- function(fit) {
  sum(residuals(fit, type = "pearson")^2) / fit$df.residual
}

phi_bike_pois_pearson <- pearson_dispersion(fit_bike_pois)
phi_bike_qpois_pearson <- pearson_dispersion(fit_bike_qpois)
phi_bike_qpois_used <- summary(fit_bike_qpois)$dispersion

lm_scale_table <- data.frame(
  quantity = "log(cnt) 尺度上的线性模型残差方差",
  value = summary(fit_bike_lm)$sigma^2
)
knitr::kable(
  lm_scale_table,
  row.names = FALSE,
  digits = 4,
  col.names = c("统计量", "数值")
)| 统计量 | 数值 |
|---|---|
| log(cnt) 尺度上的线性模型残差方差 | 0.0896 |
count_dispersion_table <- data.frame(
  quantity = c(
    "Poisson 模型标准误使用的方差尺度",
    "Poisson Pearson 卡方 / 残差自由度",
    "准 Poisson Pearson 卡方 / 残差自由度",
    "summary() 用于准 Poisson 标准误的离散度"
  ),
  value = c(
    1,
    phi_bike_pois_pearson,
    phi_bike_qpois_pearson,
    phi_bike_qpois_used
  )
)
knitr::kable(
  count_dispersion_table,
  row.names = FALSE,
  digits = 3,
  col.names = c("统计量", "数值")
)| 统计量 | 数值 |
|---|---|
| Poisson 模型标准误使用的方差尺度 | 1.0 |
| Poisson Pearson 卡方 / 残差自由度 | 174.2 |
| 准 Poisson Pearson 卡方 / 残差自由度 | 174.2 |
| summary() 用于准 Poisson 标准误的离散度 | 174.2 |
Pearson 离散度远大于 1,说明标准 Poisson 的“条件方差等于条件均值”与当前均值公式组合后,严重低估了剩余波动。两种计数拟合的 Pearson 值应相同;summary() 实际用于准 Poisson 标准误的尺度可能因迭代停止容差在最后几位略有差异。准 Poisson 用这个估计尺度放大协方差。下面直接核对两种计数模型的共同点和差异。
se_bike_pois <- coef(summary(fit_bike_pois))[, 2]
se_bike_qpois <- coef(summary(fit_bike_qpois))[, 2]

poisson_quasi_checks <- data.frame(
  quantity = c(
    "最大系数差",
    "最大拟合均值差",
    "标准误之比的平均值:准 Poisson / Poisson",
    "准 Poisson 离散度的平方根"
  ),
  value = c(
    max(abs(coef(fit_bike_pois) - coef(fit_bike_qpois))),
    max(abs(fitted(fit_bike_pois) - fitted(fit_bike_qpois))),
    mean(se_bike_qpois / se_bike_pois),
    sqrt(phi_bike_qpois_used)
  )
)
knitr::kable(
  poisson_quasi_checks,
  row.names = FALSE,
  digits = 6,
  col.names = c("计算核对", "数值")
)| 计算核对 | 数值 |
|---|---|
| 最大系数差 | 0.0 |
| 最大拟合均值差 | 0.0 |
| 标准误之比的平均值:准 Poisson / Poisson | 13.2 |
| 准 Poisson 离散度的平方根 | 13.2 |
系数和拟合均值相同,而标准误之比等于 \(\sqrt{\hat\phi}\)。这是准 Poisson 的计算作用:它没有重新拟合另一条条件均值曲线,而是改变了这条曲线附近不确定性的尺度。
12.7.5 系数解释的变化尺度
对对数连接模型,连续变量增加 \(\Delta\) 时,条件均值比为\(\exp(\Delta\beta_j)\)。对归一化连续变量直接报告 \(\exp(\beta_j)\),相当于跨越整个单位区间,通常不够直观。下面对连续变量使用 0.1 的变化,对因子使用相对于基准组的一次类别变化,并采用准 Poisson标准误构造 Wald 区间。
selected_bike_terms <- c(
  "temp", "hum", "windspeed", "year2012",
  "weathersitlight_precipitation"
)
effect_change <- c(0.1, 0.1, 0.1, 1, 1)
effect_label <- c(
  "温度增加 0.1(归一化尺度)",
  "湿度增加 0.1(归一化尺度)",
  "风速增加 0.1(归一化尺度)",
  "2012 年相对于 2011 年",
  "轻微降水相对于晴朗天气"
)

beta_selected <- coef(fit_bike_qpois)[selected_bike_terms]
se_selected <- coef(summary(fit_bike_qpois))[
  selected_bike_terms, "Std. Error"
]
critical_value <- qt(0.975, df = fit_bike_qpois$df.residual)

bike_effect_table <- data.frame(
  comparison = effect_label,
  mean_ratio = exp(effect_change * beta_selected),
  lower_95 = exp(
    effect_change * (beta_selected - critical_value * se_selected)
  ),
  upper_95 = exp(
    effect_change * (beta_selected + critical_value * se_selected)
  )
)
knitr::kable(
  bike_effect_table,
  row.names = FALSE,
  digits = 3,
  col.names = c("变量变化", "条件均值比", "95% 下限", "95% 上限")
)| 变量变化 | 条件均值比 | 95% 下限 | 95% 上限 |
|---|---|---|---|
| 温度增加 0.1(归一化尺度) | 1.129 | 1.113 | 1.146 |
| 湿度增加 0.1(归一化尺度) | 0.975 | 0.961 | 0.989 |
| 风速增加 0.1(归一化尺度) | 0.944 | 0.925 | 0.964 |
| 2012 年相对于 2011 年 | 1.582 | 1.536 | 1.630 |
| 轻微降水相对于晴朗天气 | 0.484 | 0.420 | 0.558 |
均值比大于 1 表示在模型所控制的其他变量相同时,期望租赁量较高;小于 1 表示较低。这些是条件关联,不是天气或年份效应的因果估计。区间还依赖独立性和均值—方差设定,下一小节会检查其中一个明显风险。
12.7.6 残差的时间依赖
日度数据按连续日期排列,相邻两天很可能共享未进入模型的需求水平、活动和天气过程。下面定位几个诊断量,并画出拟合值、Pearson 残差的时间顺序和残差自相关函数。
pearson_bike <- residuals(fit_bike_qpois, type = "pearson")
leverage_bike <- hatvalues(fit_bike_qpois)
cook_bike <- cooks.distance(fit_bike_qpois)
lag1_bike <- cor(
  pearson_bike[-1],
  pearson_bike[-length(pearson_bike)]
)

largest_residual <- which.max(abs(pearson_bike))
largest_leverage <- which.max(leverage_bike)
largest_cook <- which.max(cook_bike)

bike_diagnostic_table <- data.frame(
  quantity = c(
    "Pearson 残差的一阶相关",
    "最大 |Pearson 残差|(日期)",
    "最大加权杠杆值(日期)",
    "最大 Cook 距离(日期)"
  ),
  value = c(
    sprintf("%.3f", lag1_bike),
    sprintf(
      "%.3f (%s)",
      abs(pearson_bike[largest_residual]),
      bike$dteday[largest_residual]
    ),
    sprintf(
      "%.4f (%s)",
      leverage_bike[largest_leverage],
      bike$dteday[largest_leverage]
    ),
    sprintf(
      "%.4f (%s)",
      cook_bike[largest_cook],
      bike$dteday[largest_cook]
    )
  )
)
knitr::kable(
  bike_diagnostic_table,
  row.names = FALSE,
  col.names = c("诊断量", "数值(日期)")
)| 诊断量 | 数值(日期) |
|---|---|
| Pearson 残差的一阶相关 | 0.500 |
| 最大 |Pearson 残差|(日期) | 64.762 (2012-03-17) |
| 最大加权杠杆值(日期) | 0.1058 (2012-10-02) |
| 最大 Cook 距离(日期) | 0.1164 (2012-10-29) |
old_par <- par(mfrow = c(1, 3), mar = c(4, 4, 2, 1))

plot(
  bike$cnt, fitted(fit_bike_qpois),
  xlab = "观测日租赁量",
  ylab = "拟合条件均值",
  pch = 20, col = "#0072B255"
)
abline(0, 1, col = "#D55E00", lwd = 2)

plot(
  bike$dteday, pearson_bike,
  type = "l", col = "#0072B2",
  xlab = "日期", ylab = "Pearson 残差"
)
abline(h = 0, col = "grey40", lty = 2)

acf(
  pearson_bike,
  lag.max = 30,
  main = "Pearson 残差自相关",
  xlab = "滞后天数"
)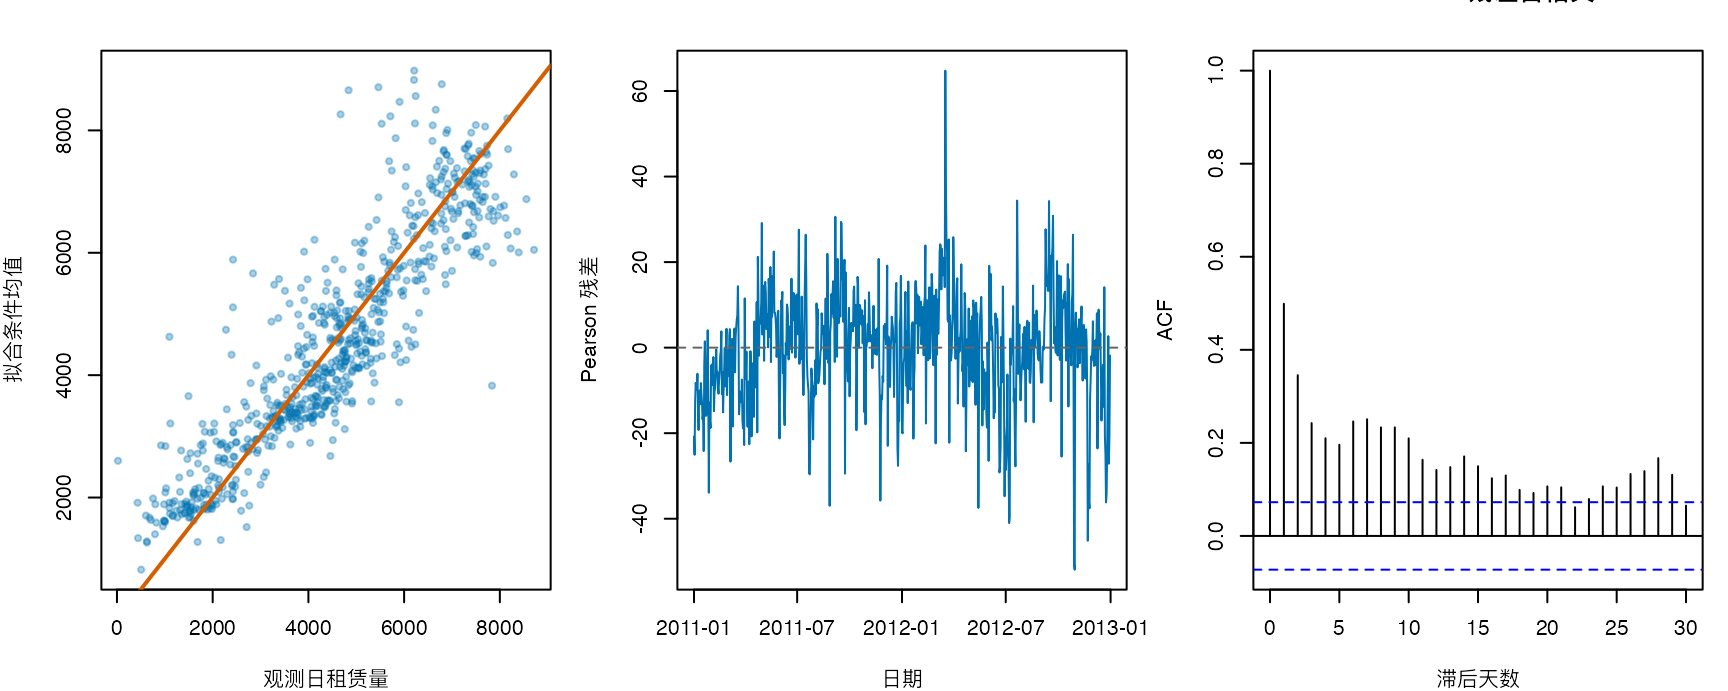
图12.1: 共享单车计数模型的拟合与残差诊断。Poisson 和准 Poisson 具有相同的拟合均值;Pearson 残差仍保留明显的时间结构。
一阶残差相关明显不接近零。准 Poisson 只把方差从 \(\mu_i\) 放宽为 \(\phi\mu_i\),没有处理序列相关、遗漏趋势或季节内非线性。因此,准 Poisson 的常规标准误在这里也不能被视为最终答案。更合适的后续分析可能需要时间趋势、平滑季节项、滞后结构、聚类或时间序列协方差,并用按时间顺序划分的样本外评估检验预测能力。
12.7.7 对数模型的反变换
predict(fit_bike_lm) 估计的是\(\operatorname{E}\{\log(Y)\mid\mathbf x\}\)。直接取指数得到\(\exp[\operatorname{E}\{\log(Y)\mid\mathbf x\}]\),即几何均值尺度的拟合值;当对数误差对称且中位数为 0 时,它也对应原尺度的条件中位数,但一般不等于 \(\operatorname{E}(Y\mid\mathbf x)\)。这是 Jensen 不等式带来的重转换问题。
若对数模型写为
\[ \log(Y_i)=\mathbf x_i^\top\boldsymbol\beta+\varepsilon_i, \]
若\(\varepsilon_i\mid\mathbf x_i\sim N(0,\sigma^2)\) 且方差不随 \(\mathbf x_i\) 改变,则
\[ \operatorname{E}(Y_i\mid\mathbf x_i) =\exp(\mathbf x_i^\top\boldsymbol\beta) \operatorname{E}\{\exp(\varepsilon_i)\mid\mathbf x_i\} =\exp(\mathbf x_i^\top\boldsymbol\beta+\sigma^2/2). \]
不要求误差正态时,若\(\operatorname{E}\{\exp(\varepsilon_i)\mid\mathbf x_i\}=S\) 可以近似看作不随 \(\mathbf x_i\) 改变,则可用 Duansmearing 因子
\[ \hat S=\frac{1}{n}\sum_{i=1}^n\exp(\hat\varepsilon_i) \]
估计原尺度条件均值为\(\hat S\exp(\mathbf x^\top\widehat{\boldsymbol\beta})\)。若误差分布随解释变量明显改变,一个全局smearing 因子便可能不足。
bike_profile <- data.frame(
  temp = c(0.25, 0.65),
  hum = c(0.70, 0.55),
  windspeed = c(0.25, 0.15),
  workingday = factor(
    c("working", "working"),
    levels = levels(bike$workingday)
  ),
  season = factor(
    c("winter", "summer"),
    levels = levels(bike$season)
  ),
  weathersit = factor(
    c("mist_cloudy", "clear"),
    levels = levels(bike$weathersit)
  ),
  year = factor(
    c("2012", "2012"),
    levels = levels(bike$year)
  )
)

smearing_factor <- mean(exp(residuals(fit_bike_lm)))
lm_log_prediction <- predict(fit_bike_lm, newdata = bike_profile)
qpois_link_prediction <- predict(
  fit_bike_qpois,
  newdata = bike_profile,
  type = "link",
  se.fit = TRUE
)

bike_prediction <- data.frame(
  profile = c("低温有雾工作日", "温暖晴朗工作日"),
  log_lm_geometric_scale = exp(lm_log_prediction),
  log_lm_smearing_mean =
    smearing_factor * exp(lm_log_prediction),
  qpois_conditional_mean = exp(qpois_link_prediction$fit),
  qpois_mean_lower_95 = exp(
    qpois_link_prediction$fit -
      critical_value * qpois_link_prediction$se.fit
  ),
  qpois_mean_upper_95 = exp(
    qpois_link_prediction$fit +
      critical_value * qpois_link_prediction$se.fit
  )
)
knitr::kable(
  bike_prediction,
  row.names = FALSE,
  digits = 1,
  col.names = c(
    "预测情景", "对数模型几何尺度", "对数模型 smearing 均值",
    "准 Poisson 条件均值", "均值区间下限", "均值区间上限"
  )
)| 预测情景 | 对数模型几何尺度 | 对数模型 smearing 均值 | 准 Poisson 条件均值 | 均值区间下限 | 均值区间上限 |
|---|---|---|---|---|---|
| 低温有雾工作日 | 2392 | 2473 | 2705 | 2578 | 2837 |
| 温暖晴朗工作日 | 7088 | 7329 | 6913 | 6694 | 7140 |
data.frame(smearing_factor = smearing_factor) |>
  knitr::kable(
    row.names = FALSE,
    digits = 4,
    col.names = "Smearing 因子"
)| Smearing 因子 |
|---|
| 1.034 |
比较原尺度条件均值时,应使用 smearing 修正后的对数模型结果,而不是未经修正的指数值。准 Poisson区间是在对数连接尺度上构造后反变换的近似、点态、大样本 Wald 条件均值区间,不是未来某一天租赁次数的预测区间;准 Poisson 本身没有指定完整的计数分布。表中也把估计的 smearing 因子当作固定量,没有计入它自身的估计误差。由于残差有明显时间依赖,这些区间在本例中主要用于说明计算方法,不宜直接作为实际运营预测依据。
12.8 一次完整模型计算应留下什么证据
从公式到报告,可以按下面的顺序保存计算证据。
- 分析样本。 记录响应、解释变量、缺失值处理、观测单位和实际使用的行数。
- 设计矩阵。 检查列名、因子基准组、维数、秩和条件数,确认公式确实表示预期模型。
- 求解过程。 线性模型记录 QR 秩与残差;GLM 还记录初值、迭代次数、收敛标志、deviance 和score。必要时检查 \(\mathbf W^{1/2}\mathbf X\),而不是只检查原始 \(\mathbf X\)。
- 不确定性。 说明协方差采用的方差、离散度、异方差或相关结构假设。系数相同不意味着标准误必然相同。
- 模型诊断。 查看残差、均值—方差关系、杠杆、影响点和数据结构中的时间、空间或群组依赖。
- 预测目标。 明确报告的是线性预测子、条件均值、条件中位数还是新观测,并使用匹配的区间。
- 外部评估。 若目标是预测,使用未参与拟合的数据;数据有时间顺序时不能随意打乱。第13 章继续讨论这一步。
这份记录的作用不是增加形式上的检查项,而是让每一个最终数字都能追溯到一个明确的模型对象和计算步骤。系数表只是计算链的末端,不是完整分析。
12.9 本章小结
线性模型与 GLM 使用的是同一套计算骨架。公式先生成 \(\mathbf y\) 和 \(\mathbf X\);普通最小二乘对\(\mathbf X\) 做一次 QR 分解,GLM 则在局部工作响应和权重下反复对\(\mathbf W^{1/2}\mathbf X\) 做 QR 分解。三角因子不仅给出系数,也连接到残差方差、Fisher 信息、标准误、杠杆值和预测不确定性。
这条计算链也说明了不同问题应在哪里处理。显式求逆和病态矩阵属于数值问题;秩亏与完全分离涉及参数是否可估;过度离散、残差依赖和均值错设属于统计模型问题;对数反变换和均值区间则要求先说清预测目标。算法收敛是解释模型的必要条件,但从来不是模型正确的充分条件。
12.10 思考题
正规方程与 QR 分解在精确算术下可给出相同的满秩最小二乘解,为什么在浮点计算中仍优先使用 QR?请从计算量、条件数和误差传播三个角度回答。
最小二乘点估计在哪些步骤不需要误差正态假设?正态假设又在哪些推断或预测结论中发挥作用?
设模型同时包含截距和一个有 \(K\) 个水平因子的全部 \(K\) 个虚拟变量。说明设计矩阵为什么秩亏,并给出两种可识别的重新参数化方法。
从 Fisher scoring 更新式出发,证明工作响应 \(\mathbf z\) 和权重矩阵 \(\mathbf W\) 所定义的加权最小二乘正规方程等价于参数更新。说明公共离散度 \(\phi\) 为什么不改变该步的系数。
对 Poisson 对数连接模型,推导 score、Hessian、工作响应和工作权重。为什么计数均值很大的观测在最后的加权问题中可能具有较大工作权重?
完全分离时,Logistic 回归的 deviance 可能继续下降,但系数绝对值不断增大。为什么这不能称为得到了稳定的有限极大似然估计?概率截断又为什么不能解决这个问题?
Poisson 与准 Poisson 具有相同的系数和拟合均值,却可能给出截然不同的显著性结论。结合\(\hat\phi(\mathbf X^\top\mathbf W\mathbf X)^{-1}\) 解释原因,并说明准 Poisson 为什么没有普通 AIC。
为什么
exp(predict(lm(log(y) ~ x)))一般不等于条件均值预测?比较正态误差修正\(\exp(\hat\eta+\hat\sigma^2/2)\) 与 smearing 修正所依赖的条件。
12.11 上机实验(Lab)
Lab 1:从 QR 重建
lm()。 自行模拟含截距和三个解释变量的数据,只使用model.matrix()、qr()、qr.coef()、qr.R()和基本矩阵运算,重建系数、拟合值、残差、\(\hat\sigma^2\)、系数标准误和杠杆值。用数值容差逐项与lm()、vcov()和hatvalues()核对。Lab 2:近共线与尺度。 逐步减小 \(x_2=x_1+\varepsilon\) 中 \(\varepsilon\) 的标准差,记录\(\kappa(\mathbf X)\)、\(\kappa(\mathbf X^\top\mathbf X)\)、正规方程与 QR 的差异、两个系数的变化和拟合值变化。再对变量标准化,判断哪些问题得到改善,哪些没有。
Lab 3:观察完全分离。 构造 \(y=\mathbb I\{x>0\}\) 的数据,运行本章的
logit_irls()并增加maxit。画出每次迭代的 deviance、最大系数、最小工作权重和 score 范数。解释为什么某些指标看似改善,参数却没有有限极限。不要把提高最大迭代次数当作修复方案。Lab 4:从 Poisson 到过度离散。 先模拟真正的 Poisson 回归数据,再通过未观测随机效应生成具有相同条件均值趋势但过度离散的数据。分别拟合 Poisson 和准 Poisson,核对两者系数、拟合值、Pearson离散度和标准误比例。
Lab 5:扩展共享单车案例。 在均值公式中加入月份因子或连续时间趋势,重新检查加权条件数、Pearson离散度、残差 ACF 和影响点。随后按日期把前段作为训练集、后段作为测试集;不要随机打乱日期。比较新模型与本章模型的样本外误差,并区分“残差相关减弱”和“预测变好”这两个结论。
拓展 Lab:区分均值区间与预测区间。 在线性模型的原尺度和对数尺度各模拟一组数据。对同一个新解释变量分别构造条件均值置信区间与新观测预测区间,用重复模拟检查覆盖率。对数模型中同时比较未经修正的指数变换、正态修正和 smearing 修正。