第 11 章 Bootstrap、Jackknife 与置换检验
第 10 章用模型生成随机样本来近似统计量的分布。本章讨论另一类常用方法:从已经观测到的数据中重采样。Bootstrap、Jackknife 和置换检验都属于重采样思想,它们特别适合用于解析标准误难以推导、统计量形式复杂或小样本检验不方便的情形。
经济统计中常见的收入中位数、贫困率、消费收入比、基尼系数和分组均值差等指标,往往不是简单线性统计量。重采样方法可以帮助我们用计算方式评估这些指标的不确定性。
学完本章后,读者应当能够:
- 根据观测单位和抽样设计构造非参数与参数 Bootstrap;
- 用重采样分布估计偏差、标准误和置信区间,并区分统计误差与重采样的 Monte Carlo 误差;
- 用 Jackknife 估计光滑统计量的偏差和标准误,并识别有影响力的观测;
- 在交换性或随机分配假设成立时实施置换检验,报告近似 \(p\) 值的计算精度。
三类方法虽然都“反复计算统计量”,但重采样对象和目标不同:
| 方法 | 重采样机制 | 主要用途 | 关键条件 |
|---|---|---|---|
| 非参数 Bootstrap | 从经验分布有放回抽样 | 标准误、偏差和区间 | 重采样单位能代表原抽样机制 |
| 参数 Bootstrap | 从拟合的概率模型生成数据 | 模型下的标准误和区间 | 参数模型及重新拟合步骤正确 |
| Jackknife | 依次删除一个观测单位 | 光滑统计量的偏差和标准误 | 统计量对单个观测的扰动较平滑 |
| 置换检验 | 在原假设允许的范围内重排标签 | 构造检验的零分布 | 原假设下标签具有交换性 |
这里的 \(n\) 是原始样本量,决定数据包含多少统计信息;\(B\) 是 Bootstrap 或随机置换的重复次数,只控制计算近似的精度。把 \(B\) 增加到很大不能弥补原始样本太小、抽样设计错误或模型设定错误。
11.1 非参数 Bootstrap
设观测样本为
\[ y_1,\ldots,y_n, \]
我们关心统计量
\[ \hat\theta=T(y_1,\ldots,y_n). \]
非参数 Bootstrap 把经验分布作为总体分布的近似:每次从原始样本中有放回抽取 \(n\) 个观测,得到一个Bootstrap 样本,再计算统计量。重复 \(B\) 次后,统计量的条件分布
\[ \mathcal L^\ast(\hat\theta^\ast-\hat\theta\mid y_1,\ldots,y_n) \]
用来近似真实但未知的抽样分布\(\mathcal L(\hat\theta-\theta)\)。星号和条件符号提醒我们:Bootstrap 的随机性是在给定原始样本后人为引入的。
非参数 Bootstrap
- 给定原始样本 \(y_1,\ldots,y_n\) 和统计量函数 \(T(\cdot)\)。
- 对 \(b=1,\ldots,B\):从原始样本中有放回抽取 \(n\) 个观测,得到 \(y_1^{\ast(b)},\ldots,y_n^{\ast(b)}\);计算 \(\hat\theta^{\ast(b)}=T(y_1^{\ast(b)},\ldots,y_n^{\ast(b)})\)。
- 用 \(\hat\theta^{\ast(1)},\ldots,\hat\theta^{\ast(B)}\) 的均值与标准差估计偏差和标准误,并根据重采样分布构造置信区间。
令 \(\overline{\hat\theta}^{\,\ast} =B^{-1}\sum_{b=1}^B\hat\theta^{\ast(b)}\) 表示 \(B\) 个 Bootstrap 估计的均值。Bootstrap 偏差与标准误的常用估计为
\[ \widehat{\operatorname{Bias}}_{\mathrm{boot}} =\overline{\hat\theta}^{\,\ast}-\hat\theta, \qquad \widehat{\operatorname{se}}_{\mathrm{boot}} =\left\{\frac{1}{B-1}\sum_{b=1}^B (\hat\theta^{\ast(b)}-\overline{\hat\theta}^{\,\ast})^2\right\}^{1/2}. \]
下面用模拟的家庭调查数据估计总体平均消费与总体平均收入之比:
\[ \theta=\frac{\operatorname{E}(C)}{\operatorname{E}(Y)}, \qquad \hat\theta=\frac{\bar C}{\bar Y}, \]
其中 \(\bar C\) 是样本平均消费,\(\bar Y\) 是样本平均收入。
set.seed(2026)
n <- 300
income <- rlnorm(n, meanlog = log(8), sdlog = 0.55)
consumption <- 1.2 + 0.62 * income + rnorm(n, sd = 1.5)
consumption <- pmax(consumption, 0.2)
dat <- data.frame(income = income, consumption = consumption)

ratio_stat <- function(d) mean(d$consumption) / mean(d$income)
theta_hat <- ratio_stat(dat)

B <- 4000
boot_theta <- numeric(B)
for (b in seq_len(B)) {
  id <- sample.int(n, size = n, replace = TRUE)
  boot_theta[b] <- ratio_stat(dat[id, , drop = FALSE])
}

boot_bias <- mean(boot_theta) - theta_hat
boot_se <- sd(boot_theta)

# Delta 方法只用于独立核对 Bootstrap 标准误
sample_moments <- cbind(consumption = dat$consumption,
                        income = dat$income)
gradient <- c(1 / mean(dat$income),
              -mean(dat$consumption) / mean(dat$income)^2)
delta_se <- sqrt(drop(
  t(gradient) %*% (cov(sample_moments) / n) %*% gradient
))

bootstrap_summary <- data.frame(
  estimate = theta_hat,
  boot_bias = boot_bias,
  boot_se = boot_se,
  delta_se = delta_se,
  mc_se_boot_se = boot_se / sqrt(2 * (B - 1))
)
knitr::kable(bootstrap_summary, row.names = FALSE, digits = 5)| estimate | boot_bias | boot_se | delta_se | mc_se_boot_se |
|---|---|---|---|---|
| 0.7596 | 0.00015 | 0.01012 | 0.01018 | 0.00011 |
收入与消费必须按家庭整行重采样;若分别重采样两列,会破坏二者的相关关系,估计的是另一个抽样过程。表中的 mc_se_boot_se 是在重采样分布近似正态时,Bootstrap 标准误自身 Monte Carlo 标准误的近似。它衡量有限 \(B\) 带来的计算波动,不是消费收入比的统计标准误。
11.1.1 Bootstrap 置信区间
若 \(q_\alpha^\ast\) 是 Bootstrap 统计量的 \(\alpha\) 分位数,常见的三种 95% 区间为
\[ \begin{aligned} \text{正态区间:}\quad & \hat\theta\mathbin{\pm}z_{0.975}\widehat{\operatorname{se}}_{\mathrm{boot}},\\ \text{百分位数区间:}\quad & [q_{0.025}^\ast,q_{0.975}^\ast],\\ \text{基本区间:}\quad & [2\hat\theta-q_{0.975}^\ast,\ 2\hat\theta-q_{0.025}^\ast]. \end{aligned} \]
boot_quantile <- quantile(boot_theta, c(0.025, 0.975),
                          names = FALSE)
critical_value <- qnorm(0.975)

ratio_intervals <- data.frame(
  method = c("normal", "percentile", "basic"),
  lower = c(theta_hat - critical_value * boot_se,
            boot_quantile[1],
            2 * theta_hat - boot_quantile[2]),
  upper = c(theta_hat + critical_value * boot_se,
            boot_quantile[2],
            2 * theta_hat - boot_quantile[1])
)
knitr::kable(ratio_intervals, row.names = FALSE, digits = 5)| method | lower | upper |
|---|---|---|
| normal | 0.7398 | 0.7794 |
| percentile | 0.7405 | 0.7802 |
| basic | 0.7390 | 0.7788 |
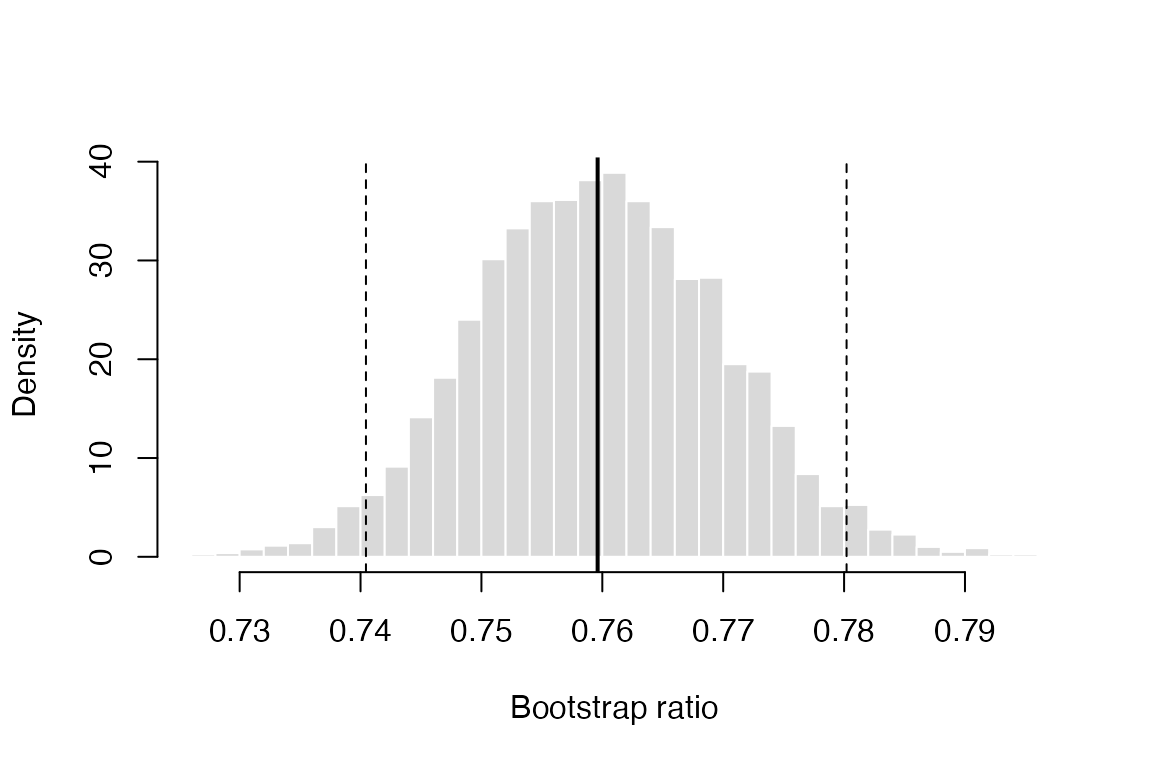
图11.1: 平均消费收入比的非参数 Bootstrap 分布。实线为原样本估计,虚线为百分位数区间端点。
百分位数区间直接读取重采样分布,基本区间则把重采样误差关于原估计量反射。三种区间在近似对称时往往接近,但它们都不是自动可靠的:偏斜、边界参数、不连续统计量或小样本会影响覆盖率。更高阶的偏差校正加速(bias-corrected and accelerated,BCa)区间会同时修正偏差和变换后的尺度,但仍不能修复错误的重采样单位或不合适的数据结构假设。
11.1.2 重复次数与计算误差
固定原始数据后,不同随机种子得到的 Bootstrap 标准误仍会略有不同。下面对几个 \(B\) 分别重复整个Bootstrap 计算;between_run_sd 衡量的正是有限重采样次数带来的计算波动。
bootstrap_ratio_se <- function(B, data) {
  n_data <- nrow(data)
  id <- matrix(
    sample.int(n_data, n_data * B, replace = TRUE),
    nrow = n_data
  )
  consumption_star <- matrix(data$consumption[id], nrow = n_data)
  income_star <- matrix(data$income[id], nrow = n_data)
  value <- colMeans(consumption_star) / colMeans(income_star)
  sd(value)
}

set.seed(2027)
B_grid <- c(200, 1000, 3000)
R_mc <- 20
stability <- data.frame(B = B_grid, mean_boot_se = NA_real_,
                        between_run_sd = NA_real_)

for (j in seq_along(B_grid)) {
  repeated_se <- replicate(
    R_mc, bootstrap_ratio_se(B_grid[j], dat)
  )
  stability$mean_boot_se[j] <- mean(repeated_se)
  stability$between_run_sd[j] <- sd(repeated_se)
}

knitr::kable(stability, row.names = FALSE,
digits = c(0, 5, 5))| B | mean_boot_se | between_run_sd |
|---|---|---|
| 200 | 0.01004 | 0.00047 |
| 1000 | 0.01019 | 0.00023 |
| 3000 | 0.01020 | 0.00016 |
增大 \(B\) 会让同一数据集上的重采样结果更稳定,却不会让原始样本量从 300 变大。对尾部分位数区间,还要确保每个尾部有足够多的重采样值;报告高精度端点通常需要比估计标准误更多的重复次数。
11.2 参数 Bootstrap
非参数 Bootstrap 直接从经验分布抽样。参数 Bootstrap 则先拟合一个参数模型,再从拟合模型中生成新样本。例如,若假设计数变量服从 Poisson 分布,可以先估计 \(\lambda\),再从\(\operatorname{Poisson}(\hat\lambda)\) 中模拟新样本。
设 \(\hat\theta\) 是由原始数据估计出的参数,参数 Bootstrap 的基本过程为:
- 用原始数据拟合模型,得到 \(\hat\theta\);
- 从模型 \(p(y\mid\hat\theta)\) 中模拟新样本;
- 对每个模拟样本重新估计统计量;
- 用重复结果评估标准误或置信区间。
参数 Bootstrap 依赖模型假设。如果模型设定合理,它可能比非参数 Bootstrap 更有效;如果模型明显错误,则会把错误假设带入不确定性评估。每个模拟样本都必须重复原始分析中的估计步骤,而不能直接把生成数据时使用的 \(\hat\theta\) 当成新样本的估计量。
下面假设一段时间内每家门店的投诉数 \(Y_i\sim\operatorname{Poisson}(\lambda)\),目标是模型隐含的零投诉概率
\[ p_0=P(Y=0)=e^{-\lambda}. \]
这是 \(\lambda\) 的非线性函数,参数 Bootstrap 要先用每个新样本重新估计 \(\lambda\),再计算\(\hat p_0^\ast=e^{-\hat\lambda^\ast}\)。
set.seed(1)
n_count <- 80
y <- rpois(n_count, lambda = 3.2)
lambda_hat <- mean(y)
p0_hat <- exp(-lambda_hat)

B <- 4000
lambda_boot <- numeric(B)
for (b in seq_len(B)) {
  y_star <- rpois(length(y), lambda = lambda_hat)
  lambda_boot[b] <- mean(y_star)
}
p0_boot <- exp(-lambda_boot)

p0_quantile <- quantile(p0_boot, c(0.025, 0.975),
                        names = FALSE)
p0_delta_se <- p0_hat * sqrt(lambda_hat / n_count)

parametric_summary <- data.frame(
  estimate = p0_hat,
  boot_bias = mean(p0_boot) - p0_hat,
  boot_se = sd(p0_boot),
  delta_se = p0_delta_se,
  pct_lower = p0_quantile[1],
  pct_upper = p0_quantile[2]
)
knitr::kable(parametric_summary, row.names = FALSE,
digits = 5)| estimate | boot_bias | boot_se | delta_se | pct_lower | pct_upper |
|---|---|---|---|---|---|
| 0.03553 | 0.00074 | 0.00728 | 0.00726 | 0.02381 | 0.05169 |
Delta 方法给出近似标准误\(e^{-\hat\lambda}\sqrt{\hat\lambda/n}\),可以作为独立核对。若投诉数存在明显过度离散、门店规模差异或时间相关性,Poisson 参数 Bootstrap 会低估不确定性;增加 \(B\) 只能更精确地重复这个错误模型,不能消除模型误设。
11.3 Jackknife
Jackknife 是一种更早的重采样方法。它每次删除一个观测,计算统计量的留一估计:
\[ \hat\theta_{(-i)}=T(y_1,\ldots,y_{i-1},y_{i+1},\ldots,y_n). \]
Jackknife 偏差估计为
\[ \widehat{\operatorname{Bias}}_{\mathrm{jack}} =(n-1)(\bar\theta_{(\cdot)}-\hat\theta), \]
其中
\[ \bar\theta_{(\cdot)}=\frac{1}{n}\sum_{i=1}^n \hat\theta_{(-i)}. \]
Jackknife 标准误估计为
\[ \widehat{\operatorname{se}}_{\mathrm{jack}} = \sqrt{ \frac{n-1}{n} \sum_{i=1}^n(\hat\theta_{(-i)}-\bar\theta_{(\cdot)})^2 }. \]
相应的偏差修正估计为\(\hat\theta_{\mathrm{jack}}=\hat\theta-\widehat{\operatorname{Bias}}_{\mathrm{jack}}\)。还可以定义伪值
\[ \tilde\theta_i=n\hat\theta-(n-1)\hat\theta_{(-i)}, \]
其平均值正好等于 \(\hat\theta_{\mathrm{jack}}\)。留一结果不仅能估计标准误,也能帮助发现对结论影响较大的观测。
下面仍用平均消费收入比,使 Jackknife、Bootstrap 和 Delta 方法可以直接比较。
n <- nrow(dat)
theta_leave_one <- numeric(n)
for (i in seq_len(n)) {
  theta_leave_one[i] <- ratio_stat(dat[-i, , drop = FALSE])
}

theta_bar <- mean(theta_leave_one)
jack_bias <- (n - 1) * (theta_bar - theta_hat)
jack_se <- sqrt((n - 1) / n * sum((theta_leave_one - theta_bar)^2))
theta_jack <- theta_hat - jack_bias
pseudo_value <- n * theta_hat - (n - 1) * theta_leave_one

method_comparison <- data.frame(
  method = c("Bootstrap", "Jackknife", "Delta"),
  estimate = c(theta_hat, theta_jack, theta_hat),
  standard_error = c(boot_se, jack_se, delta_se)
)
knitr::kable(method_comparison, row.names = FALSE, digits = 5)| method | estimate | standard_error |
|---|---|---|
| Bootstrap | 0.7596 | 0.01012 |
| Jackknife | 0.7595 | 0.01019 |
| Delta | 0.7596 | 0.01018 |
三个标准误接近,是这个平滑比率统计量实现正确的一个交叉检查,并不表示三种方法在所有问题中等价。对样本均值,Jackknife 标准误与通常的 \(s/\sqrt n\) 完全一致;对中位数、极端分位数、最大值或模型选择后的统计量,留一扰动可能不够平滑,Jackknife 可能不稳定甚至不一致。
下面列出伪值偏离其中位数最远的五个家庭。这个排序只是影响诊断,不等同于判定观测有误。
influence_order <- order(
  abs(pseudo_value - median(pseudo_value)), decreasing = TRUE
)
influence_id <- head(influence_order, 5)
influence_table <- data.frame(
  id = influence_id,
  income = dat$income[influence_id],
  consumption = dat$consumption[influence_id],
  household_ratio = dat$consumption[influence_id] /
    dat$income[influence_id],
  pseudo_value = pseudo_value[influence_id]
)
knitr::kable(influence_table, row.names = FALSE,
digits = c(0, 3, 3, 3, 3))| id | income | consumption | household_ratio | pseudo_value |
|---|---|---|---|---|
| 16 | 16.782 | 8.100 | 0.483 | 0.263 |
| 160 | 9.639 | 11.891 | 1.234 | 1.246 |
| 220 | 26.268 | 16.017 | 0.610 | 0.338 |
| 169 | 5.371 | 8.044 | 1.498 | 1.181 |
| 285 | 10.605 | 11.998 | 1.131 | 1.180 |
若某个家庭同时具有很高收入和异常消费模式,删除它可能明显改变分子、分母及二者的协方差。应回到原始记录和抽样设计判断其原因,而不是看到大伪值就自动删除。
11.4 置换检验
置换检验常用于检验两组是否存在差异。其基本思想是:在原假设下,组别标签与结果变量没有关系,因此可以随机打乱组别标签,观察原始统计量在“无差异世界”中是否显得极端。
设样本中观察到的两组均值差为
\[ D_{\mathrm{obs}}=\bar y_1-\bar y_0. \]
置换检验重复打乱组别标签,得到 \(D^{\ast(1)},\ldots,D^{\ast(B)}\),再计算随机置换\(p\) 值
\[ \hat p_{\mathrm{perm}} =\frac{1+\sum_{b=1}^B \mathbb I\{|D^{\ast(b)}|\geq |D_{\mathrm{obs}}|\}}{B+1}. \]
这里加 1 是为了避免有限模拟下得到 0 的 p 值。
两组随机置换检验
- 选择能反映研究问题的统计量 \(D\),并计算观测值 \(D_{\mathrm{obs}}\)。
- 在原假设允许的范围内重排组别标签,同时保持结果值和组样本量不变。
- 对 \(b=1,\ldots,B\) 计算置换统计量 \(D^{\ast(b)}\)。
- 按预先规定的单侧或双侧准则计算极端置换的比例,并报告有限 \(B\) 的计算误差。
“可以交换”是统计假设,不是编程技巧。随机试验中,在无处理效应的尖锐原假设下,随机分配机制规定哪些标签重排合法;独立两样本问题中,简单置换通常要求原假设下两组观测来自同一分布。若只假设两组均值相等、但方差或分布形状允许不同,未学生化的均值差置换检验一般不再是有限样本精确检验。
下面构造一个模拟就业培训实验。treated 表示是否被随机分配接受培训,employment 表示随后是否就业。处理组人数预先固定;数据是模拟的,只用于说明计算过程。
set.seed(2)
n0 <- 120
n1 <- 100
treated <- c(rep(0, n0), rep(1, n1))
employment <- c(rbinom(n0, 1, 0.66),
                rbinom(n1, 1, 0.74))

obs_diff <- mean(employment[treated == 1]) -
  mean(employment[treated == 0])

B <- 9999
perm_diff <- numeric(B)
for (b in seq_len(B)) {
  treated_perm <- sample(treated)
  perm_diff[b] <- mean(employment[treated_perm == 1]) -
    mean(employment[treated_perm == 0])
}

extreme_count <- sum(abs(perm_diff) >= abs(obs_diff))
p_value <- (1 + extreme_count) / (B + 1)
extreme_rate <- extreme_count / B
p_value_mc_se <- sqrt(extreme_rate * (1 - extreme_rate) / B)

permutation_summary <- data.frame(
  observed = obs_diff,
  B = B,
  extreme = extreme_count,
  p_value = p_value,
  mc_se = p_value_mc_se,
  min_p = 1 / (B + 1)
)
knitr::kable(permutation_summary, row.names = FALSE,
digits = c(4, 0, 0, 4, 4, 5))| observed | B | extreme | p_value | mc_se | min_p |
|---|---|---|---|---|---|
| 0.0783 | 9999 | 2470 | 0.2471 | 0.0043 | 1e-04 |
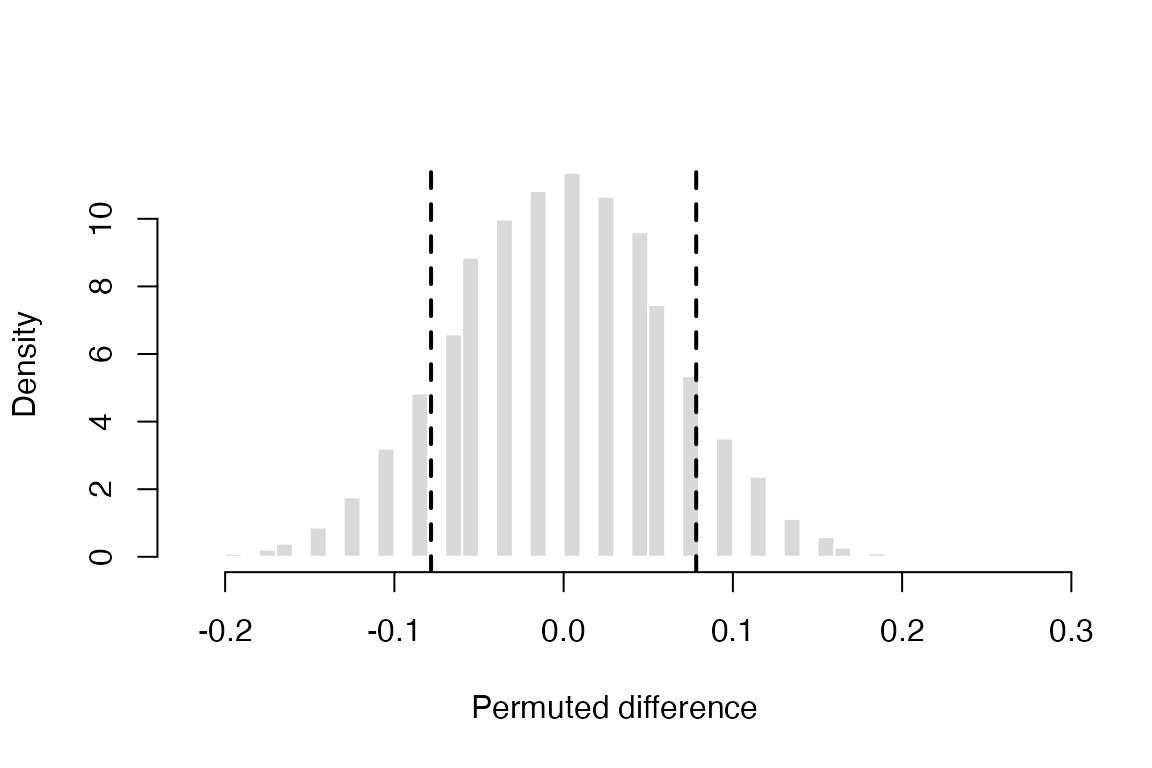
图11.2: 政策试点例子的置换零分布。两条虚线表示与观测均值差同样或更加极端的双侧边界。
若能枚举所有 \(\binom{n_0+n_1}{n_1}\) 种标签分配,就可以得到精确置换 \(p\) 值;本例使用 \(B\) 次随机置换,因此还有 Monte Carlo 误差。mc_se 近似衡量再次执行同样数量随机置换时 \(p\) 值的波动,min_p 则说明有限 \(B\) 下不能声称得到比 \(1/(B+1)\) 更小的分辨率。\(p\) 值描述原假设下统计量的极端程度,不代替 observed_difference 所表示的效应大小。
11.5 重采样单位与方法选择
重采样方法必须模仿原始数据的生成或分配机制。若独立观测单位是家庭,就重采样家庭整行;若一个人有多期记录,应按人重采样整个观测簇;时间序列通常需要保留局部依赖的分块 Bootstrap;分层随机试验则应在层内置换处理标签。忽略这些结构,往往会产生过窄的区间或错误的检验水平。
选择方法时可以依次追问:
- 目标是估计标准误和区间,还是检验某个原假设?前者通常考虑 Bootstrap 或 Jackknife,后者在交换性成立时考虑置换检验。
- 是否有可信的参数生成模型?有时参数 Bootstrap 更高效;没有时,非参数 Bootstrap 少一层模型假设。
- 统计量是否对单个观测的微小改变较平滑?若不平滑,不应仅依赖删除一个观测的 Jackknife。
- 独立单位究竟是行、家庭、企业、地区还是时间块?代码中的重采样单位必须与此一致。
- 是否检查了有限 \(B\) 的稳定性?重采样标准误、区间端点和置换 \(p\) 值都带有计算误差。
11.6 重采样结果如何报告
一个可复现的重采样分析至少应说明:原始样本及独立观测单位、目标统计量、重采样机制、重复次数与随机种子、区间或检验的具体构造方式,以及有限 \(B\) 的稳定性。参数 Bootstrap 还要给出拟合模型和每次重新估计的步骤;置换检验要写明原假设、交换范围、单侧或双侧准则和最小可报告 \(p\) 值。
重采样输出应与问题尺度一致。仅报告“Bootstrap 做了 1000 次”并不能说明区间有效;仅报告置换\(p<0.05\) 也遗漏了效应方向、大小和计算分辨率。模型诊断、异常值检查与研究设计信息仍然不可替代。
11.7 本章小结
非参数 Bootstrap 用经验分布替代未知总体分布,通过有放回抽样近似统计量的抽样分布。Bootstrap标准误反映原始数据的统计不确定性,而有限 \(B\) 又为这一估计带来额外的 Monte Carlo 误差。正态、百分位数与基本区间在近似对称问题中可能接近,但偏斜、边界、不光滑统计量和小样本都需要额外检查。
参数 Bootstrap 从拟合模型生成样本并完整重做估计,其效率和可靠性取决于模型设定;Jackknife 通过留一结果估计光滑统计量的偏差和标准误,并可构造影响诊断;置换检验则在原假设允许的标签重排下构造零分布。所有重采样方法都必须尊重真正的独立单位、聚类或时间依赖及随机分配机制。计算次数再多,也不能修复错误的重采样设计或模型假设。
11.8 思考题
- Bootstrap 分布为什么要写成给定原始样本的条件分布?它与第 10 章从已知模型重复生成新数据所研究的抽样分布有什么联系和区别?
- 在消费收入比例子中,为什么必须同时重采样同一家庭的收入和消费?分别重采样两列保留了哪些边际信息,又破坏了哪项决定比率标准误的信息?
- 原始样本量 \(n\) 与重采样次数 \(B\) 分别控制哪一层误差?为什么把 \(B\) 从 1000 增加到一百万不会使一个只有 20 个家庭的调查拥有更多总体信息?
- 百分位数区间与基本区间怎样使用同一组 Bootstrap 分位数?若统计量分布明显右偏,二者为何不再关于原估计量给出相同方向的区间?
- 参数 Bootstrap 为什么必须在每个模拟样本上重新估计参数?若 Poisson 数据实际存在过度离散,非常大的 \(B\) 会使参数 Bootstrap 的标准误趋于哪个对象,而不是哪个对象?
- 为什么 Jackknife 对样本均值和光滑比率通常有效,却可能不适合最大值或某些样本分位数?大伪值能证明原观测错误吗?
- 两组均值相等是否足以保证原始观测值可以任意置换?说明“同分布原假设”“均值相等原假设”和“随机试验的无个体处理效应原假设”对交换性的要求有何不同。
- 若 \(K\) 表示 \(B\) 次随机置换中至少与观测统计量同样极端的次数,为什么随机置换检验使用\((K+1)/(B+1)\) 而不是 \(K/B\)?若 \(B=999\) 且没有一次随机置换比观测统计量更极端,可以报告 \(p=0\)、\(p<0.001\),还是 \(p=0.001\)?
11.9 上机实验(Lab)
每份实验报告至少应说明原始独立单位、目标统计量、重采样机制、随机种子和重复次数,并报告估计值、标准误或 \(p\) 值以及有限 \(B\) 的稳定性。区间实验应通过外层重复抽样评价覆盖率,而不能只比较某一份数据得到的区间宽度;检验实验应同时报告第一类错误率或功效的 Monte Carlo 标准误。
Lab 1:成对重采样与错误重采样。 复现消费收入比例子,比较三种方案:按家庭整行重采样、分别重采样收入与消费、只重采样消费。报告三种方案保留的相关系数、Bootstrap 标准误和区间,并解释后两种方案各自隐含了什么错误的数据生成机制。
Lab 2:Bootstrap 区间覆盖率。 从已知对数正态分布反复生成样本,对总体均值和中位数分别构造正态、百分位数与基本 Bootstrap 区间。改变 \(n\) 和 \(B\),比较区间覆盖率、平均长度和覆盖率的 MonteCarlo 标准误,说明偏斜与样本量如何影响三种区间。
Lab 3:有限 \(B\) 的稳定性。 固定同一份数据,令 \(B\in\{200,1000,5000,20000\}\),并对每个 \(B\)使用至少 30 个独立随机种子。分别研究 Bootstrap 标准误、2.5% 与 97.5% 分位数端点的运行间标准差,判断哪类输出需要更多重复次数。
Lab 4:参数模型误设。 分别用 Poisson 和负二项分布生成计数数据,但始终实施 Poisson 参数Bootstrap。比较模型公式、参数 Bootstrap 和非参数 Bootstrap 对零概率或样本均值标准误的估计,并用外层模拟评价区间覆盖率。解释过度离散如何反映在结果中。
Lab 5:Jackknife 的光滑性与影响诊断。 对同一份右偏收入数据的均值、消费收入比、中位数和最大值,计算 Jackknife 偏差、标准误和伪值,并与非参数 Bootstrap 比较。画出伪值或留一变化,说明哪些差异来自统计量不光滑,哪些来自有影响力的观测。
拓展 Lab:置换检验的校准与设计。 在无处理效应和有处理效应两种情形下重复模拟就业培训实验,记录\(p\) 值分布、显著性水平 0.05 下的拒绝率及其 Monte Carlo 标准误。再加入两个随机化区组,比较全局置换与区组内置换;说明哪种置换与实际分配机制一致。