第 8 章 EM 算法与隐变量模型
前几章已经介绍了求根、数值优化与数值积分。本章讨论一种把这些工具组织起来的算法:当模型含有未观测的类别、被删失的数值或其他隐变量时,EM(Expectation–Maximization)算法通过交替计算条件期望和更新参数,将一个难以直接处理的观测数据似然转化为一系列较简单的优化问题。
本章的目标是使读者能够:
- 区分观测数据似然与完整数据似然;
- 写出 EM 的 E 步、M 步及其收敛判据;
- 用 Jensen 不等式解释观测数据对数似然为何不会下降;
- 在对数尺度上实现两成分高斯混合模型;
- 用多初始值、退化检查和直接优化校验 EM 结果;
- 用 EM 处理上限编码数据,并说明模型假设对结论的限制。
8.1 EM 算法的基本原理
8.1.1 观测数据与完整数据
设观测数据向量为 \(\mathbf y\),未观测的隐变量或缺失部分为 \(\mathbf z\),模型参数向量为\(\boldsymbol\theta\)。如果 \(\mathbf z\) 也能被观测到,完整数据似然为
\[ L_{\mathrm{c}}(\boldsymbol\theta)=p(\mathbf y,\mathbf z\mid\boldsymbol\theta), \]
相应的完整数据对数似然为
\[ \ell_{\mathrm{c}}(\boldsymbol\theta)=\log p(\mathbf y,\mathbf z\mid\boldsymbol\theta). \]
现实中只能看到 \(\mathbf y\),所以应当极大化观测数据似然
\[ L(\boldsymbol\theta)=p(\mathbf y\mid\boldsymbol\theta) =\sum_{\mathbf z}p(\mathbf y,\mathbf z\mid\boldsymbol\theta), \]
其中连续的 \(\mathbf z\) 要把求和换成积分。观测数据对数似然因此为
\[ \ell(\boldsymbol\theta) =\log\left\{\sum_{\mathbf z}p(\mathbf y,\mathbf z\mid\boldsymbol\theta)\right\}. \]
困难来自“先消去隐变量,再取对数”。对数包住求和或积分后,原本在完整数据下可以分解的结构通常不再容易直接优化。以两类混合模型为例,令 \(\boldsymbol\theta_k\) 表示第 \(k\) 个成分的参数子向量,完整参数向量 \(\boldsymbol\theta\) 还包括混合比例;单个观测的密度是
\[ p(y_i\mid\boldsymbol\theta) =\pi_1 f_1(y_i\mid\boldsymbol\theta_1)+\pi_2 f_2(y_i\mid\boldsymbol\theta_2), \]
观测数据对数似然包含
\[ \sum_{i=1}^n \log\{\pi_1 f_1(y_i\mid\boldsymbol\theta_1)+\pi_2 f_2(y_i\mid\boldsymbol\theta_2)\}. \]
若每个观测所属的类别已知,括号内的加法就会消失,参数更新往往有解析形式。EM 的基本思想是:不把未知类别武断地填成某一个类别,而是在当前参数下用各类别的条件概率作为“软权重”。
8.1.2 E 步与 M 步
设当前参数为 \(\boldsymbol\theta^{(t)}\),并定义隐变量的当前条件分布
\[ q_t(\mathbf z)=p(\mathbf z\mid\mathbf y,\boldsymbol\theta^{(t)}). \]
在第 \(t\) 次迭代中,\(\boldsymbol\theta^{(t)}\) 已经给定;\(q_t(\mathbf z)\) 用于计算隐变量的条件期望。本章中的 EM 仍是极大似然算法,其结果是参数的点估计。
EM 使用的辅助函数为
\[ Q(\boldsymbol\theta\mid\boldsymbol\theta^{(t)}) =\operatorname{E}_{q_t}\{\log p(\mathbf y,\mathbf z\mid\boldsymbol\theta)\}. \]
它是完整数据对数似然关于未观测部分的条件期望。
EM 算法
- 选择初始值 \(\boldsymbol\theta^{(0)}\)。
- E 步:在固定的 \(\boldsymbol\theta^{(t)}\) 下求 \(q_t(\mathbf z)\),并构造
\[ Q(\boldsymbol\theta\mid\boldsymbol\theta^{(t)}) =\operatorname{E}_{q_t}\{\log p(\mathbf y,\mathbf z\mid\boldsymbol\theta)\}. \]
- M 步:更新
\[ \boldsymbol\theta^{(t+1)} =\arg\max_{\boldsymbol\theta} Q(\boldsymbol\theta\mid\boldsymbol\theta^{(t)}). \]
- 计算观测数据对数似然。若相对变化足够小则停止,否则返回 E 步。
有时 M 步的精确极大值仍然难求。只要新参数能使 \(Q\) 增加,而不要求一步达到其极大值,所得方法称为广义 EM(generalized EM)。
8.1.3 对数似然的单调性
对任意隐变量分布 \(q(\mathbf z)\),定义
\[ \mathcal F(q,\boldsymbol\theta) =\sum_{\mathbf z}q(\mathbf z) \log\frac{p(\mathbf y,\mathbf z\mid\boldsymbol\theta)}{q(\mathbf z)}. \]
连续情形把求和换成积分。由 Jensen 不等式,
\[ \ell(\boldsymbol\theta) =\log\sum_{\mathbf z}q(\mathbf z) \frac{p(\mathbf y,\mathbf z\mid\boldsymbol\theta)}{q(\mathbf z)} \geq \mathcal F(q,\boldsymbol\theta). \]
更精确地说,二者之差是两个隐变量分布之间的 Kullback–Leibler 距离:
\[ \ell(\boldsymbol\theta) =\mathcal F(q,\boldsymbol\theta) +D_{\mathrm{KL}}\{q(\mathbf z)\,\|\, p(\mathbf z\mid\mathbf y,\boldsymbol\theta)\}. \]
当 \(q=q_t\) 时,这个距离在 \(\boldsymbol\theta=\boldsymbol\theta^{(t)}\) 处等于零,所以下界在当前参数处与真实目标相接。M 步提高这个下界,于是
\[ \ell(\boldsymbol\theta^{(t+1)}) \geq \ell(\boldsymbol\theta^{(t)}). \]
这个性质只是“不会下降”,并不意味着一定到达全局最大值,也不意味着收敛速度很快。若程序记录的对数似然明显下降,通常应先怀疑公式、更新顺序或数值稳定性,而不是把下降视为算法的正常波动。
8.2 实现与收敛判据
实现 EM 时需要单独编写观测数据对数似然。第 \(t\) 次更新后,可用相对变化
\[ r_t=\frac{|\ell(\boldsymbol\theta^{(t+1)})-\ell(\boldsymbol\theta^{(t)})|} {1+|\ell(\boldsymbol\theta^{(t)})|} \]
作为停止判据。当 \(r_t<\epsilon\) 时停止,同时设置最大迭代次数,以便识别收敛过慢的情形。计算过程应保存对数似然轨迹;如果轨迹明显下降,需检查 E 步、M 步和数值实现。
含有多个驻点的模型还需要从若干初始值运行 EM,并比较最终的观测数据对数似然。参数定义域也要在实现中明确,例如混合比例应为正且和为 1,标准差应大于零。下文在两个例子中分别说明这些处理。
8.3 两成分高斯混合模型
设随机变量 \(Y_1,\ldots,Y_n\) 的观测值 \(y_1,\ldots,y_n\) 来自两个潜在群体,模型参数向量记为\(\boldsymbol\theta=(\pi_1,\mu_1,\sigma_1,\pi_2,\mu_2,\sigma_2)^\top\):
\[ f(y_i\mid\boldsymbol\theta) =\sum_{k=1}^2\pi_k\phi(y_i;\mu_k,\sigma_k^2), \qquad \pi_1+\pi_2=1. \]
这里 \(\phi(\,\cdot\,;\mu,\sigma^2)\) 表示 \(N(\mu,\sigma^2)\) 的密度。
引入类别指标随机变量 \(Z_{ik}\)。若第 \(i\) 个观测来自第 \(k\) 个成分,则 \(Z_{ik}=1\),否则为 0;其完整数据中的实现值记为 \(z_{ik}\)。完整数据对数似然是
\[ \ell_{\mathrm{c}}(\boldsymbol\theta) =\sum_{i=1}^n\sum_{k=1}^2 z_{ik} \left\{\log\pi_k+\log\phi(y_i;\mu_k,\sigma_k^2)\right\}. \]
E 步计算责任度
\[ \tau_{ik}^{(t)} =P(Z_{ik}=1\mid Y_i=y_i,\boldsymbol\theta^{(t)}) =\frac{\pi_k^{(t)} \phi(y_i;\mu_k^{(t)},\{\sigma_k^{(t)}\}^2)} {\sum_{j=1}^2\pi_j^{(t)} \phi(y_i;\mu_j^{(t)},\{\sigma_j^{(t)}\}^2)}. \]
令 \(n_k^{(t)}=\sum_{i=1}^n\tau_{ik}^{(t)}\),M 步有闭式更新(\(k=1,2\)):
\[ \pi_k^{(t+1)}=\frac{n_k^{(t)}}{n}, \qquad \mu_k^{(t+1)} =\frac{\sum_{i=1}^n\tau_{ik}^{(t)}y_i}{n_k^{(t)}}, \]
\[ \{\sigma_k^{(t+1)}\}^2 =\frac{\sum_{i=1}^n\tau_{ik}^{(t)}(y_i-\mu_k^{(t+1)})^2}{n_k^{(t)}}. \]
8.3.1 数值稳定的 E 步
若直接计算密度再相除,远离均值的观测可能使两个密度同时下溢为零,责任度就会成为 0/0。稳定实现先计算
\[ a_{ik}^{(t)}=\log\pi_k^{(t)}+ \log\phi(y_i;\mu_k^{(t)},\{\sigma_k^{(t)}\}^2), \]
再利用 log-sum-exp 公式
\[ \log\sum_{k=1}^2 e^{a_{ik}^{(t)}} =m_i^{(t)}+\log\sum_{k=1}^2 e^{a_{ik}^{(t)}-m_i^{(t)}}, \qquad m_i^{(t)}=\max_{k=1,2}a_{ik}^{(t)}. \]
row_log_sum_exp <- function(log_values) {
  row_max <- apply(log_values, 1, max)
  row_max + log(rowSums(exp(log_values - row_max)))
}

normal_mixture_log_components <- function(y, weight, component_mean,
                                          component_sd) {
  out <- matrix(NA_real_, nrow = length(y), ncol = 2)
  for (k in seq_len(2)) {
    out[, k] <- log(weight[k]) +
      dnorm(y, component_mean[k], component_sd[k], log = TRUE)
  }
  out
}

normal_mixture_loglik <- function(y, weight, component_mean, component_sd) {
  log_components <- normal_mixture_log_components(
    y, weight, component_mean, component_sd
  )
  sum(row_log_sum_exp(log_components))
}

em_normal_mixture2 <- function(y, mean_start, tol = 1e-9,
                               max_iter = 500,
                               minimum_scale = 1e-3) {
  if (length(mean_start) != 2 || any(!is.finite(c(y, mean_start)))) {
    stop("y 必须有限,mean_start 必须包含两个有限数。")
  }
  data_scale <- stats::sd(y)
  if (length(y) < 3 || !is.finite(data_scale) || data_scale <= 0) {
    stop("数据必须至少有三个观测并且具有正的标准差。")
  }

  n <- length(y)
  sigma_floor <- minimum_scale * data_scale
  weight <- c(0.5, 0.5)
  component_mean <- sort(mean_start)
  component_sd <- rep(data_scale, 2)
  loglik <- normal_mixture_loglik(
    y, weight, component_mean, component_sd
  )
  trace <- data.frame(
    iter = 0L, loglik = loglik, relative_change = NA_real_
  )
  converged <- FALSE

  for (iter in seq_len(max_iter)) {
    log_components <- normal_mixture_log_components(
      y, weight, component_mean, component_sd
    )
    log_total <- row_log_sum_exp(log_components)
    tau <- exp(log_components - log_total)

    effective_n <- colSums(tau)
    if (any(!is.finite(effective_n)) || any(effective_n < 1e-8)) {
      stop("某个成分的有效样本量接近零,请更换初始值。")
    }

    weight_new <- effective_n / n
    mean_new <- colSums(sweep(tau, 1, y, `*`)) / effective_n
    variance_new <- vapply(seq_len(2), function(k) {
      sum(tau[, k] * (y - mean_new[k])^2) / effective_n[k]
    }, numeric(1))
    sd_new <- pmax(sqrt(pmax(variance_new, 0)), sigma_floor)

    loglik_new <- normal_mixture_loglik(
      y, weight_new, mean_new, sd_new
    )
    change <- loglik_new - loglik
    relative_change <- abs(change) / (1 + abs(loglik))
    decrease_tolerance <- 1e-10 * (1 + abs(loglik))
    if (!is.finite(loglik_new) || change < -decrease_tolerance) {
      stop("观测数据对数似然下降,请检查数值计算。")
    }

    weight <- weight_new
    component_mean <- mean_new
    component_sd <- sd_new
    loglik <- loglik_new
    trace <- rbind(
      trace,
      data.frame(
        iter = iter, loglik = loglik,
        relative_change = relative_change
      )
    )

    if (relative_change < tol) {
      converged <- TRUE
      break
    }
  }

  log_components <- normal_mixture_log_components(
    y, weight, component_mean, component_sd
  )
  tau <- exp(log_components - row_log_sum_exp(log_components))
  ord <- order(component_mean)

  list(
    weight = weight[ord],
    mean = component_mean[ord],
    sd = component_sd[ord],
    tau = tau[, ord, drop = FALSE],
    trace = trace,
    log_likelihood = loglik,
    converged = converged,
    sigma_floor = sigma_floor,
    hit_floor = any(component_sd <= sigma_floor * (1 + 1e-8))
  )
}
8.3.2 初始值与收敛结果
下面生成一组模拟的对数收入数据。生成机制只用于检查程序能否恢复已知结构,不代表真实调查中一定存在两个天然的收入群体。
set.seed(2026)
mix_n <- 600
mix_group <- rbinom(mix_n, size = 1, prob = 0.35) + 1
mix_y <- ifelse(
  mix_group == 1,
  rnorm(mix_n, mean = 1.7, sd = 0.25),
  rnorm(mix_n, mean = 2.4, sd = 0.35)
)

mix_starts <- list(
  `分位数 20%-80%` = as.numeric(quantile(mix_y, c(0.20, 0.80))),
  `分位数 10%-90%` = as.numeric(quantile(mix_y, c(0.10, 0.90))),
  `均值正负半个标准差` = mean(mix_y) + c(-0.5, 0.5) * sd(mix_y),
  `分位数 35%-65%` = as.numeric(quantile(mix_y, c(0.35, 0.65)))
)

mix_fits <- lapply(
  mix_starts,
  function(s) em_normal_mixture2(mix_y, mean_start = s)
)

mix_run_summary <- data.frame(
  initial_value = names(mix_fits),
  converged = vapply(mix_fits, `[[`, logical(1), "converged"),
  iterations = vapply(
    mix_fits, function(fit) max(fit$trace$iter), integer(1)
  ),
  log_likelihood = vapply(
    mix_fits, `[[`, numeric(1), "log_likelihood"
  )
)
各组初始值的运行情况和最终参数估计如下。
| 初始值 | 是否收敛 | 迭代次数 | 对数似然 |
|---|---|---|---|
| 分位数 20%-80% | TRUE | 366 | -322.2 |
| 分位数 10%-90% | TRUE | 312 | -322.2 |
| 均值正负半个标准差 | TRUE | 373 | -322.2 |
| 分位数 35%-65% | TRUE | 381 | -322.2 |
| 参数 | 成分 1 真值 | 成分 1 估计 | 成分 2 真值 | 成分 2 估计 |
|---|---|---|---|---|
| 混合权重 | 0.65 | 0.670 | 0.35 | 0.330 |
| 均值 | 1.70 | 1.696 | 2.40 | 2.402 |
| 标准差 | 0.25 | 0.254 | 0.35 | 0.363 |
四组初始均值都收敛到对数似然 \(-322.234\),所需迭代次数为 312–381 次。最优解的两个均值为1.696 和 2.402,混合比例为 0.670 和 0.330,与模拟设定的 1.7、2.4 和 0.65、0.35 接近。不同初始值在本例中得到相同结果,但这不是混合模型的一般保证。
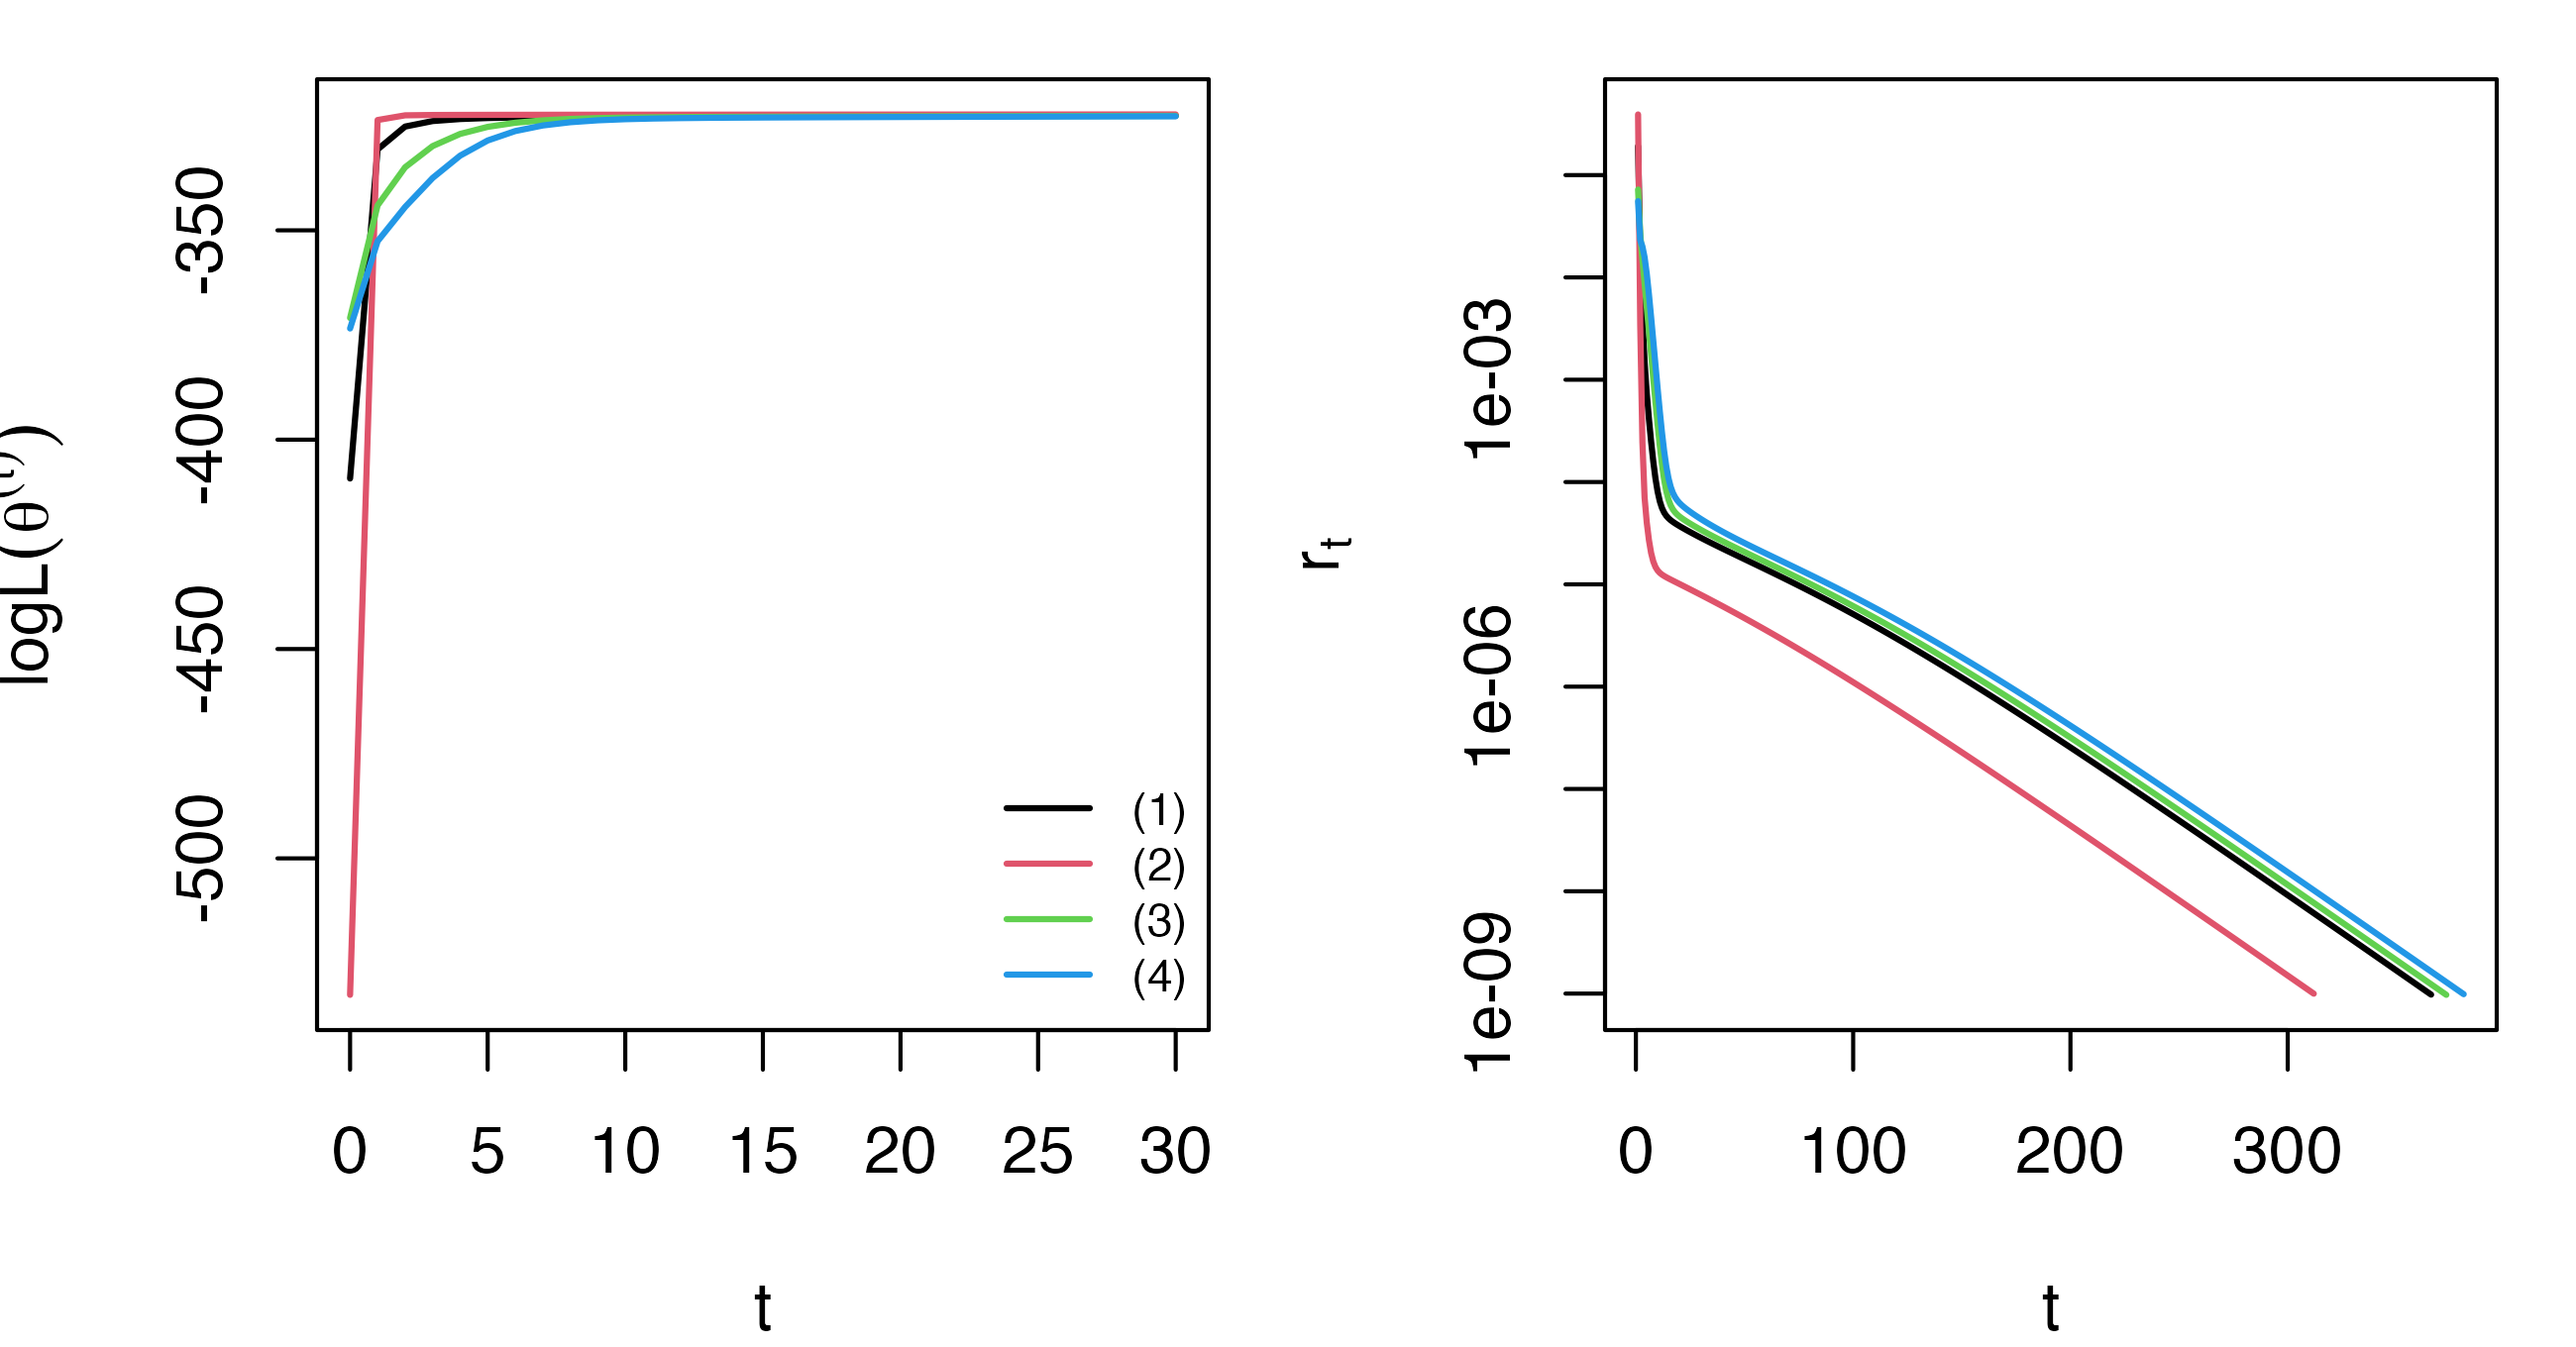
图8.1: 不同初始值下高斯混合模型的前 30 次对数似然迭代(左)和相对变化量(右)
图中的四条曲线按表中初始值的顺序编号。左图显示对数似然在最初 30 次迭代中的快速上升,右图显示相对变化量随后逐渐下降到停止阈值。责任度还可用于描述分类不确定性。
maximum_responsibility <- apply(mix_fit$tau, 1, max)
responsibility_table <- data.frame(
  quantile = c("10%", "25%", "50%", "75%", "90%"),
  maximum_responsibility = as.numeric(quantile(
    maximum_responsibility, c(0.10, 0.25, 0.50, 0.75, 0.90)
  ))
)
names(responsibility_table) <- c("分位点", "最大责任度")
knitr::kable(
  responsibility_table, digits = 3, row.names = FALSE,
  caption = "最大责任度的分位数", position = "H"
)| 分位点 | 最大责任度 |
|---|---|
| 10% | 0.704 |
| 25% | 0.859 |
| 50% | 0.950 |
| 75% | 0.982 |
| 90% | 0.995 |
本例最大责任度的中位数为 0.950,10% 分位数为 0.704,说明多数观测的软分类较明确,重叠主要出现在少数边界观测附近。这些数值只描述所设混合模型下的分类结果,不能据此断定现实中存在两个固定群体。
8.3.3 与直接极大似然估计的比较
EM 与直接优化采用不同的更新路径,但都应极大化同一个观测数据对数似然。将混合比例写成\(\pi_1=\operatorname{logit}^{-1}(\eta)\)、标准差写成 \(\sigma_k=\exp(\gamma_k)\),可用第 6 章的通用优化器进行独立校验。
normal_mixture_nll <- function(parameter, y) {
  weight <- c(plogis(parameter[1]), 1 - plogis(parameter[1]))
  component_mean <- parameter[2:3]
  component_sd <- exp(parameter[4:5])
  -normal_mixture_loglik(y, weight, component_mean, component_sd)
}

direct_mix_fits <- lapply(mix_starts, function(start_mean) {
  optim(
    par = c(0, start_mean, log(sd(mix_y)), log(sd(mix_y))),
    fn = normal_mixture_nll,
    y = mix_y,
    method = "L-BFGS-B",
    lower = c(
      qlogis(0.01), rep(min(mix_y) - 2 * sd(mix_y), 2),
      rep(log(mix_fit$sigma_floor), 2)
    ),
    upper = c(
      qlogis(0.99), rep(max(mix_y) + 2 * sd(mix_y), 2),
      rep(log(5 * sd(mix_y)), 2)
    ),
    control = list(maxit = 2000, factr = 1e7, pgtol = 1e-8)
  )
})

best_direct_run <- which.min(vapply(
  direct_mix_fits, `[[`, numeric(1), "value"
))
direct_mix_fit <- direct_mix_fits[[best_direct_run]]

comparison_mix <- data.frame(
  method = c("EM", "直接优化"),
  log_likelihood = c(
    mix_fit$log_likelihood, -direct_mix_fit$value
  ),
  convergence_code = c(
    if (mix_fit$converged) 0 else 1,
    direct_mix_fit$convergence
  )
)
stopifnot(
  direct_mix_fit$convergence == 0,
  abs(mix_fit$log_likelihood + direct_mix_fit$value) < 1e-3
)| 方法 | 对数似然 | 收敛码 |
|---|---|---|
| EM | -322.2 | 0 |
| 直接优化 | -322.2 | 0 |
EM 与直接优化得到的对数似然均为 \(-322.2341\)。若两种实现所得数值不同,需要进一步检查初始值、参数约束和似然函数的计算。
8.4 上限编码数据的 EM 估计
8.4.1 观测似然与条件矩
收入调查常把超过阈值的数值统一记录为阈值,以降低个体被识别的风险。设潜在的对数收入满足
\[ Y_i\sim N(\mu,\sigma^2), \]
但实际观察到
\[ W_i=\min(Y_i,c), \qquad D_i=\mathbb I\{Y_i>c\}, \]
其中 \(c\) 是已知的上限编码阈值,\(W_i\) 和 \(D_i\) 的观测值分别记为 \(w_i\) 和 \(d_i\),并以 \(\Phi\) 表示标准正态分布函数。未编码观测对似然贡献正态密度,上限编码观测只贡献超过阈值的概率,因此观测数据对数似然为
\[ \ell(\mu,\sigma) =\sum_{i:d_i=0}\log\phi(w_i;\mu,\sigma^2) +\sum_{i:d_i=1}\log\left\{1-\Phi\left( \frac{c-\mu}{\sigma}\right)\right\}. \]
E 步需要上限编码观测的一阶和二阶条件矩。令
\[ \alpha^{(t)}=\frac{c-\mu^{(t)}}{\sigma^{(t)}}, \qquad \lambda^{(t)} =\frac{\phi(\alpha^{(t)})}{1-\Phi(\alpha^{(t)})}, \]
则
\[ \operatorname{E}(Y_i\mid Y_i>c;\mu^{(t)},\sigma^{(t)}) =\mu^{(t)}+\sigma^{(t)}\lambda^{(t)}, \]
\[ \operatorname{E}(Y_i^2\mid Y_i>c;\mu^{(t)},\sigma^{(t)}) =\{\mu^{(t)}\}^2+\{\sigma^{(t)}\}^2 +\sigma^{(t)}\{\mu^{(t)}+c\}\lambda^{(t)}. \]
8.4.2 EM 的数值实现
当 \(\alpha\) 较大时,直接计算 \(\phi(\alpha)/\{1-\Phi(\alpha)\}\) 可能出现下溢。下面在对数尺度上计算这个比值,并同时记录观测数据对数似然。
inverse_mills_upper <- function(alpha) {
  exp(
    dnorm(alpha, log = TRUE) -
      pnorm(alpha, lower.tail = FALSE, log.p = TRUE)
  )
}

topcoded_normal_loglik <- function(mu, sigma, observed,
                                   is_topcoded, cutoff) {
  if (!is.finite(sigma) || sigma <= 0) return(-Inf)
  uncoded <- !is_topcoded
  sum(dnorm(observed[uncoded], mu, sigma, log = TRUE)) +
    sum(is_topcoded) * pnorm(
      cutoff, mu, sigma, lower.tail = FALSE, log.p = TRUE
    )
}

em_topcoded_normal <- function(observed, is_topcoded, cutoff,
                               tol = 1e-10, max_iter = 1000,
                               minimum_scale = 1e-6) {
  if (length(observed) != length(is_topcoded) ||
      any(!is.finite(observed)) || !is.finite(cutoff)) {
    stop("观测值、编码指示变量和阈值不符合要求。")
  }
  if (!any(is_topcoded) || !any(!is_topcoded)) {
    stop("示例需要同时包含未编码和上限编码观测。")
  }

  n <- length(observed)
  data_scale <- stats::sd(observed)
  if (!is.finite(data_scale) || data_scale <= 0) {
    stop("观测数据必须具有正的标准差。")
  }
  sigma_floor <- minimum_scale * data_scale
  mu <- mean(observed)
  sigma <- max(data_scale, sigma_floor)
  loglik <- topcoded_normal_loglik(
    mu, sigma, observed, is_topcoded, cutoff
  )
  trace <- data.frame(
    iter = 0L, mu = mu, sigma = sigma, loglik = loglik,
    relative_change = NA_real_
  )
  converged <- FALSE

  for (iter in seq_len(max_iter)) {
    alpha <- (cutoff - mu) / sigma
    inverse_mills <- inverse_mills_upper(alpha)
    expected_y_top <- mu + sigma * inverse_mills
    expected_y2_top <- mu^2 + sigma^2 +
      sigma * (mu + cutoff) * inverse_mills

    first_moment <- sum(observed[!is_topcoded]) +
      sum(is_topcoded) * expected_y_top
    second_moment <- sum(observed[!is_topcoded]^2) +
      sum(is_topcoded) * expected_y2_top
    mu_new <- first_moment / n
    variance_new <- second_moment / n - mu_new^2
    sigma_new <- max(sqrt(max(variance_new, 0)), sigma_floor)

    loglik_new <- topcoded_normal_loglik(
      mu_new, sigma_new, observed, is_topcoded, cutoff
    )
    change <- loglik_new - loglik
    relative_change <- abs(change) / (1 + abs(loglik))
    decrease_tolerance <- 1e-10 * (1 + abs(loglik))
    if (!is.finite(loglik_new) || change < -decrease_tolerance) {
      stop("观测数据对数似然下降,请检查截断矩公式。")
    }

    mu <- mu_new
    sigma <- sigma_new
    loglik <- loglik_new
    trace <- rbind(trace, data.frame(
      iter = iter, mu = mu, sigma = sigma, loglik = loglik,
      relative_change = relative_change
    ))
    if (relative_change < tol) { converged <- TRUE; break }
  }

  list(
    mu = mu, sigma = sigma, log_likelihood = loglik,
    trace = trace, converged = converged, sigma_floor = sigma_floor,
    hit_floor = sigma <= sigma_floor * (1 + 1e-8)
  )
}
8.4.3 估计结果的比较
下面模拟数据,并把 EM 与四项参照放在一起:生成参数、未编码完整样本的估计、把阈值误当成精确数值的朴素估计,以及直接极大化观测似然的估计。完整样本在真实应用中不可见,这里只用于模拟校验。
这些参照回答的问题并不相同。完整样本的估计反映有限样本波动,朴素估计显示忽略编码机制的影响,直接优化则用于核对 EM 是否到达同一观测似然值。真实数据没有未编码的完整样本,因此前两项比较中的“生成参数”和“完整样本估计”只适用于模拟研究。
set.seed(2028)
income_n <- 800
generating_mu <- 2.1
generating_sigma <- 0.45
top_code <- 2.4
log_income_full <- rnorm(
  income_n, mean = generating_mu, sd = generating_sigma
)
is_topcoded <- log_income_full > top_code
log_income_observed <- pmin(log_income_full, top_code)

top_em_fit <- em_topcoded_normal(
  log_income_observed, is_topcoded, top_code
)

topcoded_nll <- function(parameter, observed, is_topcoded, cutoff) {
  -topcoded_normal_loglik(
    parameter[1], exp(parameter[2]),
    observed, is_topcoded, cutoff
  )
}

top_direct_fit <- optim(
  par = c(mean(log_income_observed), log(sd(log_income_observed))),
  fn = topcoded_nll,
  observed = log_income_observed,
  is_topcoded = is_topcoded,
  cutoff = top_code,
  method = "L-BFGS-B",
  lower = c(-Inf, log(top_em_fit$sigma_floor)),
  upper = c(Inf, log(5 * sd(log_income_observed))),
  control = list(maxit = 2000, factr = 1e7, pgtol = 1e-10)
)

mle_mean_sd <- function(x) {
  x_mean <- mean(x)
  c(mu = x_mean, sigma = sqrt(mean((x - x_mean)^2)))
}| 方法 | 均值 | 标准差 |
|---|---|---|
| 生成参数 | 2.100 | 0.4500 |
| 完整模拟样本 | 2.110 | 0.4501 |
| 把阈值当作精确值 | 2.038 | 0.3456 |
| EM | 2.105 | 0.4391 |
| 直接优化观测似然 | 2.105 | 0.4391 |
| 指标 | 数值 |
|---|---|
| 上限编码比例 | 0.2550 |
| EM 迭代次数 | 12 |
| EM 对数似然 | -550.3421 |
| 直接优化对数似然 | -550.3421 |
样本中有 25.5% 的观测受到上限编码。把阈值当作精确值时,均值和标准差的估计分别为 2.0379 和0.3456;EM 得到 2.1047 和 0.4391,与直接优化完全一致,也接近完整模拟样本的 2.1100 和 0.4501。EM 估计的是总体参数,并没有还原每个家庭的具体收入。若潜在对数收入明显偏离正态,或编码规则还取决于其他未纳入模型的变量,即使迭代已经收敛,估计仍可能存在系统偏差。
8.5 EM 算法的适用范围
8.6 本章小结
EM 适用于完整数据结构简单、观测数据似然却因隐变量求和或积分而难以直接优化的问题。E 步在当前参数下计算隐变量的条件期望,M 步更新完整数据目标;Jensen 下界解释了观测数据对数似然为何不会下降。高斯混合案例展示了责任度、稳定的 log-sum-exp 计算、多初始值、标签交换和退化风险;上限编码案例展示了如何把“超过阈值”这一部分信息纳入估计。
实际计算还需考察初始值、对数似然轨迹和参数边界。数值收敛说明算法停止,但模型假设和估计精度仍需分别检查。
8.7 思考题
- 在 Jensen 下界的分解中,为什么选择\(q_t(\mathbf z)=p(\mathbf z\mid\mathbf y,\boldsymbol\theta^{(t)})\) 能使下界在当前参数处与观测数据对数似然相接?
- EM 保证对数似然不下降,为什么仍然需要多初始值?
- 两成分混合模型把成分编号交换后,似然为什么保持不变?按均值排序解决了统计识别问题,还是只解决了结果展示问题?
- 为什么高斯混合模型中的极小标准差可能产生退化解?简单设置标准差下限会带来什么新问题?
- 在完全随机缺失的一元正态例子中,为什么增加缺失记录的数量不会提高均值估计的信息量?
- 上限编码比例越高,估计为何越依赖正态分布假设?
8.8 上机实验(Lab)
- Lab 1:均值分离程度与收敛行为。 逐步缩小混合模型两个生成均值之差,比较参数误差、最大责任度分位数和迭代次数。
- Lab 2:对数尺度 E 步的数值稳定性。 将
em_normal_mixture2()中的对数尺度 E 步改成先计算普通密度,再构造一组极端观测,观察何时出现非有限责任度。 - Lab 3:多初始值与多组解。 随机生成至少 30 组初始均值,比较最终对数似然并检查是否存在多组解。
- Lab 4:参数约束的敏感性。 改变标准差下限,记录最优对数似然和单点成分,讨论约束敏感性。
- Lab 5:上限编码数据的估计比较。 改变上限编码阈值,比较朴素估计、EM 与直接优化,并绘制偏差与编码比例的关系。
- 拓展 Lab:模型误设下的 EM。 用偏态或重尾分布生成数据,但仍拟合正态模型;比较三类估计,区分算法误差与模型误设。
实验报告应说明数据生成过程、初始值、参数约束和停止规则,并给出参数估计、对数似然轨迹及收敛状态。使用多组初始值或直接优化作为参照时,还应比较相应结果并说明边界约束是否被触及。