第 9 章 随机数生成
第 2.7 节已经介绍了 R 的随机数函数和种子设置。本章讨论计算机怎样从可复现的伪均匀序列出发,经逆变换、函数变换或拒绝抽样得到目标分布的样本。下一章再用这些样本计算期望和概率。
随机数生成还要考虑周期、序列依赖和数值稳定性;多变量模拟还需保留模型规定的相关结构。经济统计数据通常由条件分布依次生成,因此程序应明确生成顺序,并用能够从设定推出的理论量检查结果。
学完本章后,读者应当能够:
- 解释伪随机数的状态、种子和周期,以及可复现所需的条件;
- 使用广义逆变换、Box–Muller 变换和拒绝抽样生成随机变量;
- 用矩阵分解生成具有指定协方差的正态随机向量;
- 区分从概率分布生成观测与从有限总体抽取单位;
- 编写联合数据生成函数,并依据理论概率、矩和图形检查结果。
9.1 伪随机序列与可重复性
9.1.1 状态、种子与周期
伪随机数生成器是一个确定性递推系统。记第 \(t\) 步的内部状态为 \(s_t\),则可写成
\[ s_{t+1}=T(s_t), \qquad u_t=G(s_t), \]
其中 \(T\) 更新状态,\(G\) 把状态映射为 \([0,1)\) 上的数。随机种子指定初始状态\(s_0\)。在算法和软件实现相同的条件下,同一种子会产生相同序列;种子本身并不会使一个质量较差的生成器变好。
线性同余生成器给出了最简单的例子:
\[ x_{t+1}=(a x_t+c)\bmod m, \qquad u_t=\frac{x_t}{m}. \]
状态 \(x_t\) 只能取 \(0,1,\ldots,m-1\),所以 \(u_t\) 位于有限网格\(\{0,1/m,\ldots,(m-1)/m\}\)。有限状态必然重复;从某一状态再次出现开始,后面的序列也会重复,这段长度称为周期。
lcg <- function(seed, a = 17L, c = 43L, m = 100L, n = 12L) {
  if (any(lengths(list(seed, a, c, m, n)) != 1L)) {
    stop("每个参数都必须是标量。")
  }
  parameter <- c(seed, a, c, m, n)
  if (any(!is.finite(parameter)) ||
      any(parameter != floor(parameter)) || m < 2L || n < 1L) {
    stop("seed、a、c、m 和 n 必须是合适的整数。")
  }

  state <- seed %% m
  out <- numeric(n)
  for (i in seq_len(n)) {
    state <- (a * state + c) %% m
    out[i] <- state / m
  }
  out
}

toy_lcg <- lcg(seed = 7)
toy_lcg
#>  [1] 0.62 0.97 0.92 0.07 0.62 0.97 0.92 0.07 0.62 0.97 0.92 0.07
输出从 \(0.62,0.97,0.92,0.07\) 开始,随后原样重复,周期只有 4。这组参数因此是一个反例:即使输出落在 \([0,1)\) 内,也远不能用于模拟。评价伪随机序列至少要考察单个数的分布、不同位置之间的依赖和周期长度。现代统计软件使用状态空间大得多、经过系统检验的生成器,本章不讨论其底层实现。上面的 R 函数也只适合小整数演示;模数很大时,双精度浮点数未必能精确完成整数递推。
9.1.2 R 中的随机数状态
下面把“继续生成”和“从同一种子重新生成”放在一次实验中比较。
set.seed(2026)
first_block <- runif(4)
second_block <- runif(4)

set.seed(2026)
replayed_block <- runif(4)

replay_result <- rbind(
  first = first_block,
  second = second_block,
  replay = replayed_block
)
round(replay_result, 4)
#>          [,1]   [,2]   [,3]   [,4]
#> first  0.6987 0.5565 0.1401 0.2857
#> second 0.5554 0.0251 0.4662 0.8610
#> replay 0.6987 0.5565 0.1401 0.2857
first 与 replay 相同,而 second 不同,因为第一次抽取以后,生成器状态已经向前推进。在循环的每次迭代中重设同一种子,会不断回到同一状态;独立的模拟重复通常只在整个实验开始前设一次种子。
RNGkind() 依次报告均匀随机数、正态随机数和离散抽样所用的算法。同一种子能否逐项复现,还取决于这些算法及相应的 R 实现。因此,长期保存的模拟结果除种子外,还应记录RNGkind() 和 R 版本。
9.2 逆变换法
若 \(U\sim \operatorname{Unif}(0,1)\),则任意等长子区间具有相同概率,密度在 \((0,1)\) 上恒为 1。计算机输出只是在有限精度网格上近似这一分布。第 2.7 节介绍的 d、p、q 和 r 函数分别对应密度或概率质量、分布函数、分位数和随机数;这一节说明 p 与 q 背后的变换关系。
9.2.1 概率积分变换
设连续随机变量 \(X\) 的分布函数为 \(F\)。若 \(F\) 连续,则\(F(X)\sim \operatorname{Unif}(0,1)\)。这称为概率积分变换。它把不同尺度和形状的连续变量统一映射到单位区间。下面将标准正态样本代入\(\Phi\),用直方图和经验分布函数检查变换结果。
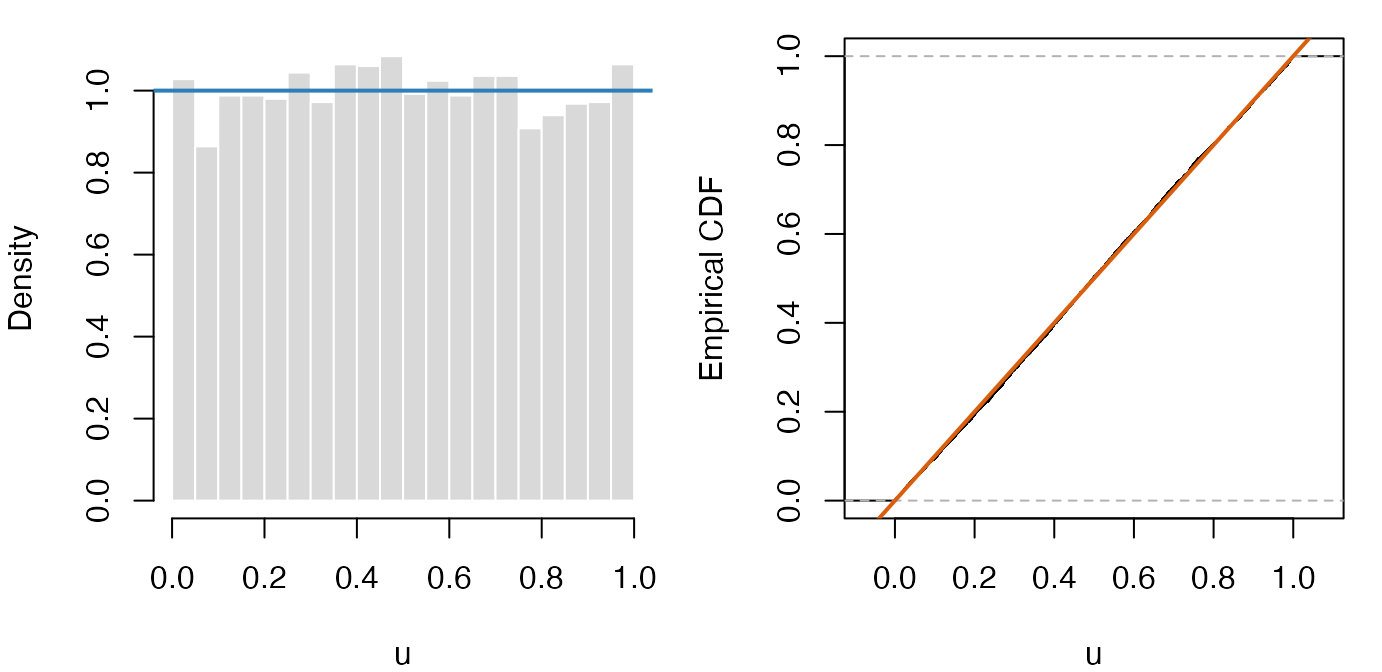
图9.1: 概率积分变换后的直方图与经验分布函数
图形接近均匀分布的理论形状,但不会与理论线完全重合,因为这里只生成了有限个随机数。单次图形检查可以发现明显错误,不能据此证明生成器在所有方面都合格。
9.2.2 连续变量的逆变换
对任意分布函数,定义广义分位数
\[ F^{-1}(u)=\inf\{x:F(x)\geq u\}, \qquad 0<u<1. \]
若 \(U\sim \operatorname{Unif}(0,1)\),则 \(X=F^{-1}(U)\) 的分布函数为 \(F\)。当 \(F\)连续且严格递增时,这就是通常的反函数。
以率参数为 \(\lambda\) 的指数分布为例,
\[ F(x)=1-\exp(-\lambda x), \qquad x\geq 0, \]
解方程得到 \(X=-\lambda^{-1}\log(1-U)\)。
当 \(U\) 很小时,直接计算 \(1-U\) 后再取对数会损失有效数字。R 函数log1p(v) 用于稳定计算 \(\log(1+v)\),因此代码写成-log1p(-u) / rate。
set.seed(2028)
rate <- 2
u_exp <- runif(10000)
x_inverse <- -log1p(-u_exp) / rate
x_builtin <- rexp(10000, rate = rate)

inverse_summary <- rbind(
  theory = c(
    mean = 1 / rate,
    sd = 1 / rate,
    q90 = -log(0.1) / rate
  ),
  inverse = c(
    mean = mean(x_inverse),
    sd = sd(x_inverse),
    q90 = unname(quantile(x_inverse, 0.9))
  ),
  built_in = c(
    mean = mean(x_builtin),
    sd = sd(x_builtin),
    q90 = unname(quantile(x_builtin, 0.9))
  )
)| 方法 | 均值 | 标准差 | 90% 分位数 |
|---|---|---|---|
| 理论值 | 0.5000 | 0.5000 | 1.151 |
| 逆变换 | 0.5050 | 0.5087 | 1.147 |
| rexp() | 0.4951 | 0.4885 | 1.146 |
两种生成方法的汇总量都接近理论值。二者使用不同的随机抽样过程,结果本来就无需逐项相同。
9.2.3 离散变量的逆变换
设离散变量依次取 \(x_1,\ldots,x_K\),概率为 \(p_1,\ldots,p_K\)。令\(P_k=\sum_{j=1}^{k}p_j\) 表示前 \(k\) 类的累积概率。
生成 \(U\sim \operatorname{Unif}(0,1)\) 后,选择第一个满足 \(U\leq P_k\) 的类别。这个规则正是广义分位数定义在阶梯型分布函数上的应用。
sample_discrete_inverse <- function(values, prob, n) {
  if (length(values) == 0L || length(values) != length(prob) ||
      any(!is.finite(prob)) || any(prob < 0) || !any(prob > 0)) {
    stop("values 与 prob 不符合离散分布的要求。")
  }
  if (length(n) != 1L || !is.finite(n) ||
      n < 1L || n != floor(n)) {
    stop("n 必须是正整数。")
  }

  scaled_prob <- prob / max(prob)
  cumulative <- cumsum(scaled_prob / sum(scaled_prob))
  cumulative[length(cumulative)] <- 1
  u <- runif(n)
  index <- vapply(
    u,
    function(ui) which(ui <= cumulative)[1L],
    integer(1)
  )
  values[index]
}

labor_levels <- c("就业", "失业", "退出劳动力市场")
labor_prob <- c(0.72, 0.08, 0.20)

set.seed(2029)
labor_draw <- sample_discrete_inverse(
  labor_levels, labor_prob, n = 10000
)| 劳动力状态 | 理论概率 | 模拟比例 | 差值 |
|---|---|---|---|
| 就业 | 0.72 | 0.7225 | 0.0025 |
| 失业 | 0.08 | 0.0784 | -0.0016 |
| 退出劳动力市场 | 0.20 | 0.1991 | -0.0009 |
实际分析可直接调用 sample();这里手写函数只是为了展示累积概率的分组规则。
9.3 正态变量的函数与矩阵变换
逆变换并非唯一途径。若容易生成的随机变量经过某个函数后具有目标分布,就可以直接使用函数变换。本节先由两个独立均匀变量生成独立标准正态变量,再利用矩阵分解加入相关结构。
9.3.1 Box–Muller 变换
若 \(U_1,U_2\) 独立且服从 \(\operatorname{Unif}(0,1)\),令
\[ R=\sqrt{-2\log U_1}, \qquad \Theta=2\pi U_2, \]
则
\[ Z_1=R\cos\Theta, \qquad Z_2=R\sin\Theta \]
是两个相互独立的标准正态变量。一次变换产生两个正态数,同时保留两者可以避免浪费一半结果。
box_muller <- function(n) {
  pair_n <- ceiling(n / 2)
  u1 <- pmax(runif(pair_n), .Machine$double.xmin)
  u2 <- runif(pair_n)
  radius <- sqrt(-2 * log(u1))
  angle <- 2 * pi * u2
  z1 <- radius * cos(angle)
  z2 <- radius * sin(angle)

  as.vector(rbind(z1, z2))[seq_len(n)]
}

set.seed(2030)
z_box <- box_muller(10000)| 方法 | 均值 | 标准差 | 2.5% 分位数 | 97.5% 分位数 |
|---|---|---|---|---|
| 理论值 | 0.0000 | 1.000 | -1.960 | 1.960 |
| Box–Muller | 0.0041 | 1.004 | -1.962 | 1.992 |
均值和标准差只检查位置与尺度;两个尾部分位数还能发现某些形状错误。更完整的检查可以使用QQ 图或把 pnorm(z_box) 再变换到均匀尺度。
9.3.2 相关正态随机向量
设 \(p\) 维随机向量 \(\mathbf Z\sim N_p(\mathbf 0,\mathbf I_p)\)。对于给定的均值向量\(\boldsymbol\mu\) 和对称正定协方差矩阵 \(\boldsymbol\Sigma\),Cholesky 分解满足
\[ \boldsymbol\Sigma=\mathbf R^\top\mathbf R. \]
令
\[ \mathbf X=\boldsymbol\mu+\mathbf R^\top\mathbf Z, \]
则 \(\operatorname{E}(\mathbf X)=\boldsymbol\mu\),\(\operatorname{Cov}(\mathbf X)=\boldsymbol\Sigma\),即\(\mathbf X\sim N_p(\boldsymbol\mu,\boldsymbol\Sigma)\)。R 的 chol() 返回上三角矩阵\(\mathbf R\);若每个标准正态向量存放在数据矩阵的一行,相应的计算是 Z %*% R。当协方差矩阵奇异、仅为半正定时,需要改用能够处理零特征值的分解方法。
set.seed(2031)
cor_n <- 5000
target_mean <- c(1, -1)
target_cov <- matrix(c(
  1.0, 0.75,
  0.75, 2.0
), nrow = 2, byrow = TRUE)

z_independent <- matrix(
  box_muller(2 * cor_n),
  ncol = 2, byrow = TRUE
)
chol_factor <- chol(target_cov)
x_correlated <- sweep(
  z_independent %*% chol_factor,
  MARGIN = 2, STATS = target_mean, FUN = "+"
)round(colMeans(x_correlated), 3)
#> [1] 1.012 -1.005
round(cov(x_correlated), 3)
#> [,1] [,2]
#> [1,] 0.984 0.738
#> [2,] 0.738 1.973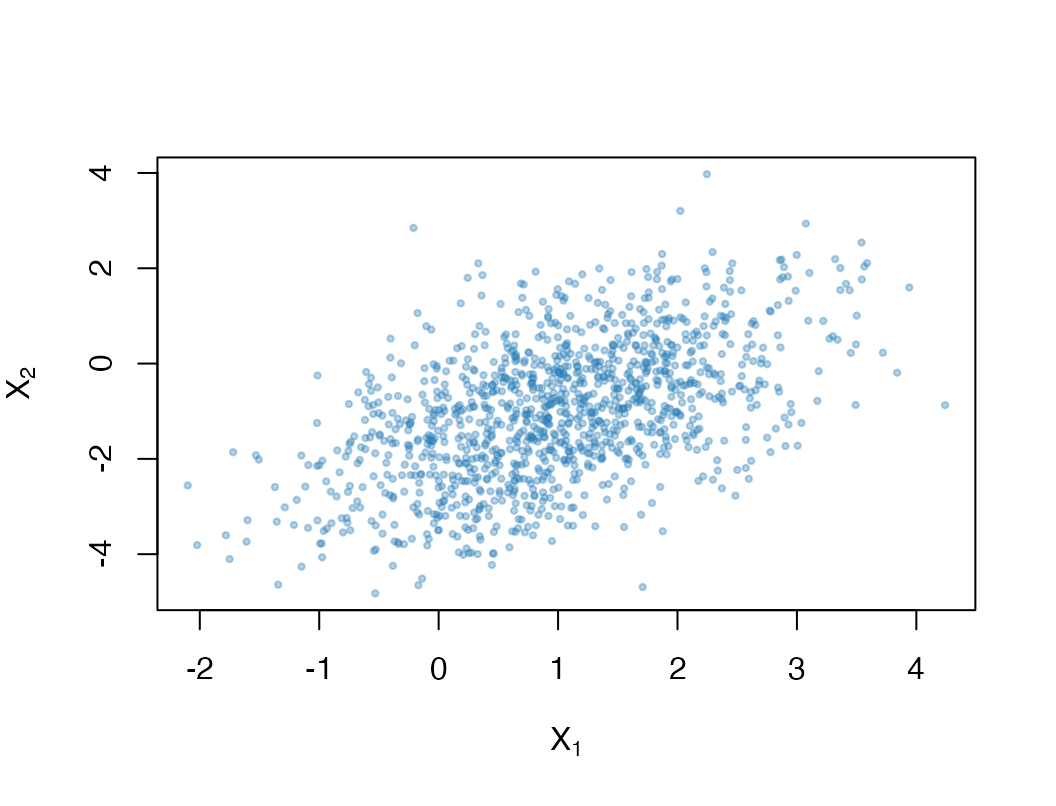
图9.2: 具有指定均值和协方差的二元正态样本
样本均值和协方差不会精确等于目标值,但样本量增加后应逐渐接近。若把矩阵乘法写成Z %*% t(R),得到的协方差一般会改变;这也是检查矩阵方向的直接办法。
9.4 拒绝抽样
9.4.1 包络条件与算法
当分位数函数难以计算时,可以选取一个容易抽样的建议密度 \(g\)。若目标密度 \(f\) 的支持集包含在 \(g\) 的支持集内,并且存在有限常数 \(M\) 使
\[ f(x)\leq M g(x) \]
对所有 \(x\) 成立,就可以从 \(g\) 生成候选值并按比例保留。
拒绝抽样
- 从 \(g\) 生成候选值 \(X^\ast\),并独立生成 \(U\sim \operatorname{Unif}(0,1)\)。
- 若 \(U\leq f(X^\ast)/\{M g(X^\ast)\}\),则接受 \(X^\ast\);否则重新生成候选值。
包络条件必须在整个支持集上成立。只在有限网格上观察到\(f(x)/\{M g(x)\}\leq 1\),不足以证明算法有效;目标分布尾部比建议分布更厚时,有限的\(M\) 甚至可能不存在。
9.4.2 正确性与接受率
候选值在 \(x\) 附近出现的密度为 \(g(x)\),条件接受概率为\(f(x)/\{M g(x)\}\),两者相乘得到
\[ g(x)\frac{f(x)}{M g(x)}=\frac{f(x)}{M}. \]
归一化后,接受值的密度就是 \(f\)。若 \(f\) 和 \(g\) 都是归一化密度,单个候选值被接受的概率为
\[ \int \frac{f(x)}{M g(x)}g(x)\,dx=\frac{1}{M}. \]
因此,较小的 \(M\) 同时意味着包络更贴近目标密度和更高的计算效率。
9.4.3 标准正态分布示例
以标准正态密度 \(\phi\) 为目标,以自由度为 3 的 \(t\) 密度为建议分布。后者尾部更厚,所以密度比在尾部趋近于 0。令
\[ h(x)=\log\frac{\phi(x)}{t_3(x)}. \]
直接求导可得
\[ h'(x)=-x+\frac{4x}{3+x^2} =\frac{x(1-x^2)}{3+x^2}. \]
驻点为 \(0\) 和 \(\pm1\);比较这些点并结合尾部极限可知,全局最大值在\(x=\pm1\)。因此可以用 \(M=\phi(1)/t_3(1)\),并加入极小的数值裕量。接受判据在对数尺度上计算,避免尾部密度同时下溢。
rejection_normal_t3 <- function(n) {
  log_ratio <- function(x) {
    dnorm(x, log = TRUE) - dt(x, df = 3, log = TRUE)
  }
  log_m <- log_ratio(1) + log1p(1e-12)

  accepted <- numeric(n)
  trials <- 0
  for (i in seq_len(n)) {
    repeat {
      trials <- trials + 1L
      candidate <- rt(1, df = 3)
      log_acceptance <- log_ratio(candidate) - log_m
      if (log(runif(1)) <= log_acceptance) {
        accepted[i] <- candidate
        break
      }
    }
  }

  list(
    sample = accepted,
    trials = trials,
    acceptance_rate = n / trials,
    m = exp(log_m)
  )
}

set.seed(2032)
rejection_fit <- rejection_normal_t3(4000)| 指标 | 理论值 | 模拟值 |
|---|---|---|
| 接受率 | 0.8544 | 0.8536 |
| 样本均值 | 0.0000 | 0.0094 |
| 样本标准差 | 1.0000 | 0.9842 |
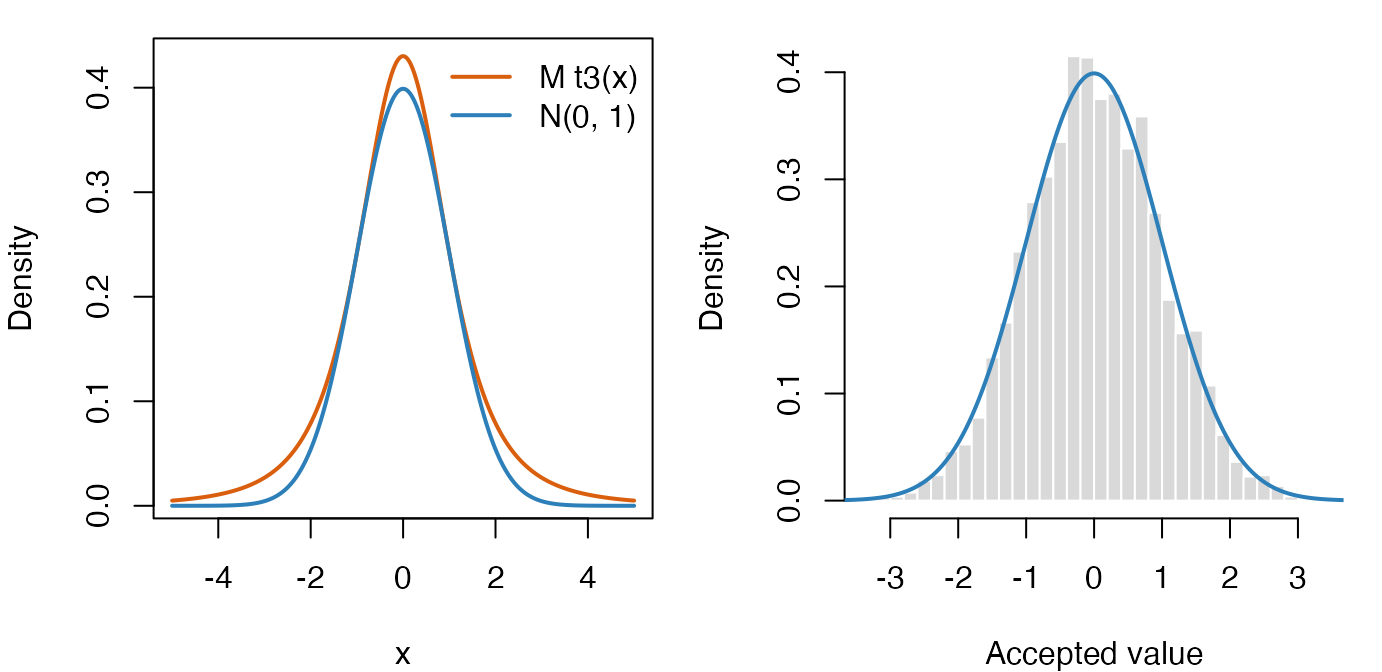
图9.3: 标准正态目标密度、t 建议包络与接受样本
经验接受率应接近 \(1/M\),接受样本的分布应接近标准正态。维数增加后,容易抽样且贴近目标的包络通常更难构造,接受率也可能迅速下降。拒绝抽样按概率丢弃候选值;第 10 章的重要性抽样则保留建议分布样本,并用权重校正 \(f\) 与 \(g\) 的差异。
常规计算直接使用 rnorm() 生成正态随机数;这里的正态–\(t_3\) 例子用于说明包络上界、接受率和对数尺度实现,并不表示 R 的正态随机数采用这段程序。
9.5 有限总体抽样
离散逆变换和 sample(..., replace = TRUE) 从概率分布生成新的随机变量。有限总体抽样处理的是一组已经存在的单位。设有限总体的实现值为 \(y_1,\ldots,y_N\),总体均值为\(\bar y_{\mathrm{U}}=N^{-1}\sum_{i=1}^N y_i\)。从单位编号中不放回抽取 \(n\) 个,才是简单随机抽样;记抽样机制下的随机样本均值为 \(\bar Y_{\mathrm{s}}\)。若
\[ S_{\mathrm{U}}^2=\frac{1}{N-1}\sum_{i=1}^{N}(y_i-\bar y_{\mathrm{U}})^2, \]
则在给定有限总体的条件下,
\[ \operatorname{Var}(\bar Y_{\mathrm{s}}\mid y_1,\ldots,y_N) =\left(1-\frac{n}{N}\right)\frac{S_{\mathrm{U}}^2}{n}. \]
因子 \(1-n/N\) 反映不放回抽样带来的有限总体修正。作为下一章重复模拟方法的预览,下面先固定一个模拟总体,再重复抽取样本,比较样本均值的经验标准差与理论值。
set.seed(2034)
population_n <- 10000
population_income <- rlnorm(
  population_n, meanlog = log(8), sdlog = 0.55
)
sample_n <- 300
repeat_n <- 5000

sample_means <- replicate(
  repeat_n,
  mean(population_income[
    sample.int(population_n, size = sample_n, replace = FALSE)
  ])
)

finite_population_se <- sqrt(
  (1 - sample_n / population_n) *
    var(population_income) / sample_n
)| 指标 | 数值 |
|---|---|
| 总体均值 | 9.1540 |
| 重复样本均值的平均 | 9.1510 |
| 样本均值的经验标准差 | 0.3076 |
| 有限总体理论标准差 | 0.3096 |
这里有两个不同的随机阶段:总体只在实验开始时生成一次,随后被视为固定;重复抽样只改变入样单位。若每次重复都重新生成总体,得到的方差还会包含总体生成过程的波动。
9.6 综合案例:家庭调查数据的生成
9.6.1 条件分布与生成顺序
考虑一组完全模拟的家庭数据,家庭年收入和年消费支出的单位均为万元。地区 \(R_i\) 取“东部”“中部”和“西部”,概率分别为 \(0.42\)、\(0.33\) 和 \(0.25\)。给定地区后,先生成对数收入
\[ L_i\mid R_i=r\sim N\bigl(\log(8)+\alpha_r,\ 0.55^2\bigr), \qquad Y_i=\exp(L_i), \]
其中 \(\alpha_r\) 依次为 \(0.18,0,-0.16\)。因此,中部家庭收入的条件中位数是 8,而不是条件均值;对数正态分布的均值还包含 \(\exp(0.55^2/2)\) 这一因子。
户主就业指标满足
\[ E_i\mid L_i,R_i\sim\operatorname{Bernoulli}(p_i), \]
\[ \operatorname{logit}(p_i) =0.4+0.7\{L_i-\log(8)\}+\delta_{R_i}, \]
地区效应 \(\delta_r\) 为 \(0.15,0,-0.15\)。最后生成正的消费支出:
\[ \log C_i =0.2+0.78L_i+0.12E_i+\gamma_{R_i}+\varepsilon_i, \qquad \varepsilon_i\sim N(0,0.30^2), \]
其中 \(\gamma_r\) 为 \(0.06,0,-0.05\)。程序按照地区、收入、就业、消费这一条件分解依次生成,每一步只使用此前已经生成的变量。不同家庭相互独立,\(\varepsilon_i\) 也独立于此前生成的变量。
9.6.2 程序实现
simulate_households <- function(n) {
  region_level <- c("东部", "中部", "西部")
  region <- sample(
    region_level, n, replace = TRUE, prob = c(0.42, 0.33, 0.25)
  )
  alpha <- c("东部" = 0.18, "中部" = 0, "西部" = -0.16)
  log_income <- rnorm(
    n, mean = log(8) + unname(alpha[region]), sd = 0.55
  )
  income <- exp(log_income)
  delta <- c("东部" = 0.15, "中部" = 0, "西部" = -0.15)
  p_employed <- plogis(
    0.4 + 0.7 * (log_income - log(8)) +
      unname(delta[region])
  )
  employed <- rbinom(n, size = 1, prob = p_employed)
  gamma <- c("东部" = 0.06, "中部" = 0, "西部" = -0.05)
  log_consumption <- 0.2 + 0.78 * log_income + 0.12 * employed +
    unname(gamma[region]) + rnorm(n, sd = 0.30)
  data.frame(
    region = factor(region, levels = region_level),
    income = income, employed = employed,
    consumption = exp(log_consumption)
  )
}
函数内部不设置种子。这样,同一随机流中连续调用函数可以得到不同样本;需要复现整个实验时,在调用函数之前设置一次种子。本例只规定总体变量的联合分布,没有模拟抽样设计,因而不包含调查权重。
9.6.3 理论量与模拟量
模型给出了地区概率和各地区对数收入的条件均值,可以直接与模拟结果比较。较大的样本使差异通常较小,但差异不会严格为零。
| 地区 | 设定概率 | 模拟比例 | 设定均值 | 模拟均值 |
|---|---|---|---|---|
| 东部 | 0.42 | 0.4244 | 2.259 | 2.261 |
| 中部 | 0.33 | 0.3304 | 2.079 | 2.073 |
| 西部 | 0.25 | 0.2452 | 1.919 | 1.931 |
stopifnot(
  all(is.finite(household_check$income)),
  all(is.finite(household_check$consumption)),
  all(household_check$income > 0),
  all(household_check$consumption > 0),
  all(household_check$employed %in% c(0, 1))
)
该表主要检查类别概率、因子索引和地区效应的实现。若地区比例偏离设定很多,需检查类别概率和因子水平;若各地区对数收入均值顺序错误,需检查命名向量的索引。正值和二元取值等支持集条件则适合写成程序断言,使错误在生成阶段就停止。
这组数据的就业比例为 0.6039,平均条件就业概率为0.6069。消费方程残差的均值为0.0018,标准差为0.3007,分别接近模型设定的 0 和 0.30。这样可以继续检查就业和消费两个条件生成步骤,而不只检查最先生成的地区与收入。
9.6.4 分布形状与变量关系
边际均值正确并不能保证联合结构正确。下面的左图比较各地区的对数收入,右图检查收入与消费在对数尺度上的关系。图中只取部分观测,以免散点过度重叠。
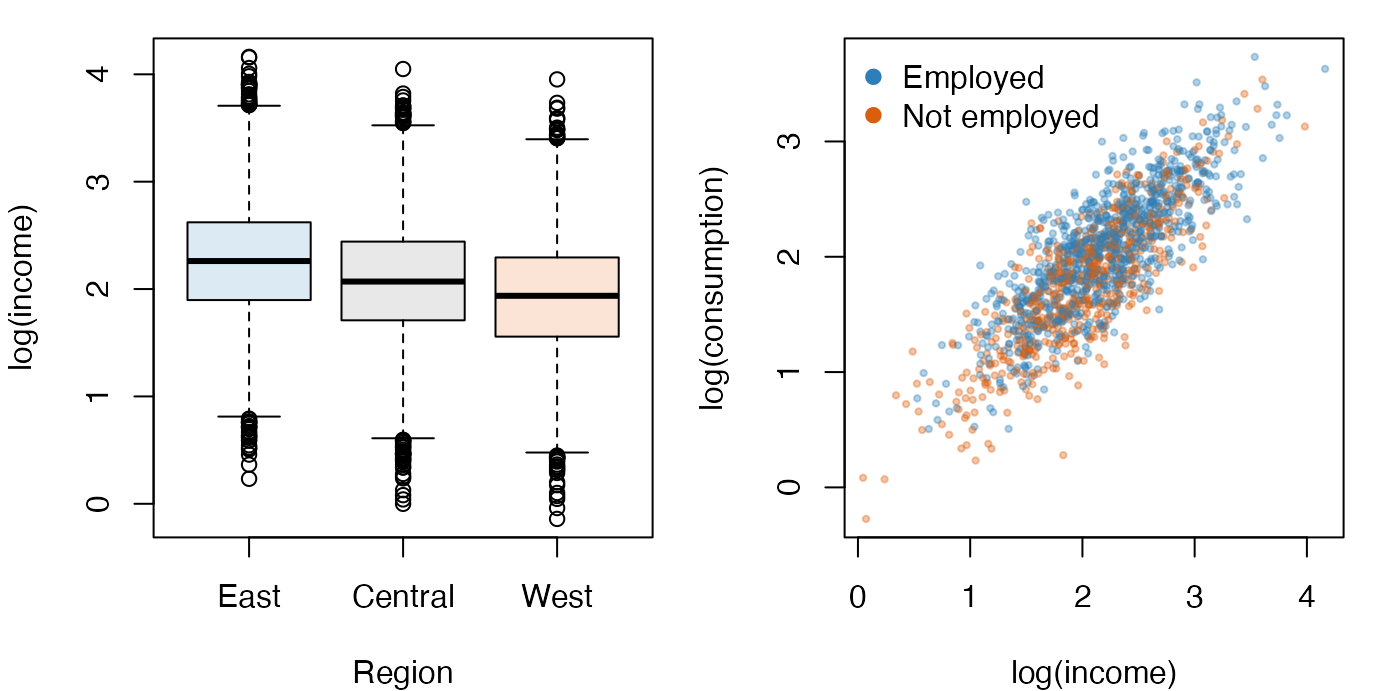
图9.4: 家庭调查模拟数据的条件分布与变量关系
图形与模型设定一致:东部收入较高,收入与消费正相关。就业状态还会造成条件位置差异。若改变参数或代码,表格和图形也应随之改变。对多个种子和样本量重复这些比较,可以进一步区分程序错误与有限模拟造成的波动;第 10 章将正式讨论这种模拟误差。
9.7 本章小结
伪随机数由有限状态的确定性算法产生。种子决定初始状态,周期和序列依赖则决定生成器能否用于统计模拟。可复现性还需要记录随机数算法和软件环境,而不只是保存一个种子。
均匀随机数可以通过广义逆变换、Box–Muller 变换和拒绝抽样转换为目标分布样本。逆变换需要稳定地计算分位数,拒绝抽样需要在整个支持集上成立的包络上界;相关正态变量还需要正确使用协方差矩阵的分解方向。分布抽样与有限总体抽样解决不同问题,后者的不放回机制会产生有限总体修正。
联合数据生成过程应先写明条件分布和生成顺序,再实现为函数。理论概率、条件矩、变量支持集和图形关系可以用来判断程序是否按设定生成数据。随机数生成与模拟方法的进一步讨论可参见Gentle (2009) 和 Robert and Casella (2004)。
9.8 思考题
- 为什么相同种子只有在随机数算法和软件实现相同的条件下才能保证得到相同序列?
- 本章的线性同余例子为什么只有 4 的周期?边际均值接近 \(1/2\) 能否弥补短周期问题?
- 广义分位数定义为什么同时适用于连续分布和离散分布?在离散情形中,累积概率边界应归入哪一类?
- Box–Muller 变换为什么一次产生两个标准正态变量?若只保留 \(Z_1\),分布是否仍然正确,计算效率又会怎样变化?
- 拒绝抽样为什么要求建议分布覆盖目标分布的整个支持集?当目标分布尾部更厚时会发生什么?
- 在标准正态–\(t_3\) 例子中,为什么经验接受率应接近 \(1/M\)?
- 从类别概率生成 100 个观测与从一个包含 100 个单位的有限总体中抽取 20 个单位,有什么区别?
- 为什么
simulate_households()不在函数内部设置随机种子?连续调用两次时会发生什么?
9.9 上机实验(Lab)
- Lab 1:线性同余生成器的周期与结构。 改变线性同余生成器的 \(a\)、\(c\) 和 \(m\),计算周期,并画出\((u_t,u_{t+1})\) 散点图。比较短周期参数和较长周期参数的图形。
- Lab 2:逆变换法生成 Weibull 样本。 推导 Weibull 分布的逆变换公式,手写生成函数,并与
rweibull()的样本均值和分位数比较。 - Lab 3:拒绝抽样的提议分布选择。 改变拒绝抽样建议分布的自由度。对每个选择重新确定覆盖全实轴的 \(M\),比较理论接受率与经验接受率。
- Lab 4:多维相关正态样本的质量。 将相关正态例子扩展到五维。分别增加样本量和协方差矩阵条件数,记录样本协方差与目标矩阵的误差。
- Lab 5:有限总体抽样的方差。 对固定有限总体改变抽样比例 \(n/N\),比较样本均值的经验标准差和有限总体理论标准差。
- 拓展 Lab:层次调查模拟的综合实验。 改变家庭调查模型中的地区效应或消费误差标准差,说明哪些理论量、表格和图形应随之变化。